Vit-base Model
Trong nhiều năm, nếu nói đến bài toán nhận dạng ảnh, gần như ta mặc định nghĩ đến CNN. Điều đó hoàn toàn dễ hiểu. Ảnh có cấu trúc lưới 2 chiều, vật thể có tính cục bộ, cạnh và texture thường xuất hiện theo vùng, nên convolution là một lựa chọn rất hợp tự nhiên. Một kernel nhỏ trượt trên ảnh, gom tín hiệu cục bộ rồi chồng nhiều lớp lên nhau để mở rộng receptive field. Cách làm đó đã đưa computer vision đi rất xa.
Nhưng khi Transformer thống trị NLP, một câu hỏi bắt đầu trở nên khó né: nếu attention đã rất mạnh trong việc học quan hệ xa gần trên chuỗi token, liệu ta có thể mang chính tư duy đó sang ảnh hay không. Vision Transformer, thường được gọi là ViT, ra đời từ đúng câu hỏi ấy. Ý tưởng của nó vừa táo bạo vừa khá gọn: đừng xử lý ảnh bằng convolution ngay từ đầu nữa, hãy cắt ảnh thành các patch, xem mỗi patch như một token, rồi đưa cả chuỗi token đó vào Transformer encoder.
Điểm đáng chú ý ở đây không chỉ là thay một khối mạng bằng một khối mạng khác. ViT đổi luôn cách ta nhìn ảnh. Thay vì nghĩ ảnh là một tín hiệu 2D mà mô hình phải quét dần từ cục bộ đến toàn cục, ViT coi ảnh là một tập các mảnh nhìn cục bộ nhưng được đặt trong cùng một không gian attention, nơi bất kỳ patch nào cũng có thể tương tác trực tiếp với bất kỳ patch nào khác.
Giới hạn của mô hình thị giác dựa trên convolution
CNN rất mạnh, nhưng sức mạnh đó đi cùng một inductive bias khá rõ. Nó giả định rằng thông tin cục bộ là nền tảng, và cấu trúc toàn cục sẽ được xây dần lên bằng cách chồng nhiều lớp. Với rất nhiều bài toán, giả định này là đúng và cực kỳ hiệu quả. Nhưng nó cũng có nghĩa là mô hình phải đi một quãng khá dài mới kết nối được hai vùng xa nhau trong ảnh.
Trong khi đó, attention cho phép hai vị trí bất kỳ trao đổi thông tin ngay ở một lớp, miễn là chúng cùng nằm trong chuỗi token đầu vào. Với những bài toán mà quan hệ toàn cục quan trọng, chẳng hạn một vùng ảnh nhỏ chỉ có ý nghĩa khi đặt trong bối cảnh tổng thể, cách nhìn đó khá hấp dẫn.
ViT không phủ nhận giá trị của local structure. Nó chỉ nói rằng ta không nhất thiết phải ép local bias vào mô hình bằng convolution ngay từ đầu. Ta có thể để mô hình học các quan hệ giữa patch với patch thông qua attention, rồi để dữ liệu quyết định dạng liên kết nào là quan trọng nhất.
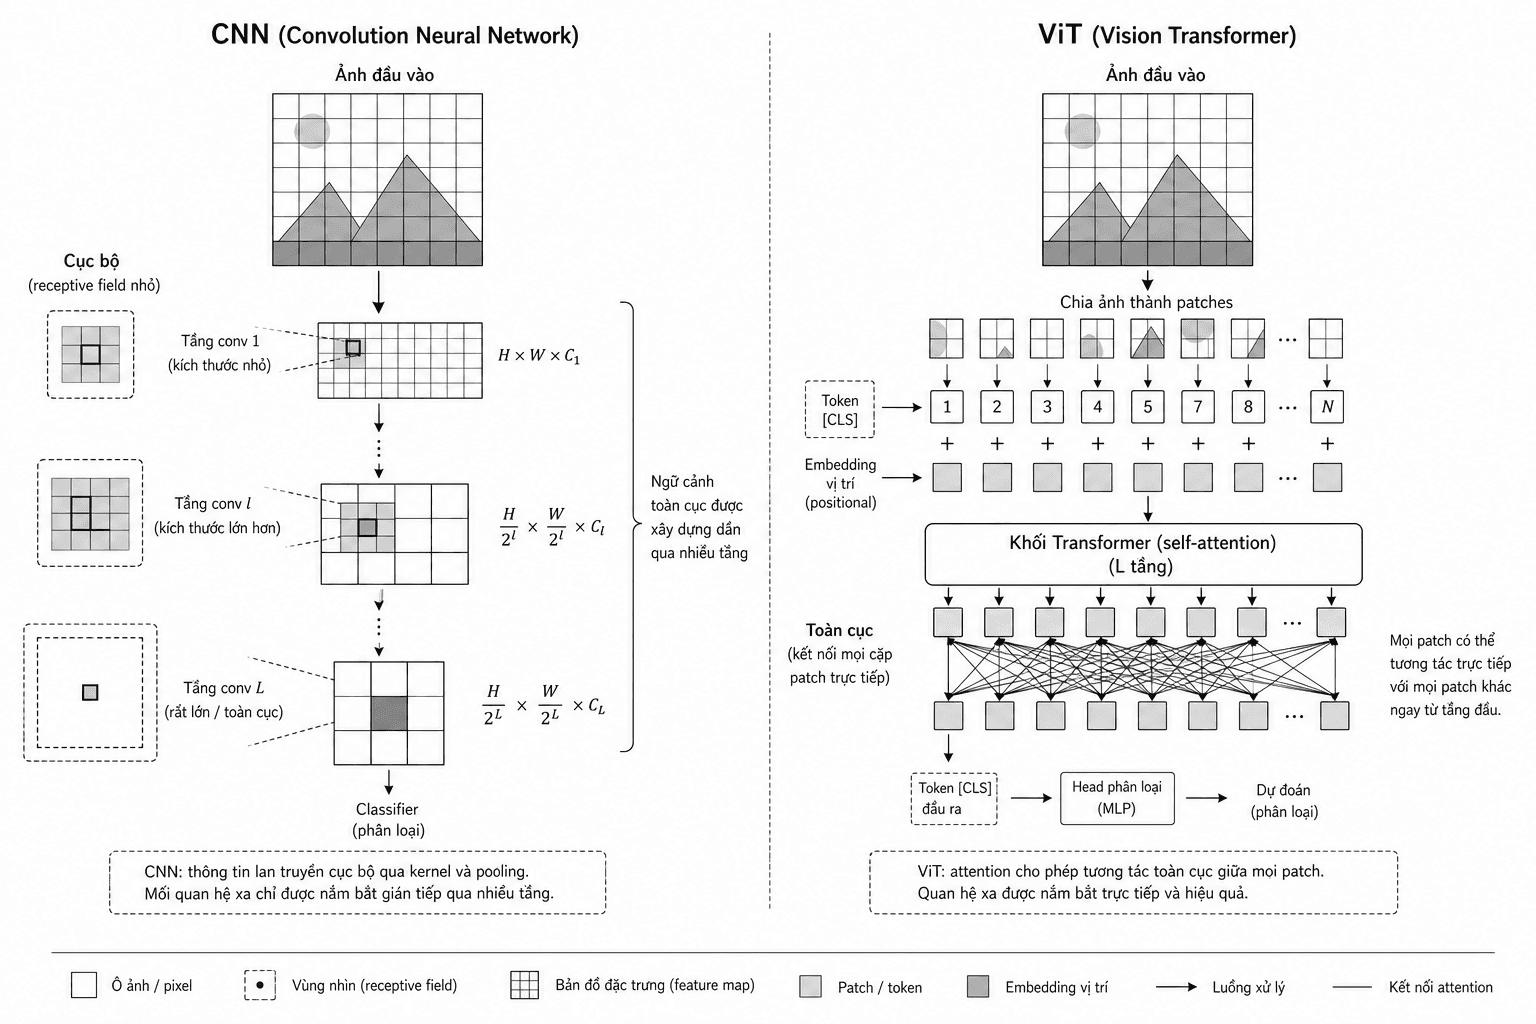
Điểm đánh đổi nằm ngay ở đây. Khi bỏ bớt inductive bias của convolution, mô hình linh hoạt hơn nhưng cũng đòi hỏi dữ liệu lớn hơn để học được những quy luật mà CNN vốn đã được "tặng sẵn" từ cấu trúc kiến trúc.
Cơ chế token hóa ảnh trong Vision Transformer
Bước đầu tiên của ViT là chia ảnh thành các patch không chồng lấp. Giả sử ảnh đầu vào có kích thước , và mỗi patch có kích thước . Khi đó, số patch là:
Trong đó:
- là chiều cao và chiều rộng của ảnh.
- là số kênh màu.
- là kích thước patch.
- là số patch sau khi chia ảnh.
Mỗi patch sau đó được trải phẳng rồi chiếu tuyến tính sang một vector có chiều . Nếu ký hiệu patch thứ là , ta có:
Trong đó:
- là patch đã được flatten.
- là ma trận chiếu tuyến tính.
- là patch embedding.
Nhìn kỹ thì đây chính là bước "token hóa" của ViT. Ở NLP, token hóa biến câu thành chuỗi token rời rạc. Ở ViT, token hóa biến ảnh thành chuỗi patch embeddings. Từ đây trở đi, Transformer không còn cần biết đầu vào ban đầu là ảnh. Nó chỉ nhìn thấy một chuỗi vector.
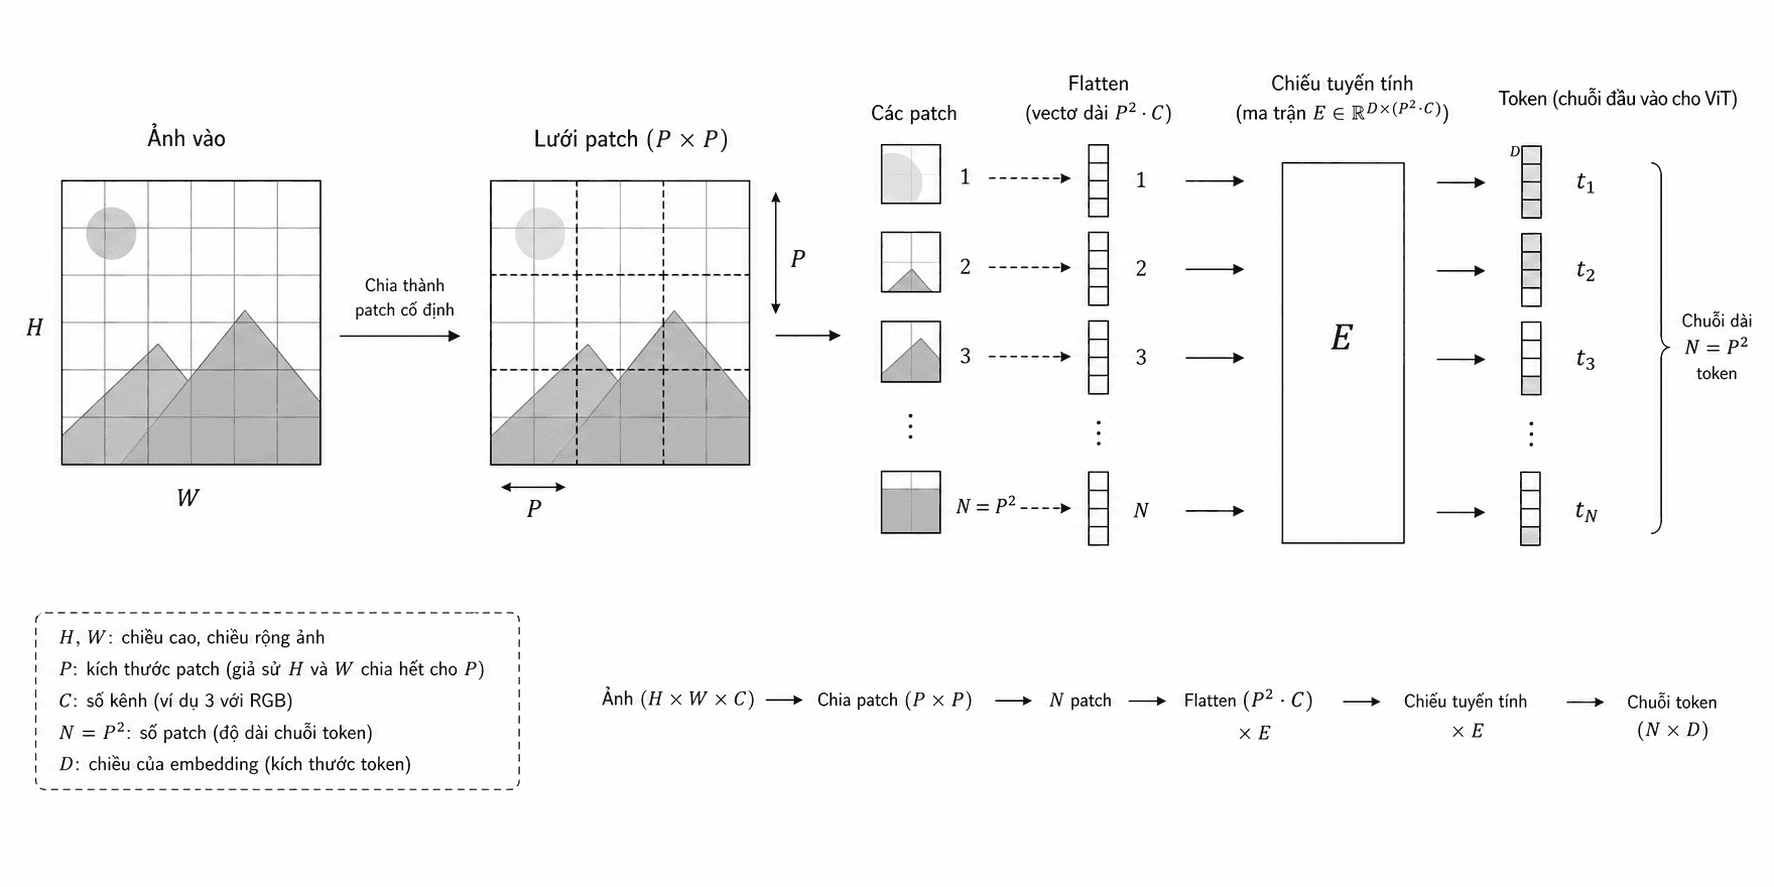
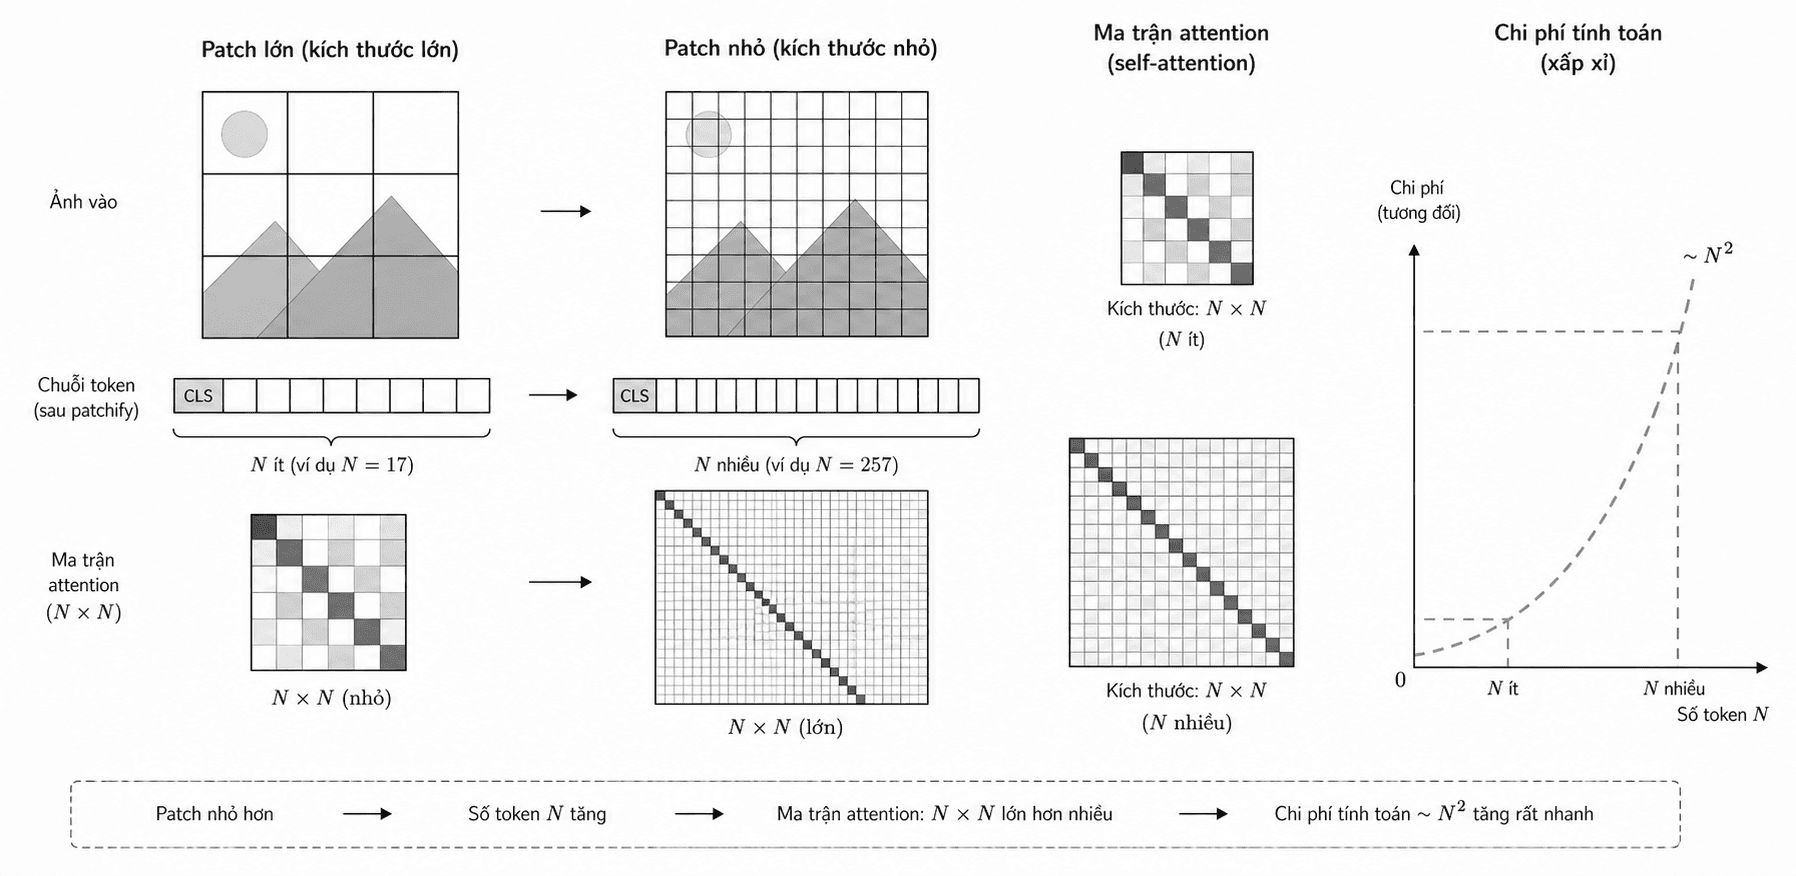
Kích thước patch ảnh hưởng rất mạnh đến mô hình. Patch nhỏ giữ được chi tiết tốt hơn, nhưng làm số token tăng lên nhanh. Patch lớn rẻ hơn về tính toán, nhưng có thể làm mất những cấu trúc mảnh hoặc biên nhỏ mà bài toán cần.
Vai trò của CLS token và mã hóa vị trí
Nếu chỉ đưa chuỗi patch embeddings vào Transformer, ta vẫn còn thiếu hai thứ. Thứ nhất là một vị trí tổng hợp để đọc ra đầu ra cho toàn ảnh. Thứ hai là thông tin vị trí, vì self-attention thuần túy không tự biết patch nào nằm ở góc trái, patch nào ở trung tâm.
Giống BERT trong NLP, ViT thêm một CLS token học được ở đầu chuỗi. Token này không đại diện cho một patch thật nào trong ảnh. Vai trò của nó là thu gom thông tin từ toàn bộ chuỗi qua nhiều lớp attention, để cuối cùng ta dùng chính vector tương ứng với token này cho bài toán phân loại.
Ngoài ra, ViT cộng thêm positional embedding vào chuỗi token đầu vào:
Trong đó:
- là vector của
CLS token. - là các patch embeddings.
- là positional embedding được học.
- là chuỗi token đầu vào của encoder.
Phần positional embedding nghe có vẻ phụ, nhưng thật ra rất quan trọng. Hai patch có nội dung giống nhau nhưng nằm ở vị trí khác nhau trong ảnh có thể mang ý nghĩa khác nhau. Không có tín hiệu vị trí, mô hình chỉ biết "có những patch này", chứ không biết chúng được sắp thành cấu trúc gì.
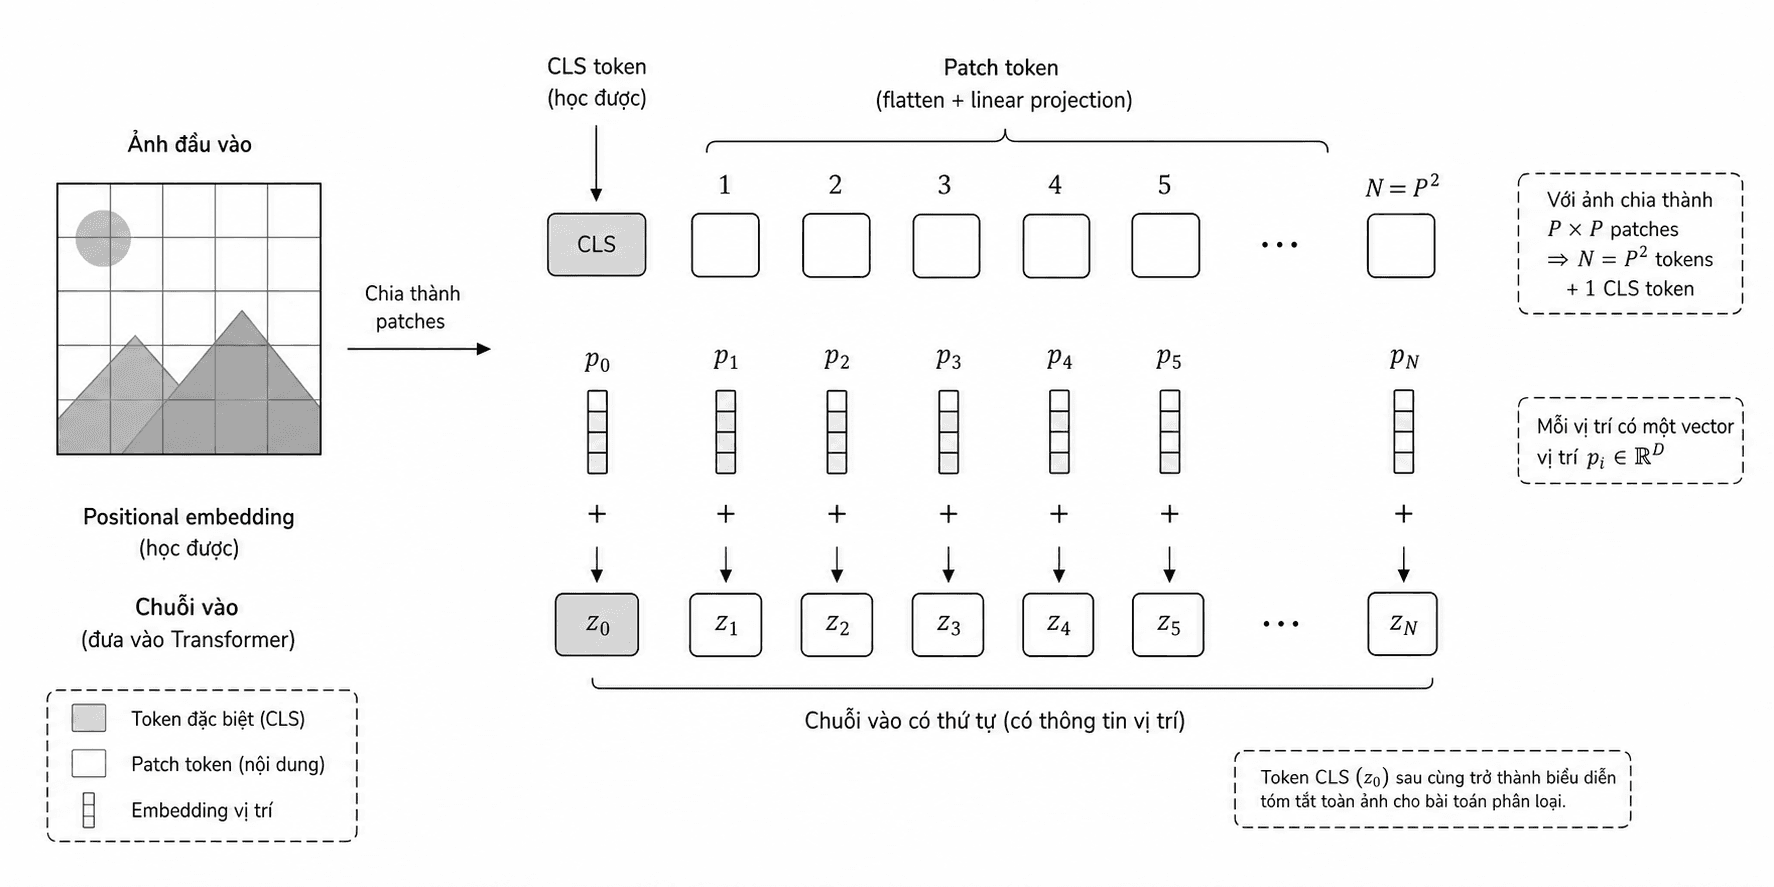
Đây cũng là chỗ ta thấy ViT không hoàn toàn bỏ cấu trúc ảnh. Nó bỏ convolution, nhưng vẫn phải đưa một cách nào đó để mô hình biết các patch đang đứng ở đâu trong lưới 2D ban đầu.
Cơ chế self-attention trong biểu diễn ảnh
Một khi ảnh đã trở thành chuỗi token, ViT dùng đúng cơ chế self-attention quen thuộc của Transformer. Từ ma trận token đầu vào , ta tạo ra ba ma trận:
Trong đó:
- là ma trận query.
- là ma trận key.
- là ma trận value.
- là các ma trận tham số học được.
Attention sau đó được tính bằng:
Trong đó:
- là số chiều của key, dùng để chuẩn hóa độ lớn tích vô hướng.
- tạo ra ma trận điểm tương quan giữa mọi cặp token.
softmaxbiến các điểm đó thành trọng số attention.
Với ảnh, ý nghĩa của phép tính này khá trực quan. Mỗi patch sẽ "nhìn" sang mọi patch khác, chấm điểm mức liên quan, rồi lấy trung bình có trọng số các value để cập nhật biểu diễn của chính nó. Một patch ở góc ảnh có thể tham chiếu trực tiếp đến một patch ở vùng giữa nếu hai vùng đó cùng góp phần nhận diện vật thể.
Điểm hấp dẫn nhất của ViT nằm ở đây. Ngữ cảnh toàn cục có thể đi vào rất sớm, thay vì phải chờ nhiều tầng convolution mở rộng receptive field dần dần.
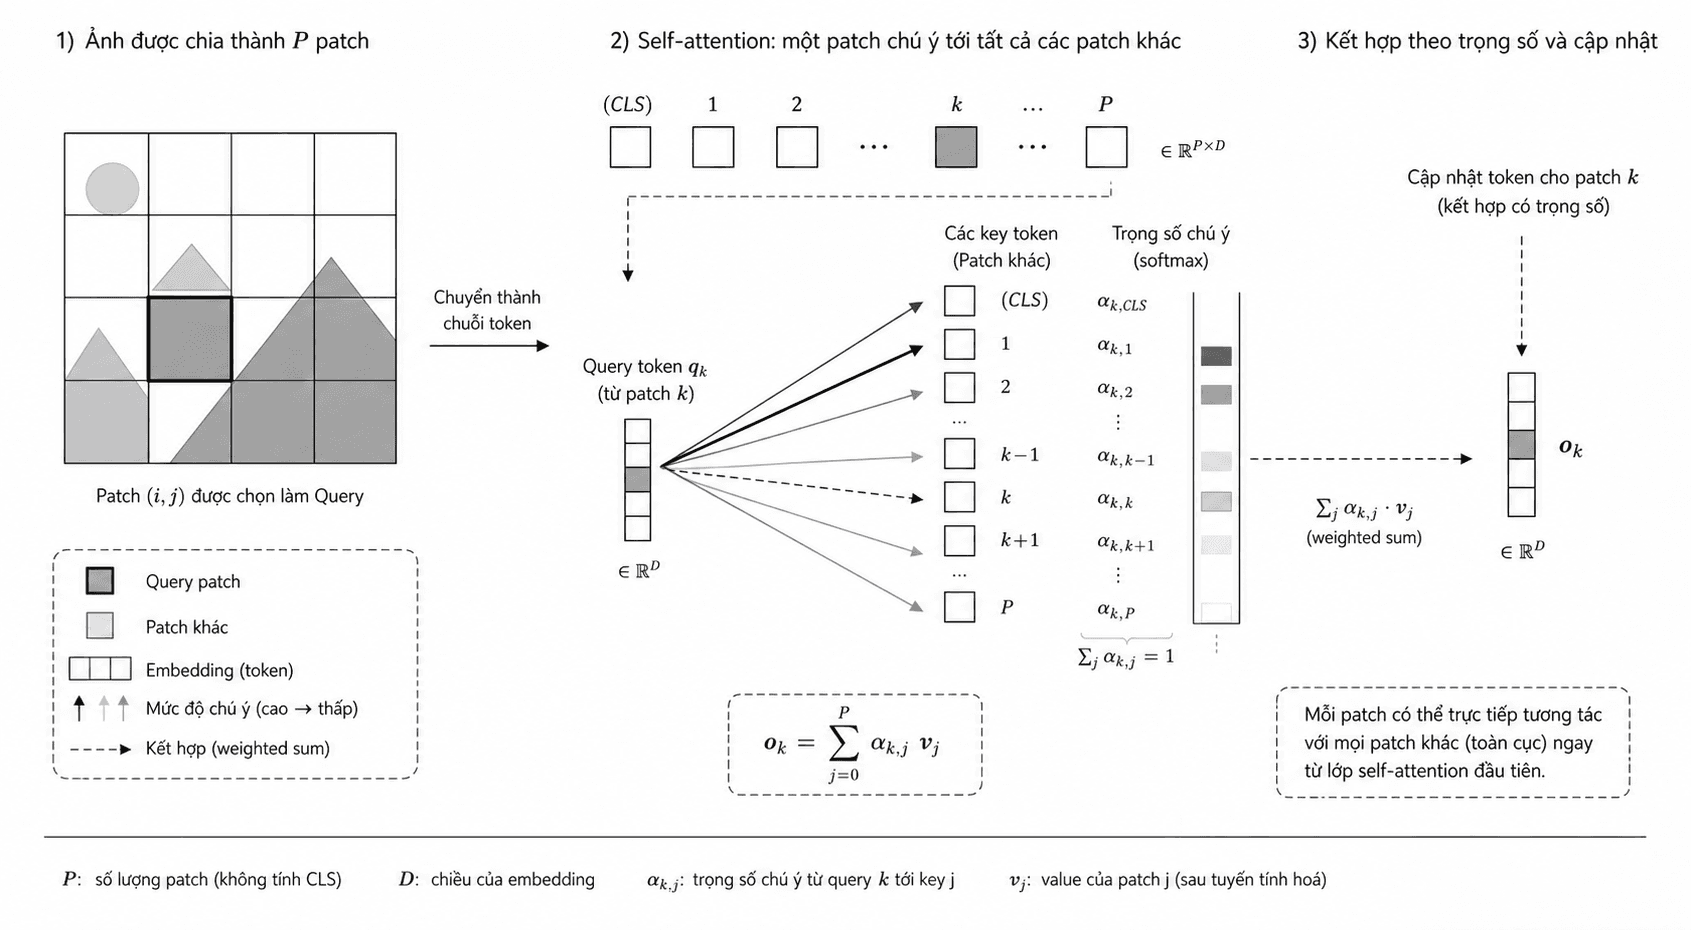
Tất nhiên, cái giá phải trả là chi phí tính toán. Nếu có token, ma trận attention có kích thước , nên độ phức tạp theo số token là bậc hai. Với ảnh độ phân giải cao hoặc patch quá nhỏ, phần này rất nhanh trở thành nút thắt.
Cấu trúc encoder block của Vision Transformer
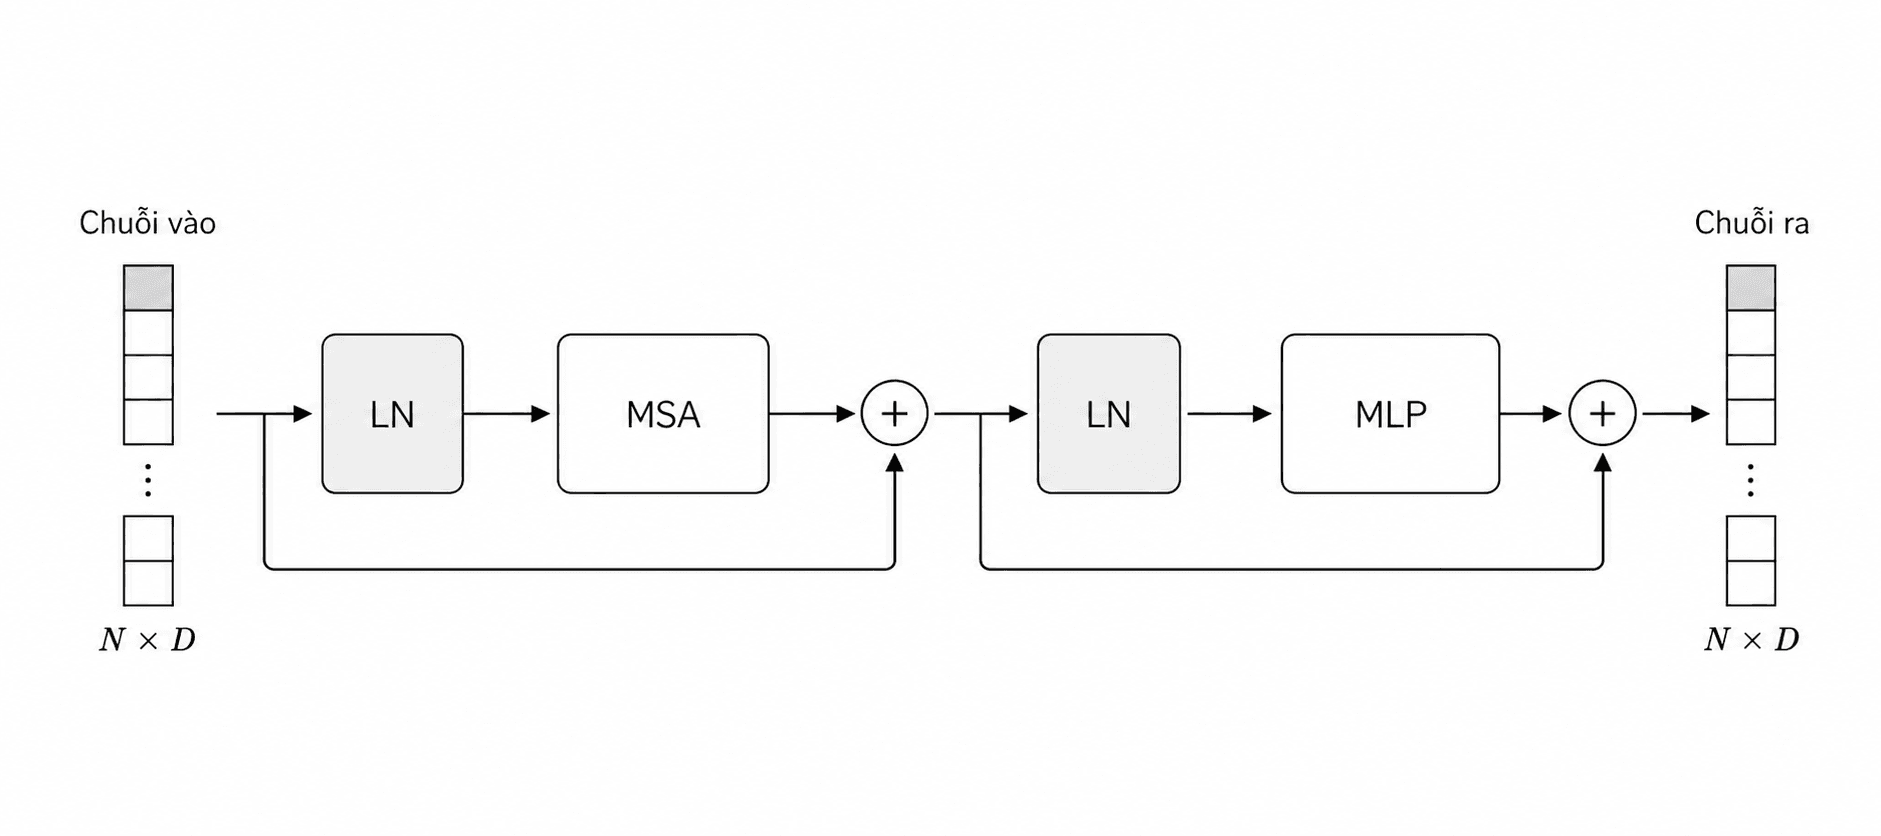
Về mặt khối kiến trúc, một encoder block của ViT rất giống Transformer encoder chuẩn. Mỗi block gồm Multi-Head Self-Attention, residual connection, LayerNorm, rồi đến một MLP block hai lớp tuyến tính với hàm kích hoạt ở giữa.
Nếu ký hiệu đầu vào block thứ là , ta có thể viết:
Trong đó:
- là
LayerNorm. - là
Multi-Head Self-Attention. - thường là hai lớp tuyến tính với hidden dimension lớn hơn dimension đầu vào.
- dấu
+thể hiện residual connection.
Residual connection giữ cho tín hiệu cũ không bị mất quá nhanh, còn LayerNorm giúp việc tối ưu ổn định hơn. MLP block nghe có vẻ phụ so với attention, nhưng nó chính là chỗ mô hình biến đổi từng token theo hướng phi tuyến sau khi đã trao đổi thông tin liên-token.
Khi chồng nhiều block như vậy, CLS token dần trở thành nơi tích lũy thông tin toàn cục. Các patch tokens cũng không còn chỉ mang thông tin cục bộ ban đầu. Chúng trở thành những biểu diễn đã được hiệu chỉnh bởi ngữ cảnh của toàn ảnh.
Phụ thuộc dữ liệu và vai trò của pretraining quy mô lớn
Khi ViT mới xuất hiện, một quan sát rất rõ là nó không phải lúc nào cũng thắng CNN nếu chỉ huấn luyện trên tập dữ liệu vừa phải. Điều này lúc đầu khiến nhiều người hơi ngạc nhiên, nhưng nhìn từ inductive bias thì lại rất hợp lý.
CNN được ưu ái sẵn nhiều giả định phù hợp với ảnh: tính cục bộ, tính tịnh tiến, chia sẻ kernel. ViT bỏ bớt những ưu ái đó, nên nó cần dữ liệu đủ lớn để tự học ra các quy luật mà CNN gần như đã được cài sẵn vào cấu trúc. Khi có pretraining mạnh trên tập dữ liệu lớn, ViT bắt đầu phát huy rõ lợi thế về khả năng mở rộng và tính thống nhất kiến trúc.
Một cách viết chi phí attention theo kích thước ảnh là:
Trong đó:
- là số token ảnh.
- là kích thước ảnh.
- là patch size.
Công thức này giải thích luôn hai điều. Thứ nhất, patch size nhỏ sẽ làm attention đắt rất nhanh. Thứ hai, khi tăng độ phân giải ảnh, chi phí cũng phình lên rất mạnh. Bởi vậy, rất nhiều biến thể về sau của ViT tìm cách giảm bớt bài toán này, hoặc đưa lại một phần locality bias vào kiến trúc.
Nhìn rộng ra, ViT không chỉ là một kiến trúc cụ thể. Nó mở ra một hướng nghĩ mới cho vision: ảnh có thể được xử lý bằng cùng ngôn ngữ kiến trúc với văn bản, miễn là ta tìm được cách token hóa phù hợp và có đủ dữ liệu để mô hình học. Từ đó mới xuất hiện thêm cả một họ mô hình như DeiT, Swin Transformer, MAE và rất nhiều hướng hybrid hoặc hierarchical khác.
Điều kiện ứng dụng phù hợp của Vision Transformer
Nếu bài toán của ta có dữ liệu lớn, pipeline pretraining tốt, và cần một backbone thống nhất để nối sang multimodal learning hoặc self-supervised learning, ViT là một lựa chọn rất đáng để ưu tiên. Nó đặc biệt hợp ở những nơi ta muốn mô hình học quan hệ toàn cục tốt và muốn dùng cùng ngôn ngữ kiến trúc với các họ Transformer khác.
Ngược lại, nếu dữ liệu ít, tài nguyên hạn chế, hoặc bài toán phụ thuộc mạnh vào cấu trúc cục bộ ổn định, CNN hoặc các kiến trúc lai vẫn có thể là lựa chọn thực dụng hơn. Trong công việc thật, câu hỏi hay không phải là "ViT có thay thế hoàn toàn CNN không", mà là "với dữ liệu, tài nguyên và mục tiêu của hệ này, inductive bias nào đang giúp ta nhiều hơn".
Hiểu ViT theo cách đó sẽ bền hơn việc chỉ nhớ rằng "ảnh được cắt thành patch rồi đưa vào Transformer". Điều đáng học nhất ở ViT là cách nó chuyển một bài toán vision sang bài toán mô hình hóa quan hệ giữa các token, rồi để attention đảm nhận vai trò xây ngữ cảnh toàn cục ngay từ rất sớm.