Coordinate Transformation - Phép biến đổi tọa độ
Ở bài trước, ta đã nói rằng robot không chỉ cần biết các khớp đang xoay bao nhiêu. Nó còn phải biết end-effector đang ở đâu trong không gian, chiếc cốc nằm ở đâu, và phải đổi một mục tiêu trong task space thành lệnh cho các khớp. Nghe như vậy tưởng đã đủ, nhưng ngay khi đưa camera vào hệ robot, một vấn đề khác xuất hiện: “ở đâu” là ở đâu trong hệ tọa độ nào?
Một chiếc cốc có thể nằm ở vị trí trong hệ tọa độ của camera. Nhưng tay robot lại điều khiển theo hệ tọa độ gắn với đế robot. End-effector có hệ tọa độ riêng của nó. Nếu robot đặt cốc lên một khay đang di chuyển, khay đó cũng có thể có một hệ tọa độ riêng. Cùng một điểm vật lý trong không gian, nhưng khi nhìn từ các frame khác nhau, tọa độ của nó sẽ khác nhau.
Đây là lý do coordinate transformation là một trong những viên gạch nền của robotics, computer vision, SLAM và điều khiển robot. Nó không phải một thủ thuật toán học để đổi số cho đẹp. Nó là cách ta giữ cho tất cả cảm biến, mô hình robot và mục tiêu nhiệm vụ cùng nói về một thế giới vật lý duy nhất.
Trong bài này, ta tiếp tục dùng ví dụ tay robot gắp cốc. Camera quan sát thấy chiếc cốc. Robot cần đưa đầu kẹp tới cốc. Bài toán không còn là “tính IK như thế nào” ngay lập tức, mà là: tọa độ cốc do camera đo được phải được chuyển sang hệ tọa độ của robot ra sao.
Hệ tọa độ
Một hệ tọa độ, hay coordinate frame, là cách ta đặt một gốc tọa độ và ba trục để mô tả điểm trong không gian. Trong robotics, frame thường được gắn vào các vật thể hoặc bộ phận cụ thể: frame của camera, frame của đế robot, frame của từng khớp, frame của end-effector, frame của vật cần gắp.
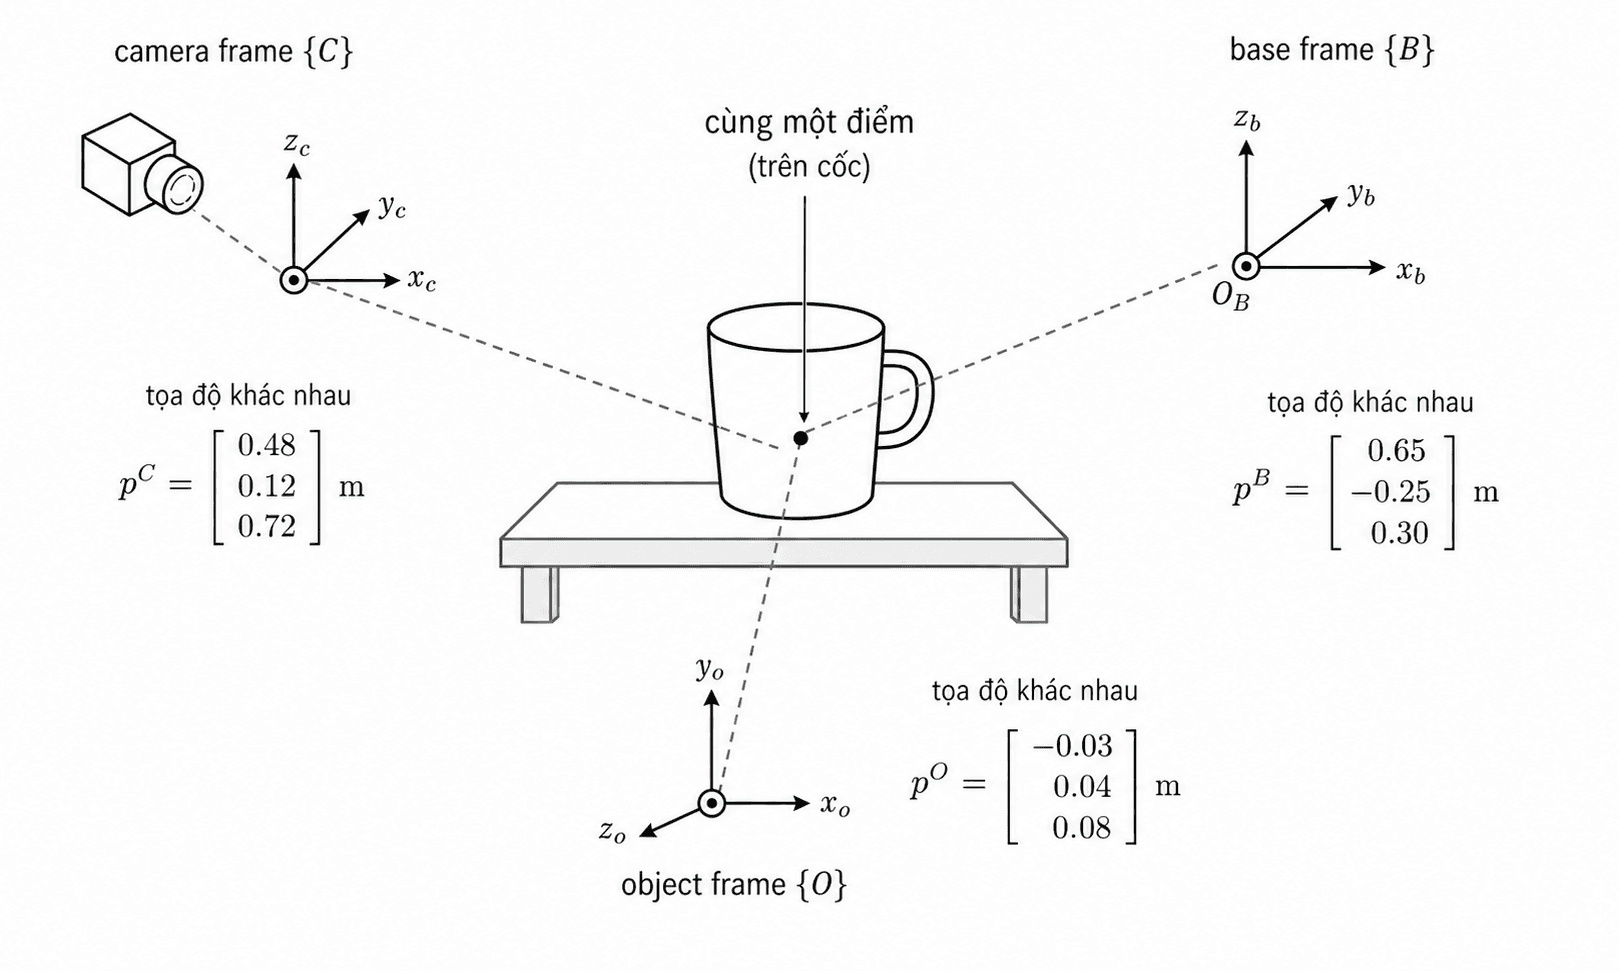
Điểm quan trọng là tọa độ không phải bản thân điểm vật lý. Tọa độ chỉ là cách mô tả điểm đó dưới một frame cụ thể. Một điểm trên miệng cốc vẫn là cùng một điểm trong thế giới thật, nhưng tọa độ của nó trong camera frame và trong robot base frame có thể khác nhau hoàn toàn.
Ta có thể ký hiệu tọa độ của một điểm trong frame là:
Chỉ số bên trái không phải để làm công thức trông phức tạp hơn. Nó nói rõ vector này đang được viết trong frame nào. Nếu bỏ chỉ số frame, ta rất dễ cộng trừ nhầm các vector không cùng hệ tọa độ. Trong robotics, rất nhiều lỗi khó tìm bắt đầu từ một việc nhỏ như vậy: dùng đúng con số, nhưng con số đó thuộc sai frame.
Với ví dụ gắp cốc, camera có thể trả về , tức vị trí cốc trong camera frame . Nhưng inverse kinematics của tay robot thường cần mục tiêu trong base frame , tức . Coordinate transformation chính là phép đổi từ sang .
Vector và frame
Một vector tọa độ chỉ có nghĩa khi đi kèm frame. Nếu camera nói chiếc cốc ở phía trước 0.6 m, bên phải 0.1 m, thấp hơn 0.2 m, những hướng “trước”, “phải”, “thấp” đó là theo trục của camera. Nếu camera bị nghiêng so với robot, trục “trước” của camera không nhất thiết trùng với trục “trước” của robot.
Đây là khác biệt rất dễ bị xem nhẹ. Người mới thường nhìn một vector như một bộ ba số:
Nhưng trong robot, bộ ba số đó luôn là tọa độ của điểm theo một bộ trục nào đó. Nếu đổi frame, bộ ba số thay đổi, dù điểm vật lý không đổi.
Vì vậy, khi đọc hoặc viết các công thức hình học trong robotics, câu hỏi đầu tiên nên là: đại lượng này đang được biểu diễn trong frame nào? Nếu câu trả lời không rõ, công thức đó rất dễ gây nhầm lẫn khi đi vào hệ thống thật.
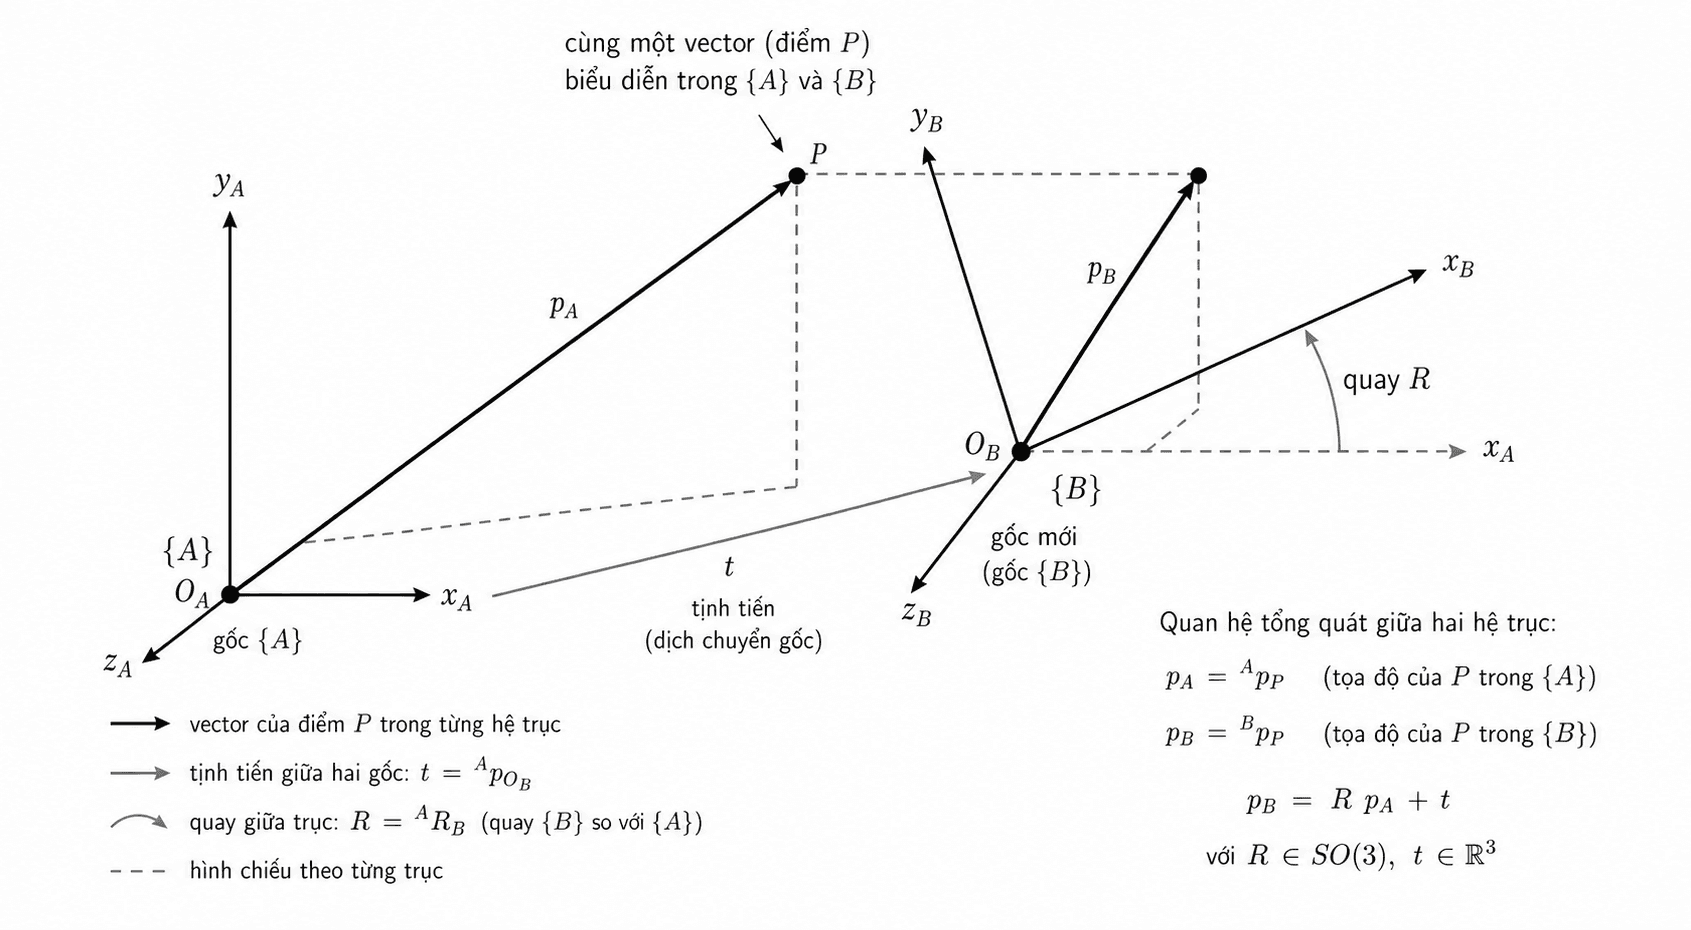
Từ đây, ta cần một cơ chế mô tả quan hệ giữa hai frame. Quan hệ đó gồm hai phần: một frame có thể bị xoay so với frame kia, và gốc của nó có thể bị tịnh tiến so với frame kia.
Translation
Translation mô tả sự lệch gốc giữa hai frame. Giả sử frame camera đặt cách frame đế robot một vector . Ký hiệu này có thể đọc là: vị trí gốc của frame được biểu diễn trong frame .
Nếu hai frame có cùng hướng trục và chỉ lệch gốc, đổi tọa độ của điểm từ camera frame sang base frame chỉ cần cộng thêm vector tịnh tiến:
Công thức này chỉ đúng trong trường hợp hai frame không bị xoay tương đối. Nó giống việc ta đổi vị trí từ một thước đo có gốc đặt ở camera sang một thước đo có gốc đặt ở robot, nhưng hai thước cùng hướng.
Trong thực tế, camera hiếm khi được gắn sao cho trục của nó trùng hoàn toàn với trục robot. Camera có thể nhìn xuống bàn, nghiêng một góc, hoặc đặt lệch sang một bên. Khi đó, chỉ cộng translation là chưa đủ. Ta còn phải đổi hướng trục.
Rotation
Rotation mô tả hướng của một frame so với frame khác. Trong 3D, rotation thường được biểu diễn bằng ma trận . Nếu là rotation matrix từ frame sang frame , nó cho biết các trục của camera frame được nhìn như thế nào trong base frame.
Khi chỉ có rotation mà chưa xét translation, một vector trong camera frame có thể được đổi sang base frame bằng:
Ở đây, là vector được biểu diễn trong camera frame, còn là cùng vector đó sau khi được biểu diễn trong base frame. Rotation không làm thay đổi độ dài vật lý của vector. Nó chỉ đổi cách vector đó được viết theo bộ trục mới.
Một rotation matrix hợp lệ có hai tính chất quan trọng:
Tính chất đầu nói rằng các trục sau khi quay vẫn vuông góc và có độ dài đơn vị. Tính chất thứ hai loại bỏ trường hợp phản chiếu, tức hình bị lật chứ không phải chỉ bị quay. Những tính chất này quan trọng vì robot không được phép biến một vật rắn thành vật bị co kéo hoặc lật gương chỉ vì biểu diễn rotation sai.
Rotation giải quyết phần hướng trục, translation giải quyết phần lệch gốc. Một điểm trong không gian cần cả hai.
Rigid transformation
Một phép biến đổi tọa độ giữa hai frame của vật rắn thường gồm rotation và translation. Với điểm có tọa độ trong camera frame , tọa độ của nó trong base frame được tính bằng:
Đây là công thức quan trọng nhất của bài. Nó nói rằng muốn đổi tọa độ của một điểm từ frame sang frame , ta trước hết xoay vector theo quan hệ hướng giữa hai frame, rồi cộng phần lệch gốc.
Trong ví dụ gắp cốc, là tọa độ cốc do camera đo được. Nếu biết extrinsic calibration giữa camera và robot, tức biết và , ta có thể tính:
Kết quả mới là thứ có thể đưa vào tầng robot planning hoặc inverse kinematics. Nếu bỏ qua bước này, robot có thể “nghĩ” chiếc cốc nằm ở một vị trí khác so với vị trí thật trong hệ của nó.
Ta cũng thấy vì sao calibration quan trọng. Nếu rotation hoặc translation giữa camera và robot bị sai, mọi điểm camera đo được sẽ bị chuyển sang base frame sai. Khi đó thuật toán IK có thể vẫn chạy đúng về mặt toán học, nhưng mục tiêu đầu vào đã sai ngay từ đầu.
Homogeneous transformation
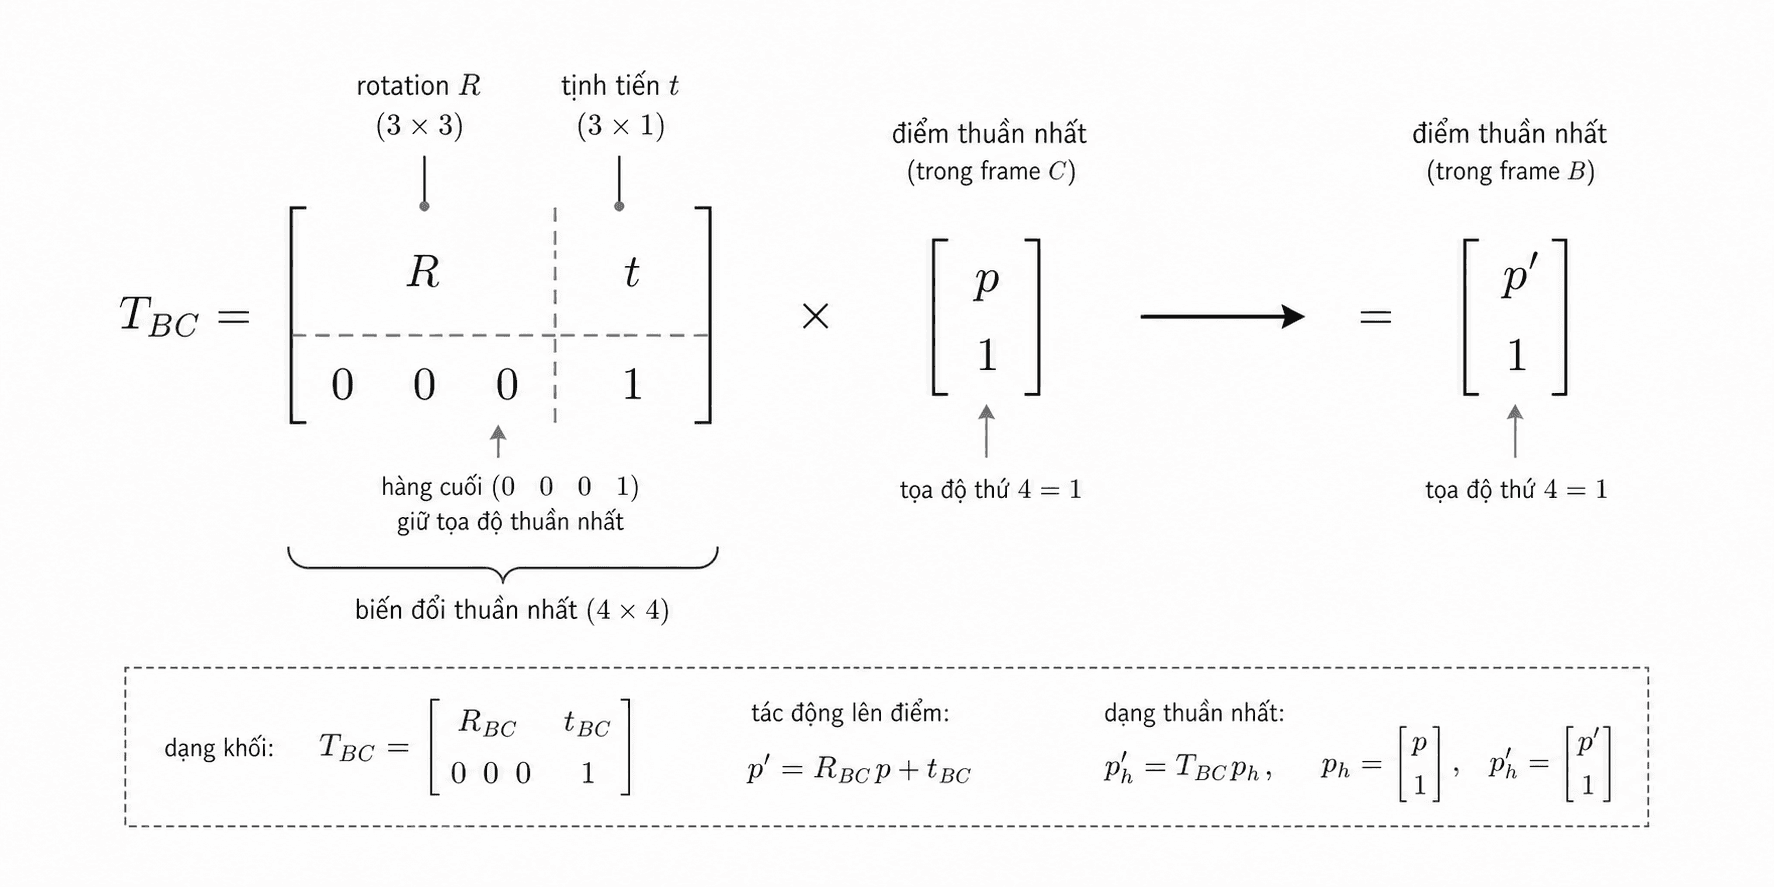
Công thức rotation cộng translation rất rõ ràng, nhưng khi hệ robot có nhiều frame nối tiếp nhau, viết riêng từng rotation và translation sẽ nhanh chóng rối. Robotics thường dùng homogeneous transformation để gói cả hai vào một ma trận :
Để nhân được với ma trận này, điểm 3D được viết dưới dạng homogeneous coordinate:
Khi đó phép đổi tọa độ trở thành:
Ký hiệu dấu ngã chỉ rằng vector đang ở dạng homogeneous, tức có thêm phần tử cuối bằng . Phần tử này cho phép translation được viết chung trong phép nhân ma trận. Nếu nhân ra, ta sẽ quay lại đúng công thức cũ: rotation nhân với điểm, rồi cộng translation.
Homogeneous transformation không làm bài toán “mạnh hơn” về mặt hình học, nhưng làm chuỗi biến đổi trở nên gọn và ít lỗi hơn. Điều này đặc biệt quan trọng khi ta phải đi qua nhiều frame.
Chuỗi frame
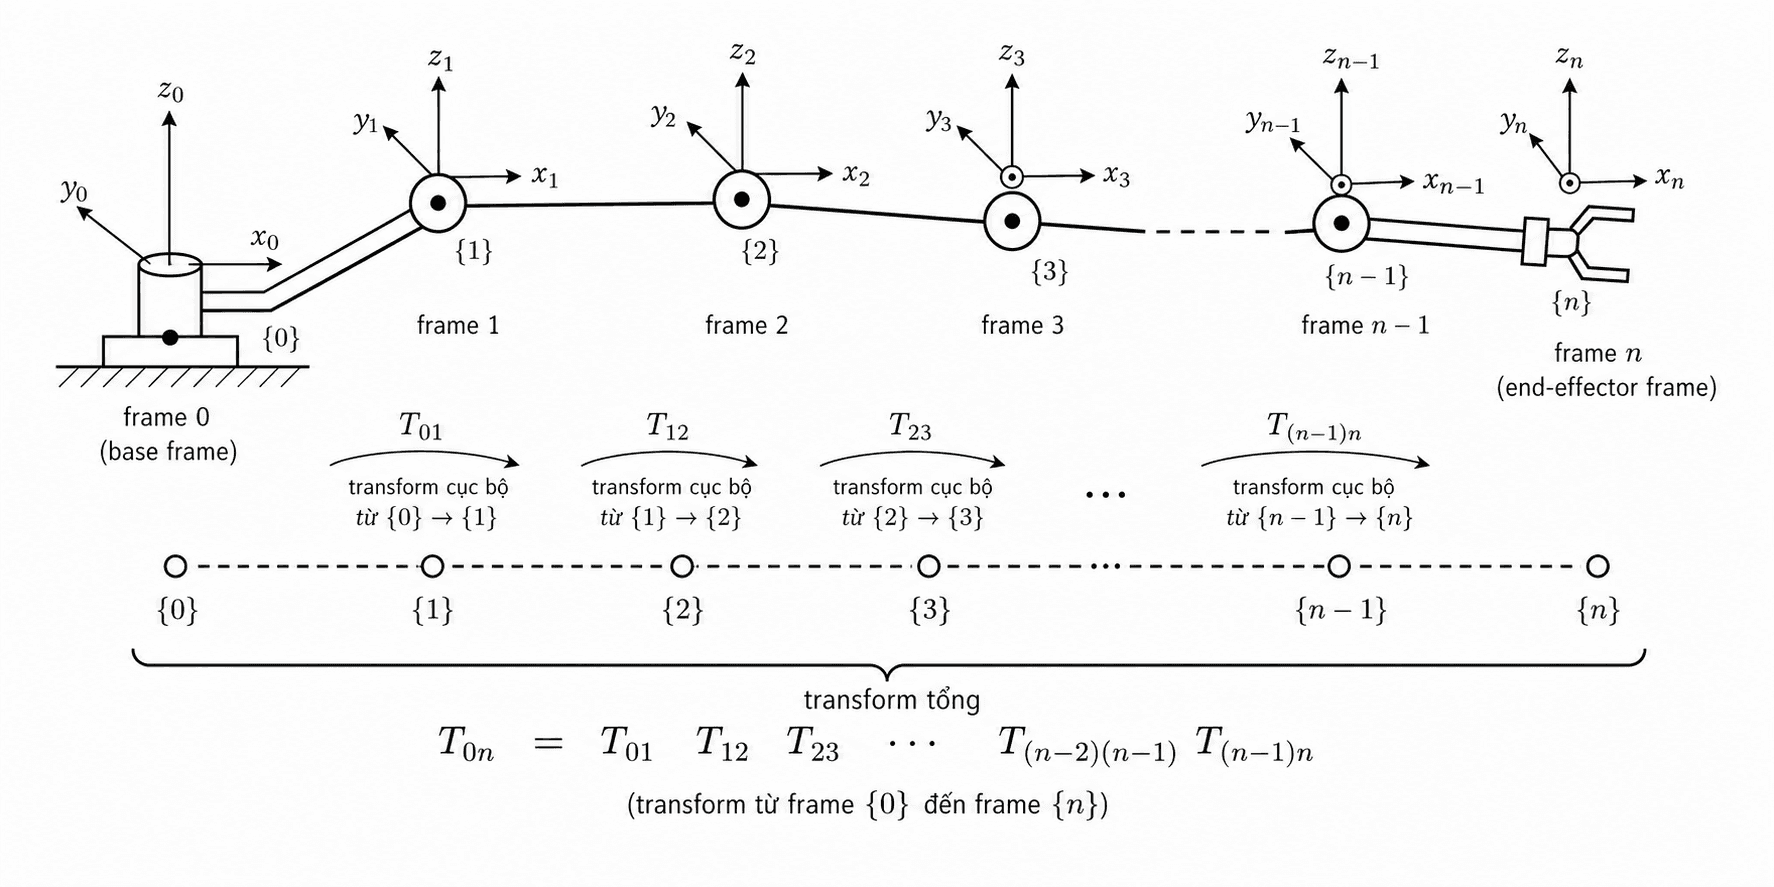
Trong một hệ robot thật, hiếm khi ta chỉ có hai frame. Một pipeline gắp cốc có thể có:
- world frame
- robot base frame
- camera frame
- end-effector frame
- object frame
Nếu camera đo pose của chiếc cốc trong camera frame, nhưng robot cần pose đó trong base frame, ta cần biến đổi qua quan hệ giữa camera và base. Nếu camera lại được gắn trên end-effector, chuỗi biến đổi còn dài hơn: base tới end-effector, end-effector tới camera, camera tới object.
Homogeneous transformation cho phép ta ghép các quan hệ đó bằng phép nhân ma trận. Ví dụ, nếu biết transform từ base tới end-effector và từ end-effector tới camera, ta có:
Nếu camera quan sát được object frame , ta có thể đưa object về base frame bằng:
Hoặc viết đầy đủ hơn:
Thứ tự nhân ở đây không thể tùy tiện đổi chỗ. Ma trận biến đổi tọa độ không giao hoán. Quay rồi tịnh tiến thường không giống tịnh tiến rồi quay. Đây là một trong những chỗ dễ sai nhất khi mới làm robotics.
Một cách kiểm tra thực dụng là đọc chỉ số frame như các mắt xích. Trong , chỉ số ở giữa “khớp” nhau, nên kết quả nối được từ về . Nếu viết ngược thứ tự, các frame không còn nối đúng nữa.
Inverse transformation
Không phải lúc nào ta cũng cần đổi từ camera sang base. Có khi ta có pose của end-effector trong base frame, nhưng muốn biết một điểm trong base frame trông như thế nào từ camera frame. Khi đó ta cần inverse transformation.
Nếu:
thì transform ngược từ sang là:
Công thức này đáng đọc kỹ. Rotation ngược là transpose của rotation matrix, vì rotation matrix hợp lệ có trực chuẩn. Translation ngược không chỉ là đổi dấu đơn giản trong mọi trường hợp. Ta phải đổi dấu sau khi đưa vector translation về frame ngược bằng rotation transpose.
Đây là lỗi rất phổ biến: thấy camera cách robot một vector , rồi nghĩ transform ngược chỉ là . Điều đó chỉ đúng nếu hai frame cùng hướng. Khi có rotation, phần translation ngược phải đi qua rotation ngược.
Pose
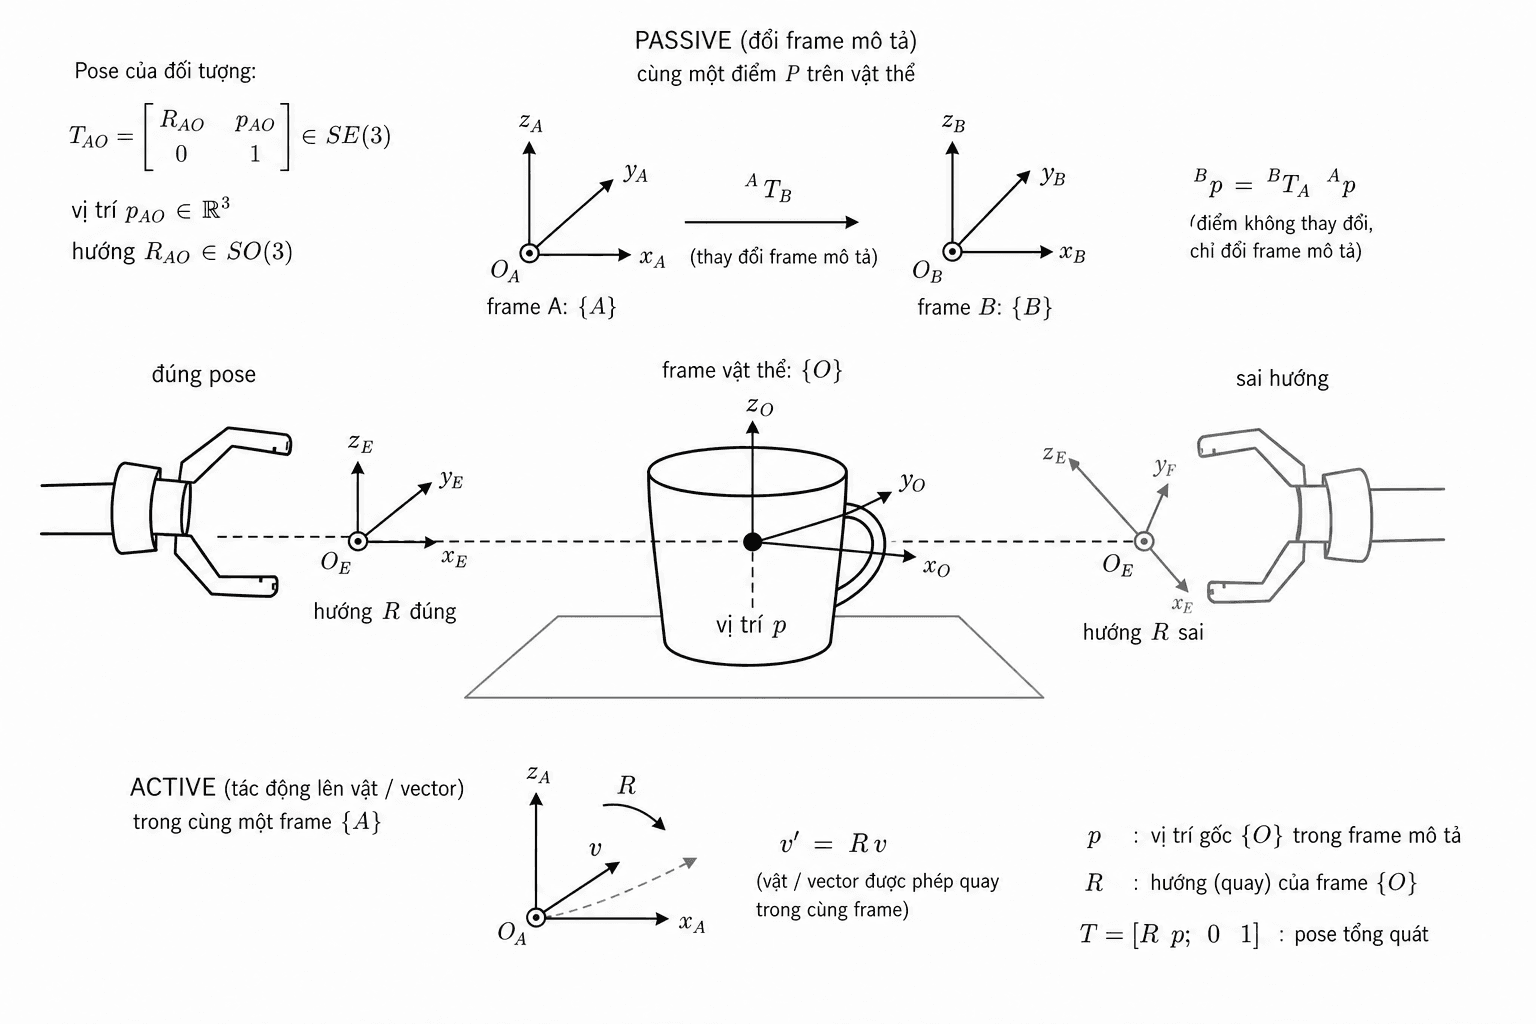
Trong robotics, ta thường không chỉ biến đổi điểm, mà còn biến đổi pose. Pose gồm position và orientation. Với end-effector, pose trả lời cả hai câu hỏi: nó ở đâu và nó quay theo hướng nào.
Nếu object frame được quan sát trong camera frame , pose của object không chỉ là vị trí tâm cốc. Nó còn có orientation của cốc. Một transform mô tả đầy đủ frame object so với frame camera:
Khi đổi pose object sang base frame, ta không biến đổi riêng từng điểm trên cốc. Ta ghép transform:
Kết quả cho ta cả vị trí và hướng của object trong base frame. Với bài toán gắp, điều này quan trọng hơn chỉ lấy tâm cốc. Đầu kẹp cần biết tiếp cận cốc từ hướng nào, không chỉ biết cốc nằm ở đâu.
Từ pose object trong base frame, hệ thống có thể tạo ra một grasp pose cho end-effector. Grasp pose này cũng là một transform, ví dụ . Inverse kinematics sau đó mới tìm cấu hình khớp sao cho end-effector đạt pose mục tiêu đó.
Active và passive transformation
Một nguồn nhầm lẫn khác là sự khác nhau giữa active transformation và passive transformation. Hai cách nhìn này dùng công thức giống nhau ở nhiều chỗ, nhưng ý nghĩa khác nhau.
Passive transformation là đổi cách biểu diễn cùng một điểm sang frame khác. Điểm vật lý không di chuyển; chỉ hệ tọa độ dùng để mô tả nó thay đổi. Khi ta đổi sang , ta đang làm passive transformation.
Active transformation là thật sự di chuyển hoặc quay một vật trong cùng một frame. Ví dụ, ta xoay một vector quanh trục trong base frame để tạo ra một vị trí mới. Lúc này vector vật lý đã thay đổi.
Trong robotics software, hai cách nhìn này dễ bị trộn vào nhau vì cùng xuất hiện rotation matrix và transform matrix. Cách tự bảo vệ tốt nhất là luôn viết rõ frame ở ký hiệu và đọc câu hỏi vật lý trước khi viết công thức: ta đang đổi frame biểu diễn, hay đang di chuyển vật thể?
Với bài gắp cốc, đa số phép biến đổi ban đầu là passive: camera thấy cốc, ta đổi biểu diễn cốc sang base frame. Sau đó, khi planner tạo quỹ đạo để end-effector chuyển động, ta mới nói tới việc pose của robot thay đổi theo thời gian.
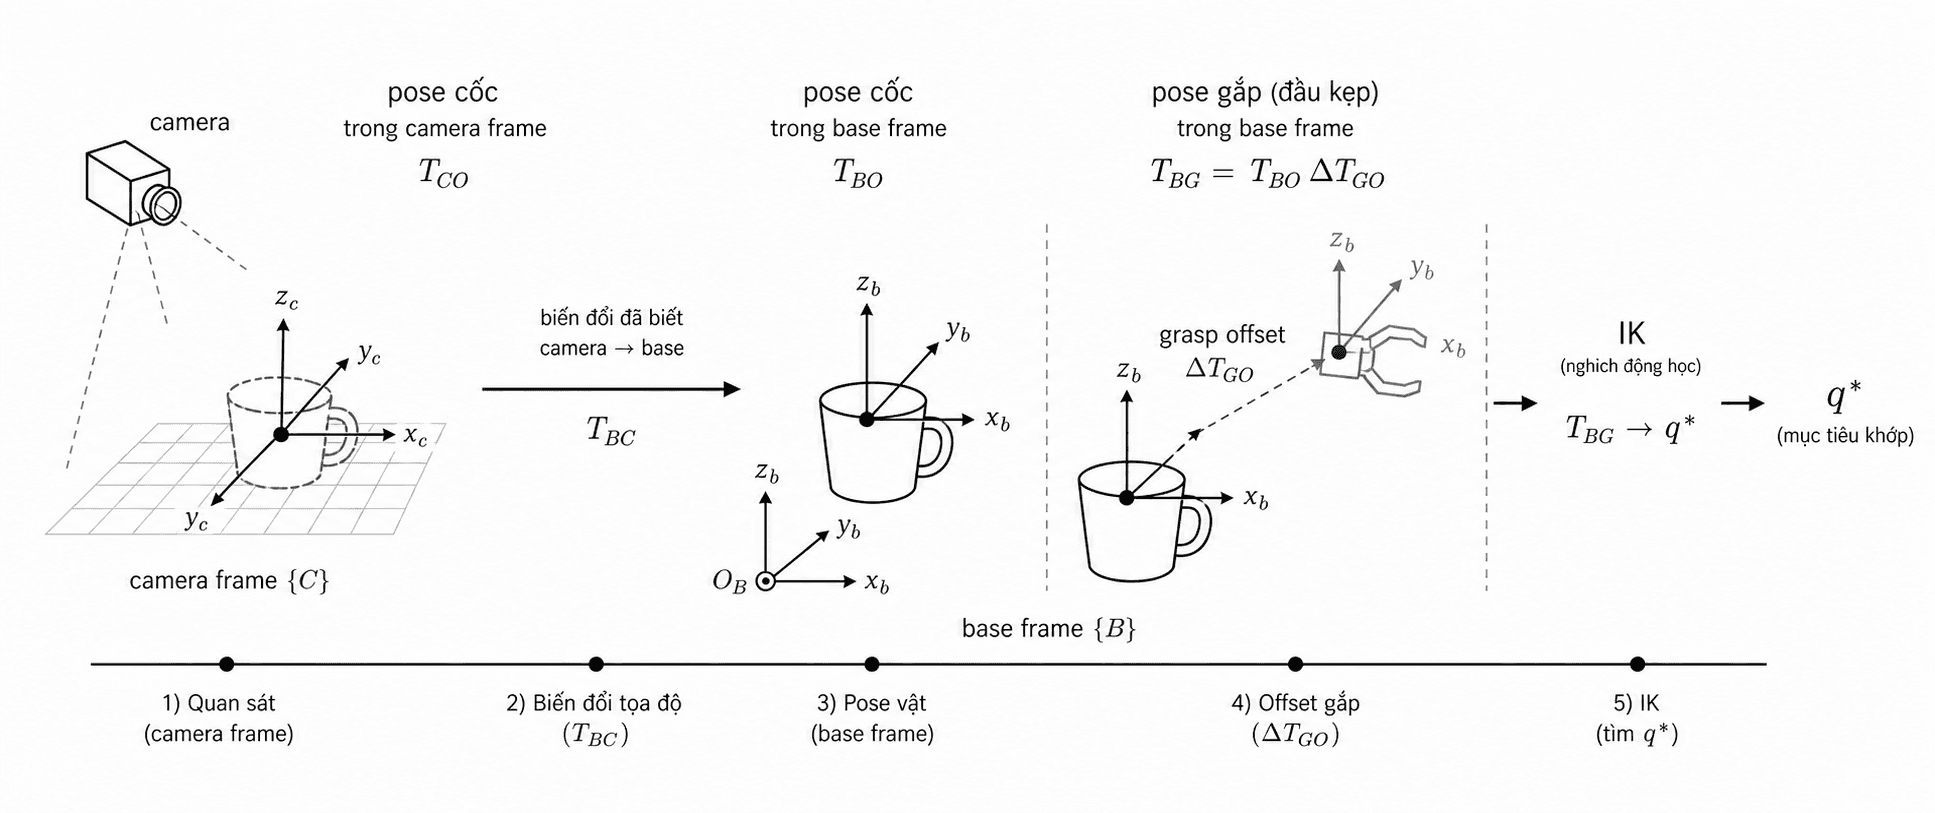
Coordinate transformation trong pipeline gắp vật
Đây là chỗ toàn bộ ý tưởng trở nên thực dụng. Camera nhìn thấy chiếc cốc, nhưng con số camera trả về đang sống trong camera frame, không phải trong frame của robot. Robot chỉ có thể điều khiển tốt nếu ta đưa mục tiêu ấy về cùng hệ tọa độ với đế robot.
Ta có thể nghĩ bài toán theo ba bước rất tự nhiên.
- Camera đo pose của cốc trong frame của camera.
- Ta dùng transform giữa camera và base để đổi pose đó sang frame robot.
- Ta thêm một “độ lệch gắp” nhỏ để từ pose của cốc ra pose mà đầu kẹp nên nhắm tới.
Viết gọn lại, nếu camera ước lượng được pose của vật là:
và ta đã biết transform giữa camera và base là:
thì pose của vật trong frame robot là:
Đây là công thức cốt lõi của đoạn này. Nó chỉ nói một việc rất đơn giản: cùng một chiếc cốc, nhưng muốn robot hiểu được nó thì phải đổi từ “cốc trong camera” sang “cốc trong base robot”.
Nhưng robot không gắp ngay vào tâm cốc. Đầu kẹp thường cần đứng hơi lệch ra một chút, theo một hướng tiếp cận cụ thể. Vì vậy ta không lấy làm đích cuối cùng, mà thêm một transform nhỏ từ vật sang tư thế gắp:
Ở đây, chỉ là “mẫu gắp” tương đối so với chiếc cốc: đầu kẹp nên đứng cách cốc bao xa, chụp từ phía nào, và quay theo hướng nào. Khi đã có , inverse kinematics mới nhận được một mục tiêu đúng hệ tọa độ:
Nếu muốn nhớ đoạn này bằng một câu, thì là: perception cho ta cốc ở đâu trong frame của camera, coordinate transformation đưa cốc sang frame của robot, rồi grasp offset biến vị trí cốc thành mục tiêu thật sự cho đầu kẹp. Không có bước đó, IK vẫn có thể chạy, nhưng nó đang chạy trên một mục tiêu ở sai hệ tọa độ.
Sai số calibration
Coordinate transformation thường được trình bày như một phép tính chính xác, nhưng trong hệ thật, transform giữa các frame đến từ calibration và luôn có sai số. Camera có thể được gắn lệch một chút so với mô hình. Đế robot có thể không đặt đúng như bản vẽ. Bàn làm việc có thể không phẳng tuyệt đối. Các marker hoặc thuật toán pose estimation cũng có nhiễu.
Sai số nhỏ trong rotation có thể gây lệch lớn ở điểm xa camera. Sai số vài độ khi nhìn xuống bàn có thể làm vị trí cốc trong base frame trượt đi đáng kể. Với robot gắp vật, sai số này có thể khiến đầu kẹp chạm lệch, kẹp vào mép cốc, hoặc va vào vật bên cạnh.
Đây là lý do các hệ robot nghiêm túc thường không chỉ dựa vào một lần biến đổi tọa độ rồi thực thi mù. Chúng có thể dùng visual servoing để cập nhật pose khi robot tiến gần vật, dùng cảm biến lực để phát hiện tiếp xúc, hoặc thiết kế grasp pose có dung sai lớn hơn. Coordinate transformation đưa robot tới gần đúng hình học; các lớp feedback giúp xử lý phần sai số còn lại.
Quy ước và lỗi thường gặp
Coordinate transformation khó không chỉ vì công thức, mà vì quy ước. Một số thư viện viết transform theo hướng “từ child sang parent”, một số API nhấn mạnh pose của frame này “relative to” frame kia, một số tài liệu dùng ký hiệu khác nhau cho cùng một ý. Nếu không đọc kỹ, ta rất dễ dùng ngược transform.
Các lỗi thường gặp gồm:
- Nhân transform sai thứ tự.
- Dùng trong khi cần .
- Cộng translation mà quên rotation.
- Đổi dấu translation khi lấy inverse nhưng quên nhân rotation transpose.
- Dùng degree và radian lẫn lộn khi tạo rotation.
- Nhầm trục camera với trục robot.
- Dùng rotation matrix không còn trực chuẩn sau nhiều bước tính toán số.
Một nguyên tắc hữu ích là kiểm tra bằng các trường hợp đơn giản. Nếu hai frame trùng nhau, transform phải là identity. Nếu một điểm nằm đúng tại gốc camera, sau khi đổi sang base frame nó phải trở thành vị trí của camera trong base frame. Nếu robot nhìn một vật ngay trước camera, hướng của vector sau khi đổi frame phải phù hợp với hướng camera đang nhìn trong robot base.
Những kiểm tra nhỏ này không thay thế calibration tốt, nhưng giúp phát hiện lỗi quy ước rất nhanh. Trong robotics, sai một frame có thể làm cả hệ thống trông như “thuật toán không ổn”, dù thực ra chỉ là transform bị dùng ngược.