Vector Embeddings / Work Embeddings
Khi ta tìm một tài liệu trong kho nội bộ của công ty, nhu cầu thật sự thường không phải là tìm đúng từ khóa. Ta muốn tìm những đoạn "cùng ý", ngay cả khi cách viết khác hẳn. Một kỹ sư có thể gõ "cách giảm độ trễ của camera trong pipeline perception", còn tài liệu gốc lại viết "đồng bộ timestamp để tránh lệch cảm biến". Một hệ chỉ dựa vào matching chuỗi ký tự sẽ khá chật vật với kiểu truy vấn như vậy.
Đó là lúc vector embeddings trở thành phần nền rất quan trọng của nhiều hệ AI hiện đại. Thay vì giữ dữ liệu ở dạng ký hiệu rời rạc như từ, token hay ID, ta ánh xạ mỗi đối tượng thành một vector trong không gian nhiều chiều. Khi hai vector nằm gần nhau, ta kỳ vọng hai đối tượng gốc cũng gần nhau về mặt ngữ nghĩa, chức năng hoặc ngữ cảnh sử dụng.
Ý tưởng này nghe có vẻ đơn giản, nhưng gần như toàn bộ NLP hiện đại, semantic search, recommender systems, metric learning, multimodal retrieval và cả nhiều phần trong robotics perception đều dựa vào nó. Hiểu embeddings không chỉ là hiểu một kỹ thuật biểu diễn dữ liệu. Nó là hiểu cách mô hình biến "ý nghĩa" thành hình học.
Hạn chế của biểu diễn rời rạc trong đo lường độ tương tự
Nếu ta biểu diễn mỗi từ hay mỗi tài liệu bằng một ID rời rạc, bản thân ID đó không mang quan hệ nào với các ID khác. Tài liệu số 15 không "gần" tài liệu số 16 hơn tài liệu số 2000. Tương tự, biểu diễn one-hot của từ robot và manipulator gần như trực giao với nhau dù hai từ này có quan hệ rất gần trong nhiều ngữ cảnh kỹ thuật.
Vấn đề nằm ở chỗ biểu diễn rời rạc rất tốt cho việc định danh, nhưng rất kém cho việc suy ra mức độ giống nhau. Một mô hình học sâu có thể tự học ra cấu trúc ở các lớp sau, nhưng nếu đầu vào ban đầu hoàn toàn thiếu hình học, mô hình sẽ phải gánh một phần việc rất nặng chỉ để tạo ra khái niệm "gần" và "xa".
Embedding giải quyết việc đó bằng cách chuyển một đối tượng thành một vector đặc trưng:
Trong đó:
- là đối tượng đầu vào, có thể là từ, câu, ảnh, audio hoặc item trong recommender system.
- là mô hình ánh xạ với tham số .
- là vector embedding.
- là số chiều của không gian embedding.
Từ thời điểm đó, bài toán "hai đối tượng có liên quan không" có thể được viết lại thành "hai vector này gần nhau đến mức nào". Câu hỏi ngữ nghĩa được kéo sang một câu hỏi hình học.
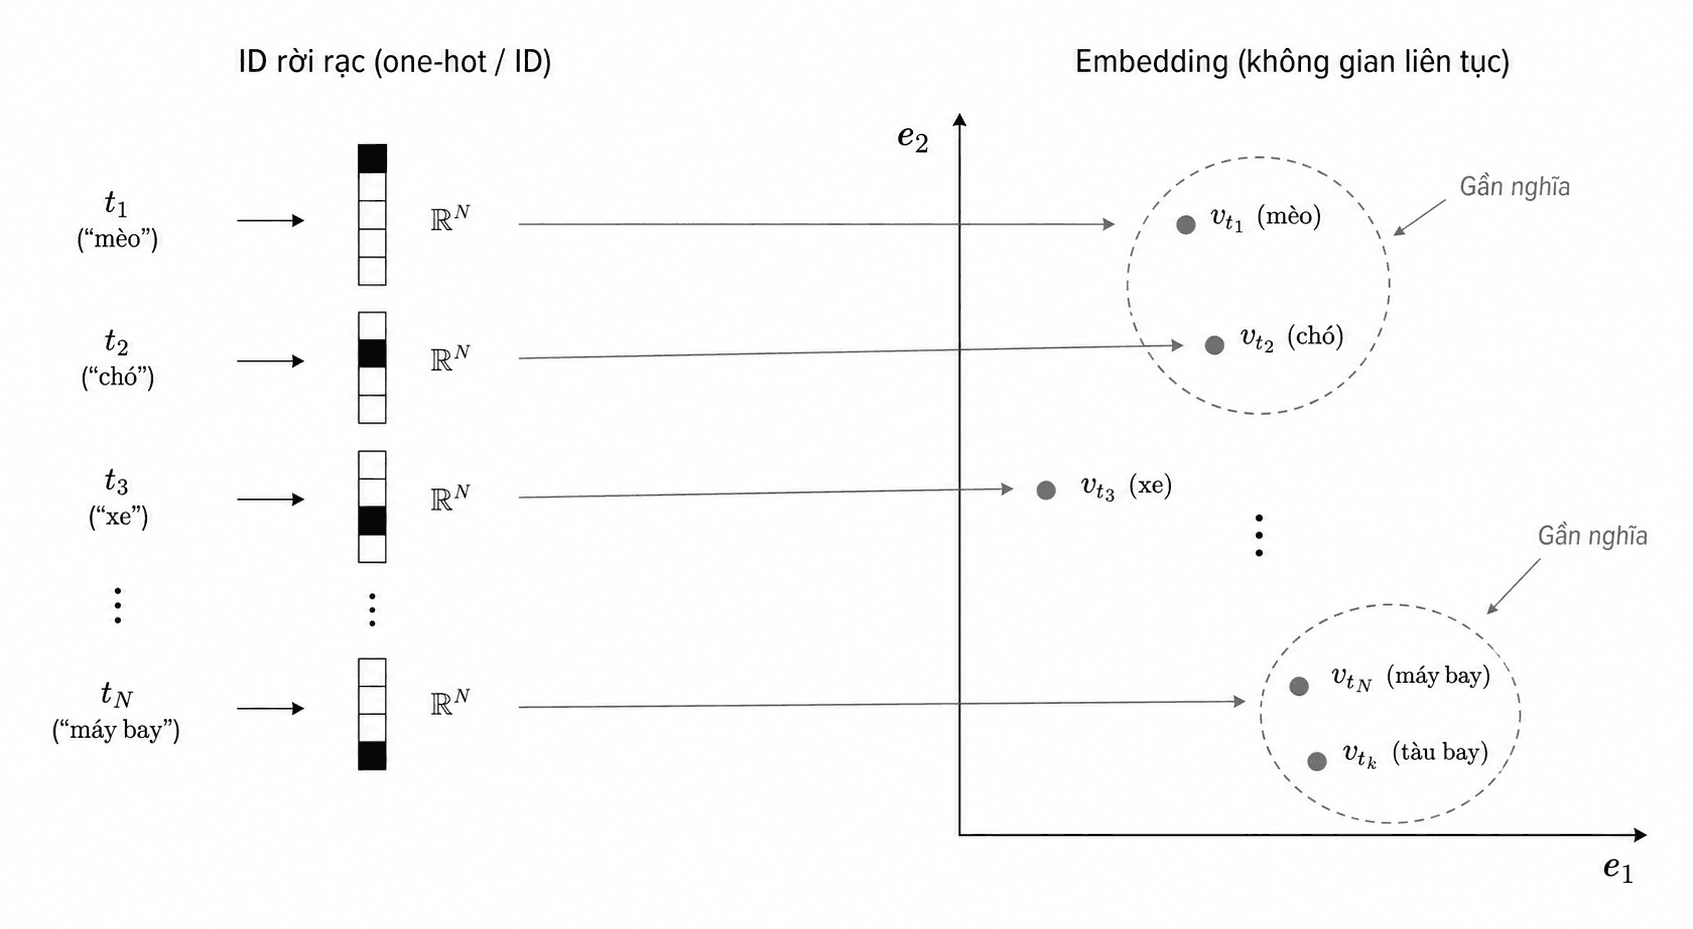
Nội dung thông tin được mã hóa trong vector embedding
Một embedding tốt không cố giữ lại toàn bộ chi tiết của dữ liệu gốc. Nó giữ lại đúng những yếu tố cần cho bài toán phía sau. Nếu bài toán là semantic search, embedding nên nhạy với ý nghĩa của câu và bớt nhạy với những khác biệt bề mặt như thứ tự viết hơi khác, cách dùng từ đồng nghĩa hay biến thể diễn đạt.
Điều này có nghĩa embedding luôn là một dạng nén thông tin có chủ đích. Ta lấy một đối tượng rất giàu cấu trúc, chẳng hạn một đoạn văn dài vài chục từ, rồi ép nó xuống một vector vài trăm hoặc vài nghìn chiều. Mô hình buộc phải học xem phần nào của tín hiệu đáng giữ lại, phần nào có thể bỏ qua.
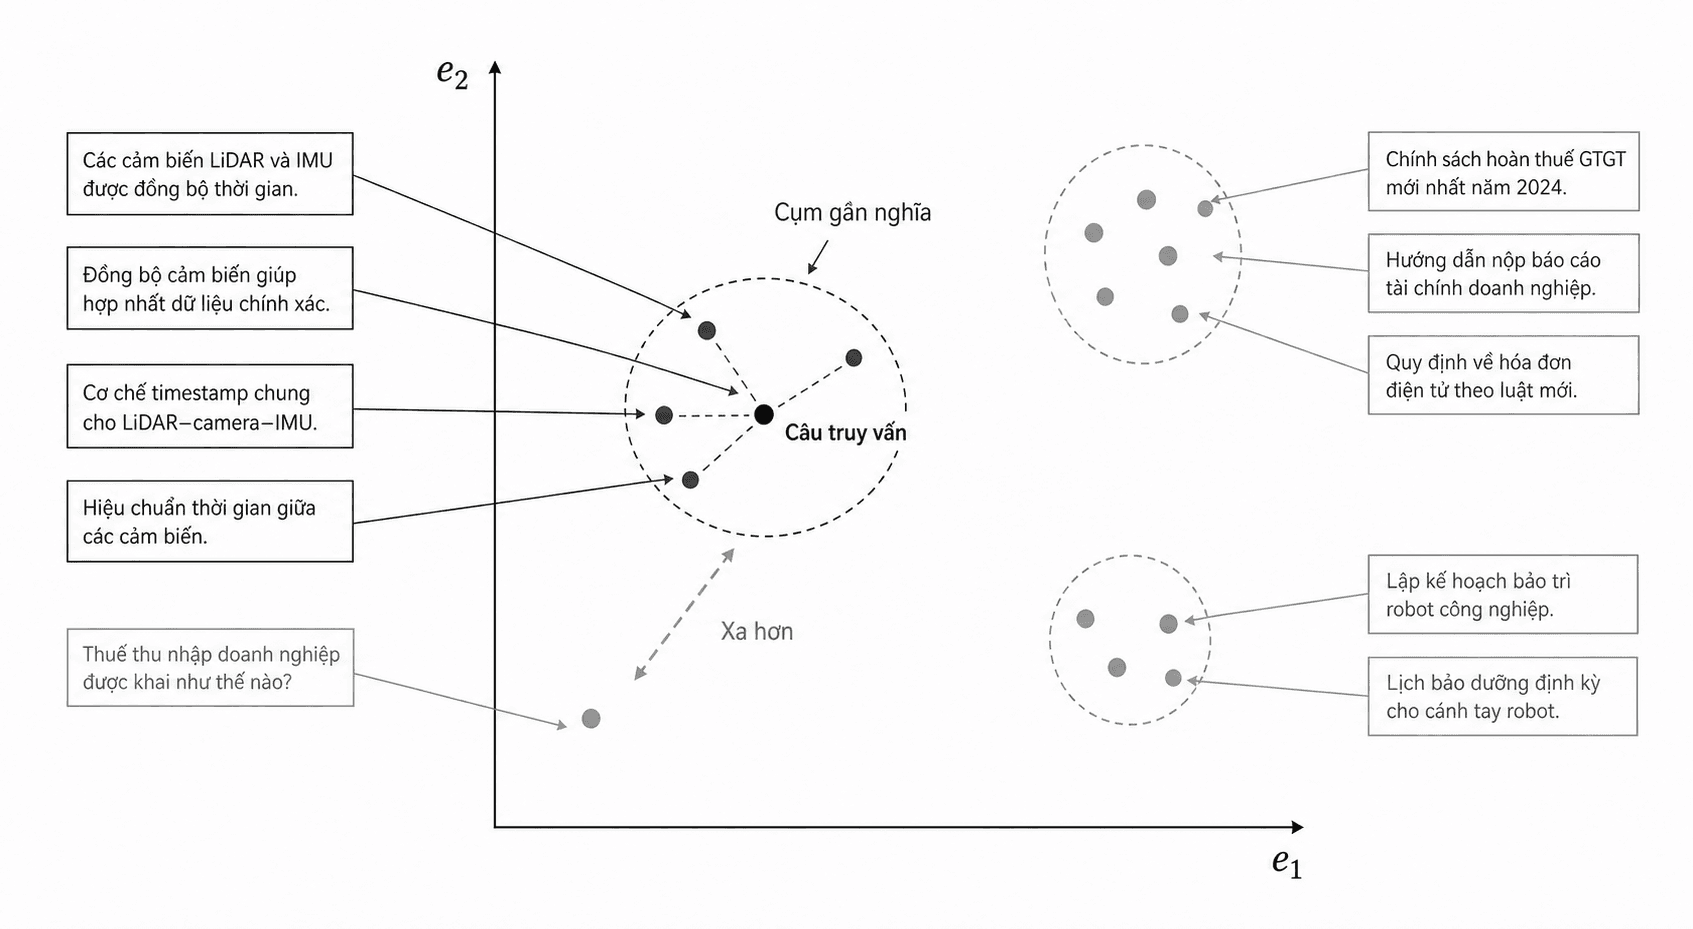
Trong một hệ tìm kiếm tài liệu nội bộ, câu "đồng bộ timestamp giữa camera và IMU" và câu "sửa lệch thời gian cảm biến để fusion ổn định hơn" nên nằm gần nhau. Ngược lại, câu "cấu hình địa chỉ IP cho robot arm" dù có thể cùng xuất hiện trong tài liệu robotics, vẫn nên tách xa hơn vì ý nghĩa vận hành khác hẳn.
Khi nhìn embeddings theo cách đó, ta sẽ thấy ngay một điều quan trọng: không tồn tại embedding "tốt một cách tuyệt đối". Chỉ có embedding phù hợp hay không phù hợp với tác vụ và dữ liệu thật mà ta quan tâm.
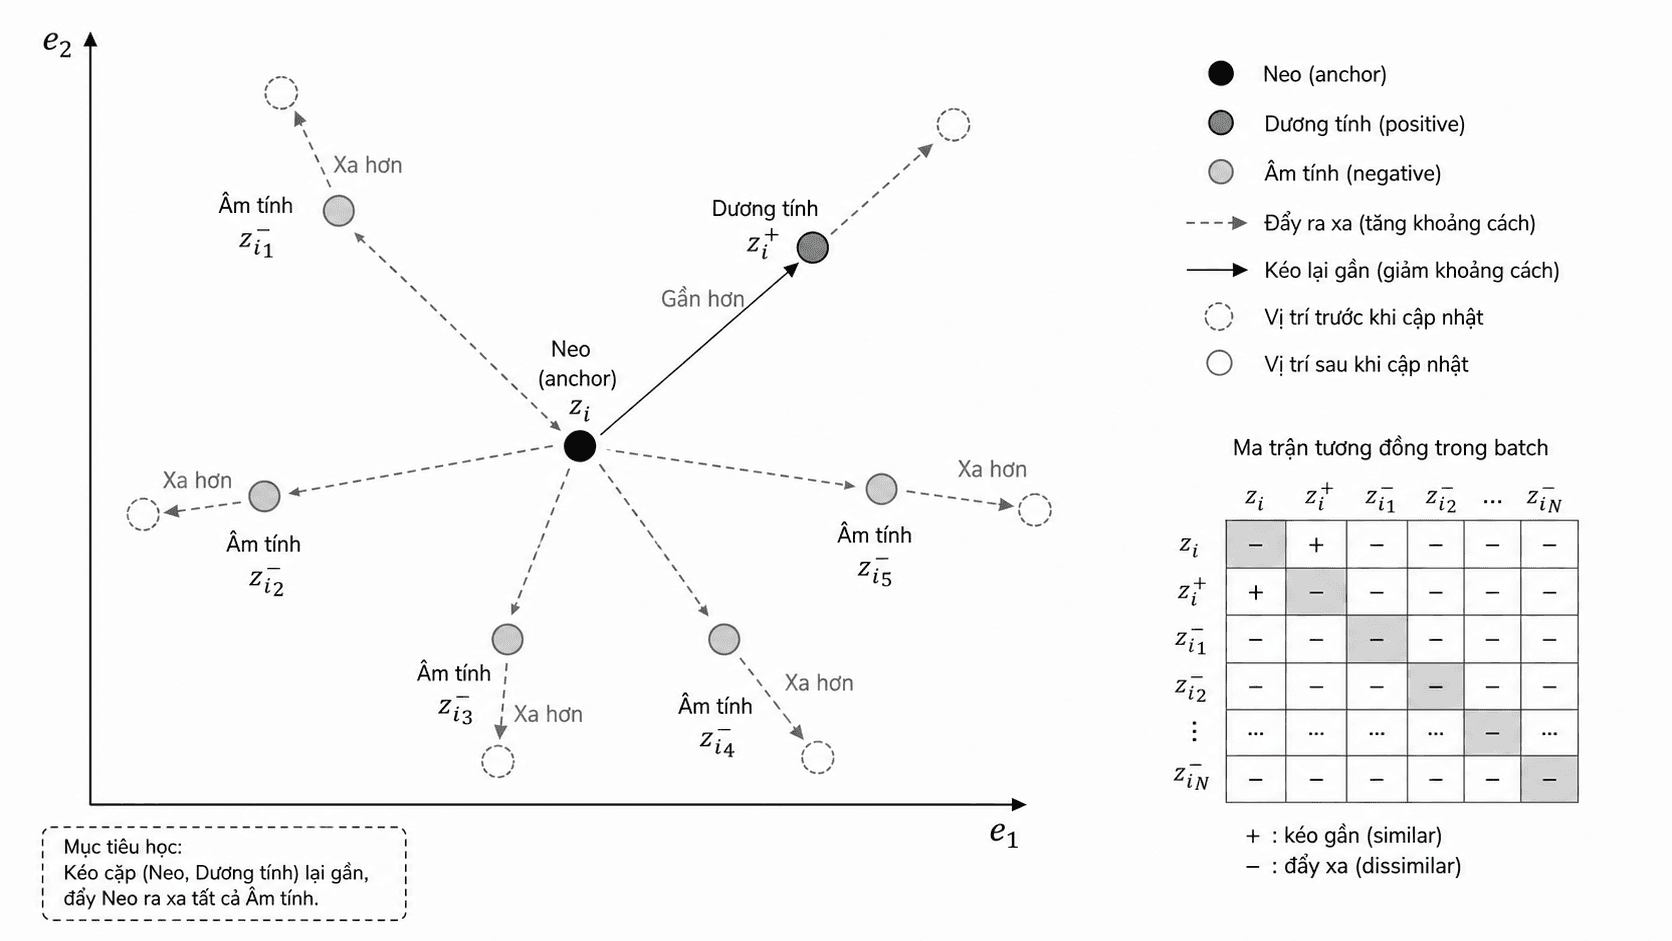
Học không gian embedding bằng contrastive learning
Cách học phổ biến nhất là buộc các cặp liên quan tiến lại gần nhau và các cặp không liên quan tách xa nhau. Với semantic search cho văn bản, một cặp dương tính có thể là truy vấn và đoạn tài liệu đúng. Một cặp âm tính có thể là truy vấn đó ghép với một đoạn tài liệu không liên quan.
Ở mức khái quát, ta có hai vector embedding:
Trong đó:
- là query.
- là document.
- là embedding của query và document.
Một hàm loss rất hay gặp trong contrastive learning là:
Trong đó:
- là embedding của mẫu neo đang xét.
- là embedding của mẫu dương tính tương ứng.
- là các mẫu so sánh trong batch.
- là độ tương tự, thường là cosine similarity hoặc dot product.
- là temperature, điều khiển độ "sắc" của phân bố.
- là số mẫu so sánh trong batch.
Loss này thưởng cho mô hình khi cặp đúng có similarity cao hơn các cặp còn lại. Nếu lặp lại trên rất nhiều ví dụ, mô hình dần học được một không gian mà quan hệ ngữ nghĩa được phản ánh bằng vị trí hình học.
Đây cũng là lý do chất lượng dữ liệu cặp dương và cặp âm quan trọng không kém kiến trúc mô hình. Nếu cặp dương quá lỏng hoặc cặp âm quá dễ, embedding học được sẽ nhìn có vẻ ổn trên dữ liệu huấn luyện nhưng không mang nhiều giá trị khi đưa ra ngoài.
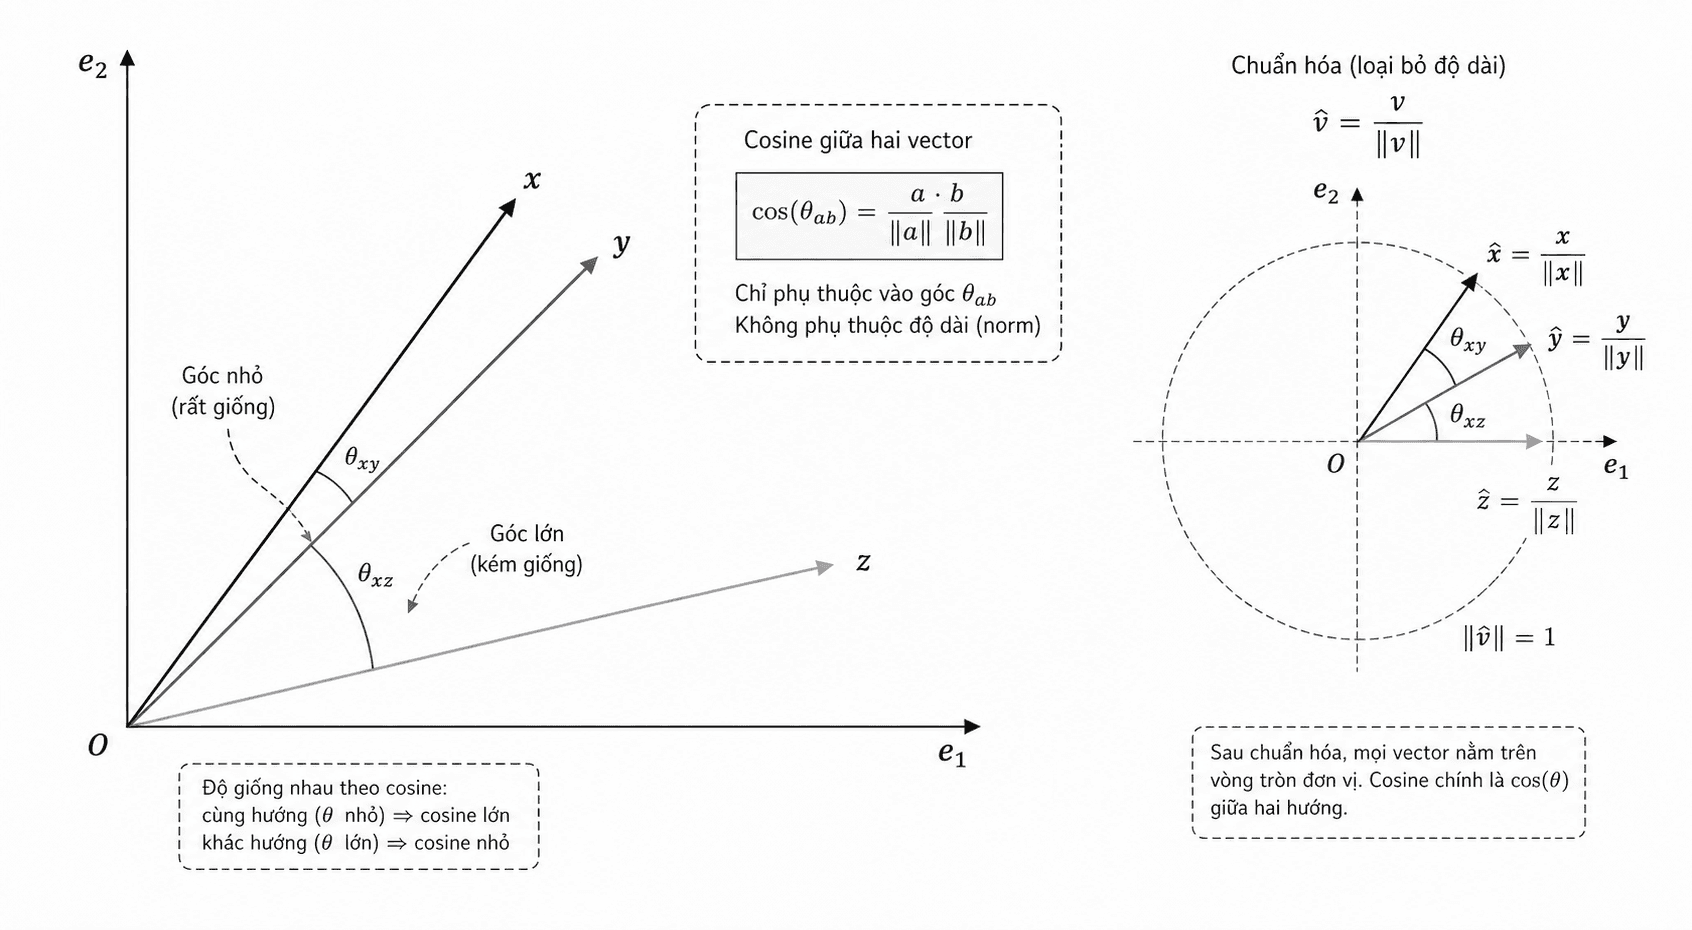
Đo lường độ tương tự trong không gian vector
Khi đã có embedding, ta cần một thước đo để so sánh hai vector. Công thức quen thuộc nhất là cosine similarity:
Trong đó:
- là tích vô hướng giữa hai vector.
- và là chuẩn Euclid của từng vector.
Cosine similarity đo góc giữa hai vector nhiều hơn là độ lớn tuyệt đối của chúng. Điều này thường hợp lý trong các bài toán ngữ nghĩa, vì ta quan tâm xem hai mẫu có cùng hướng biểu diễn hay không, hơn là vector nào có norm lớn hơn.
Nếu các embedding đã được chuẩn hóa về norm bằng 1, khi đó cosine similarity và dot product gần như chỉ khác nhau ở cách viết. Không ít hệ retrieval hiện đại cố ý chuẩn hóa vector để việc so sánh và indexing ổn định hơn.
Một cách nhìn rất trực quan là thế này: embedding không bảo đảm rằng mọi ý nghĩa đều tách thành các cụm tròn trịa, đẹp mắt như trên slide. Nhưng nó cố sắp xếp sao cho những hướng quan trọng đối với bài toán trở nên nhất quán hơn. Khi query "camera latency gây lệch fusion" xuất hiện, nó sẽ trôi về vùng có nhiều đoạn nói về đồng bộ cảm biến, timestamp alignment và sensor fusion instability, thay vì vùng nói về network configuration chỉ vì cùng chứa từ camera.
Triển khai semantic search bằng vector embeddings
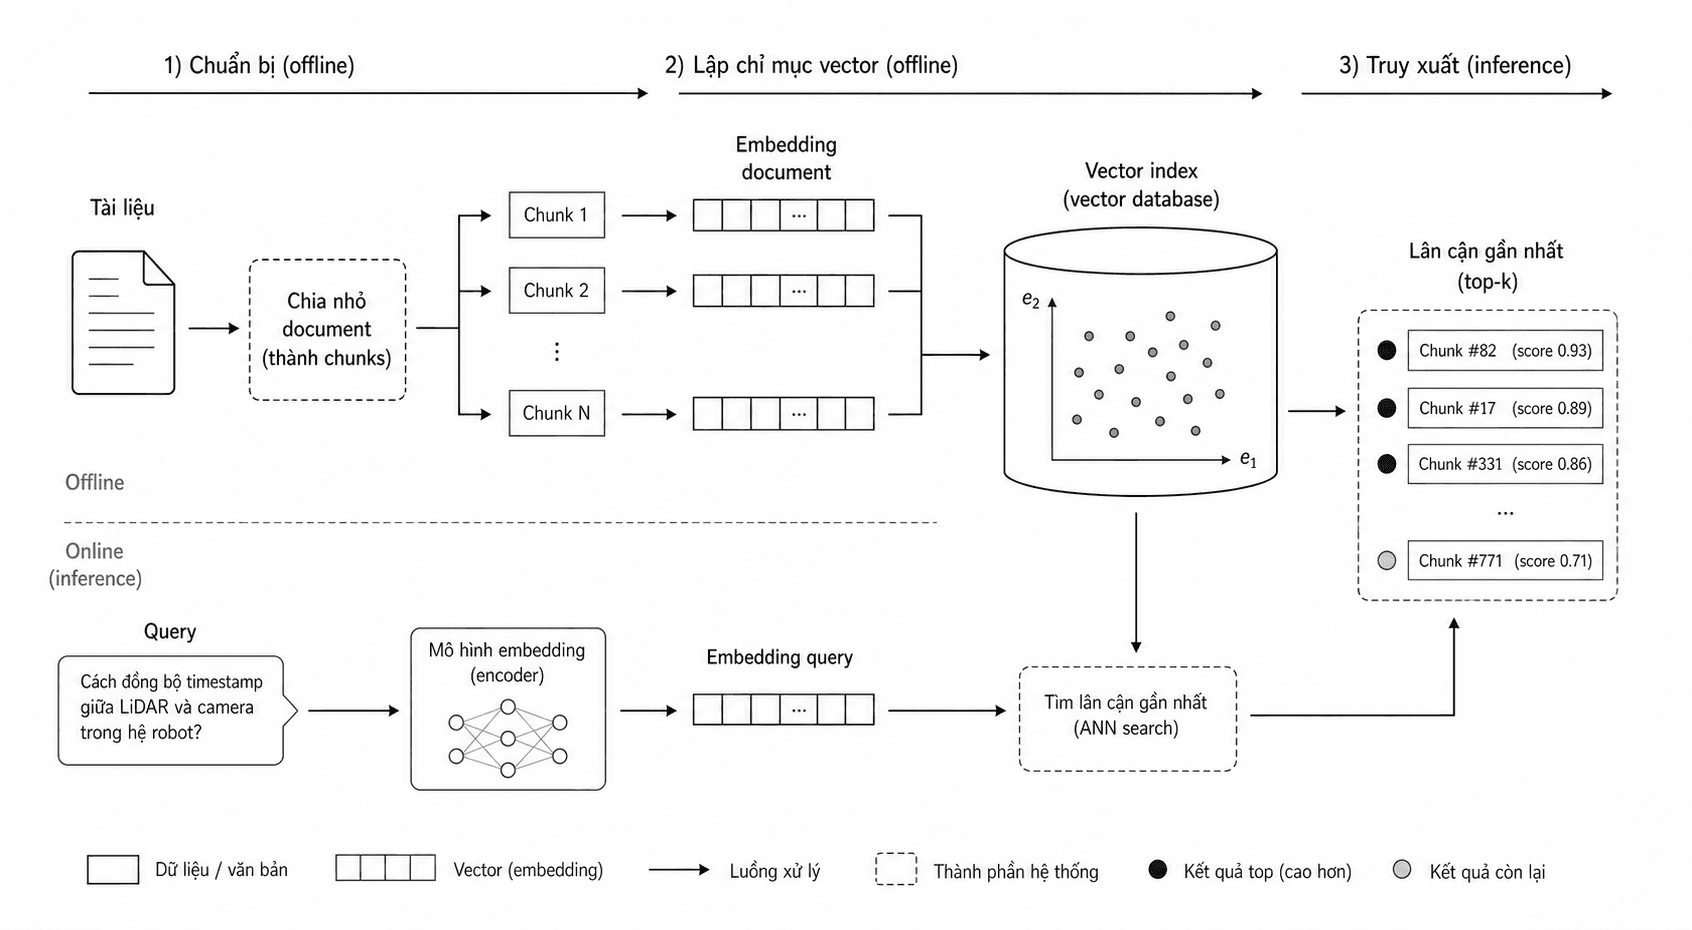
Trong một hệ semantic search, pipeline thường khá thẳng: trước tiên ta chạy toàn bộ kho tài liệu qua embedding model để lấy ra các vector . Các vector này được lưu trong một vector index. Khi người dùng nhập query mới , hệ tính embedding , rồi tìm các vector gần nhất trong kho.
Nếu viết gọn:
Trong đó:
- là tập tài liệu ứng viên.
- là tài liệu thứ .
- là tài liệu được xem là phù hợp nhất theo tiêu chí similarity.
Vấn đề thực dụng xuất hiện ngay khi kho dữ liệu lớn. Với vài trăm vector, ta có thể brute-force. Với vài triệu vector, cách đó trở nên tốn thời gian và bộ nhớ cache. Vì vậy, các hệ thật thường dùng approximate nearest neighbor index như HNSW, IVF hoặc product quantization để đổi lấy tốc độ truy xuất tốt hơn với một mức suy giảm recall chấp nhận được.
Ở đây có một điều rất hay bị bỏ qua: chất lượng search không chỉ phụ thuộc embedding model. Nó còn phụ thuộc cách chia chunk tài liệu, cách tiền xử lý văn bản, cách chọn metric, cách xây index và thậm chí cả cách viết query ở tầng ứng dụng. Nhiều hệ "embedding chưa đủ tốt" thực ra đang gặp vấn đề ở khâu chunking hoặc retrieval pipeline.
Căn chỉnh đa phương thức trong không gian embedding chung
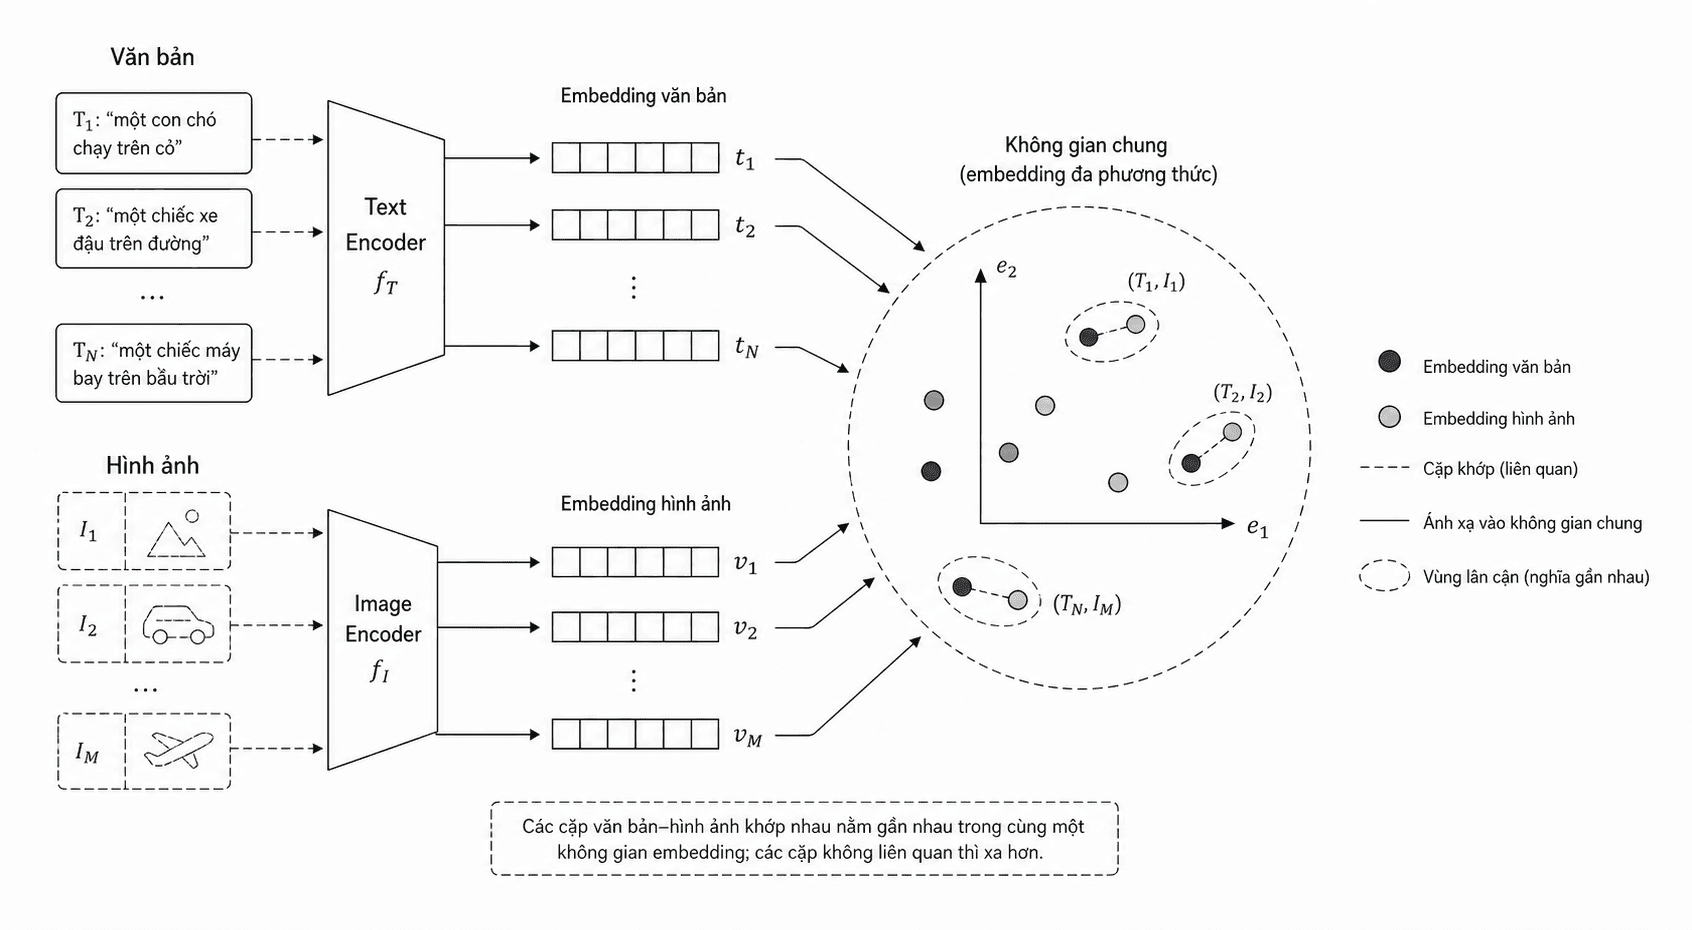
Một bước rất quan trọng của embeddings hiện đại là multimodal alignment. Thay vì chỉ ánh xạ text vào một không gian, ta học để text và image cùng nằm trong một hệ tọa độ chung. Khi đó, ảnh "cánh tay robot đang gắp hộp màu đỏ" và câu mô tả tương ứng có thể ở gần nhau dù đầu vào ban đầu khác hẳn về bản chất.
Nếu ký hiệu:
Trong đó:
- là đầu vào văn bản.
- là đầu vào hình ảnh.
- và là hai encoder khác nhau.
- và là hai embedding sau khi chiếu về cùng không gian so sánh.
Đó là nền của các hệ như CLIP, text-image retrieval và nhiều VLM hiện đại. Trong robotics, cùng tư duy này cũng rất quan trọng vì robot không chỉ nhìn ảnh. Nó còn cần gắn hình ảnh với mô tả nhiệm vụ, với object name, với affordance, hoặc với action mà hệ phía sau sẽ phát ra.
Khi đã quen với ý tưởng "ý nghĩa trở thành hình học", việc hiểu multimodal model sẽ dễ hơn nhiều. Ta chỉ đang mở rộng cùng một nguyên tắc sang nhiều loại dữ liệu khác nhau.
Giới hạn của embeddings trong hệ thống truy xuất thực tế
Embedding rất mạnh, nhưng cũng rất dễ tạo cảm giác "ổn rồi" nếu ta chỉ nhìn vài ví dụ đẹp. Có vài lỗi xảy ra khá thường xuyên.
Lỗi đầu tiên là domain mismatch. Một model học tốt trên dữ liệu web phổ thông chưa chắc hiểu nổi cụm từ rất chuyên ngành như hand-eye calibration, extrinsic drift hay compliance control nếu nó chưa từng thấy đủ nhiều trong ngữ cảnh tương tự.
Lỗi thứ hai là embedding học trúng shortcut bề mặt. Trong kho tài liệu nội bộ, các đoạn thuộc cùng một nhóm có thể dùng chung template trình bày, chung tên project hoặc chung header. Mô hình có thể vô tình học những tín hiệu đó thay vì học ý nghĩa thật.
Lỗi thứ ba là đánh giá quá đơn giản. Chỉ nhìn top-1 retrieval trên vài query mẫu là chưa đủ. Ta cần xem thêm hard negatives, các truy vấn viết lệch cách diễn đạt, dữ liệu mới theo thời gian, và cả các trường hợp người dùng đặt câu hỏi quá ngắn hoặc quá mơ hồ.
Lỗi cuối cùng là nhầm giữa "gần trong embedding space" và "đúng cho tác vụ cuối". Một tài liệu rất gần về ngữ nghĩa chưa chắc là tài liệu nên đưa lên đầu nếu hệ thật còn phải cân bằng tính mới, độ tin cậy, quyền truy cập hoặc ngữ cảnh phiên làm việc hiện tại.
Vì vậy, khi triển khai embeddings trong sản phẩm, ta nên xem chúng như một tầng biểu diễn mạnh nhưng không toàn năng. Điều quan trọng không chỉ là mô hình có sinh ra vector hay không, mà là vector đó có giữ đúng cấu trúc mà bài toán của ta thực sự cần hay không.