PatchCore
Trong ghi chú trước về PaDiM, tôi đã đề cập đến bài toán phát hiện điểm bất thường (Anomaly Detection) bằng cách dạy cho hệ thống biết "trạng thái bình thường trông như thế nào". Chúng ta đã thấy PaDiM giải quyết bài toán này khá tốt bằng cách mô hình hóa phân bố chuẩn (Gaussian) cho từng vùng (patch) trên ảnh.
Tuy nhiên, PaDiM vẫn bộc lộ một số giới hạn chí mạng: nó yêu cầu ảnh đầu vào phải được căn chỉnh vị trí cực kỳ nghiêm ngặt (strict spatial alignment), và dễ bị nhiễu (False Negative) khi bề mặt sản phẩm có kết cấu đa dạng không tuân theo phân bố chuông Gaussian.
Để khắc phục triệt để những điểm yếu đó, trong ghi chú hôm nay, tôi sẽ giới thiệu với bạn một thuật toán đỉnh cao hơn: PatchCore (được đề xuất trong bài báo Towards Total Recall in Industrial Anomaly Detection (opens in a new tab) năm 2021). Hiện tại (2025), PatchCore vẫn đang là một trong những phương pháp nắm giữ vị thế State-of-the-Art trên các bộ dữ liệu benchmark như MVTec AD. Ghi chú này sẽ bóc tách tận cùng từng lớp toán học và cấu trúc của PatchCore, để xem nó đã vượt qua cái bóng của PaDiM như thế nào.
Ý tưởng cốt lõi: Memory Bank thay vì Thống kê
Điểm yếu chí mạng của PaDiM là giả định dữ liệu bình thường tuân theo phân bố chuẩn đa chiều (Multivariate Gaussian). Thực tế, hoa văn bề mặt sản phẩm đôi khi rất phức tạp và phân bố thành nhiều cụm (multi-modal) không hề tuân theo hình chuông Gaussian. Việc ép một phân bố phức tạp vào một ma trận Hiệp phương sai (Covariance Matrix) duy nhất sẽ làm mất đi nhiều chi tiết quan trọng.
Hãy tưởng tượng bạn đang kiểm tra các con ốc vít. Trong tập dữ liệu chuẩn, một con ốc vít có thể xuất hiện dưới hai dạng: mặt trên (đầu chữ thập) hoặc mặt ngang (ren xoắn). Trong không gian đặc trưng, hai dạng này sẽ tạo thành hai cụm dữ liệu nằm xa nhau (phân bố đa cụm - multi-modal). Khi PaDiM cố gắng dùng một phân bố Gaussian duy nhất để tóm tắt dữ liệu này, nó sẽ vẽ một "đám mây" hình chuông khổng lồ bao trọn cả cụm "mặt trên" và "mặt ngang". Vấn đề là vùng trống nằm giữa hai cụm đó hoàn toàn không chứa dữ liệu chuẩn nào, nhưng PaDiM vẫn coi đó là vùng "bình thường". Nếu một vết xước tạo ra đặc trưng rơi đúng vào vùng trống này, PaDiM sẽ bỏ sót lỗi (False Negative). Việc ép một phân bố phức tạp vào một ma trận Hiệp phương sai (Covariance Matrix) duy nhất đã vô tình làm mất đi ranh giới của sự bình thường.
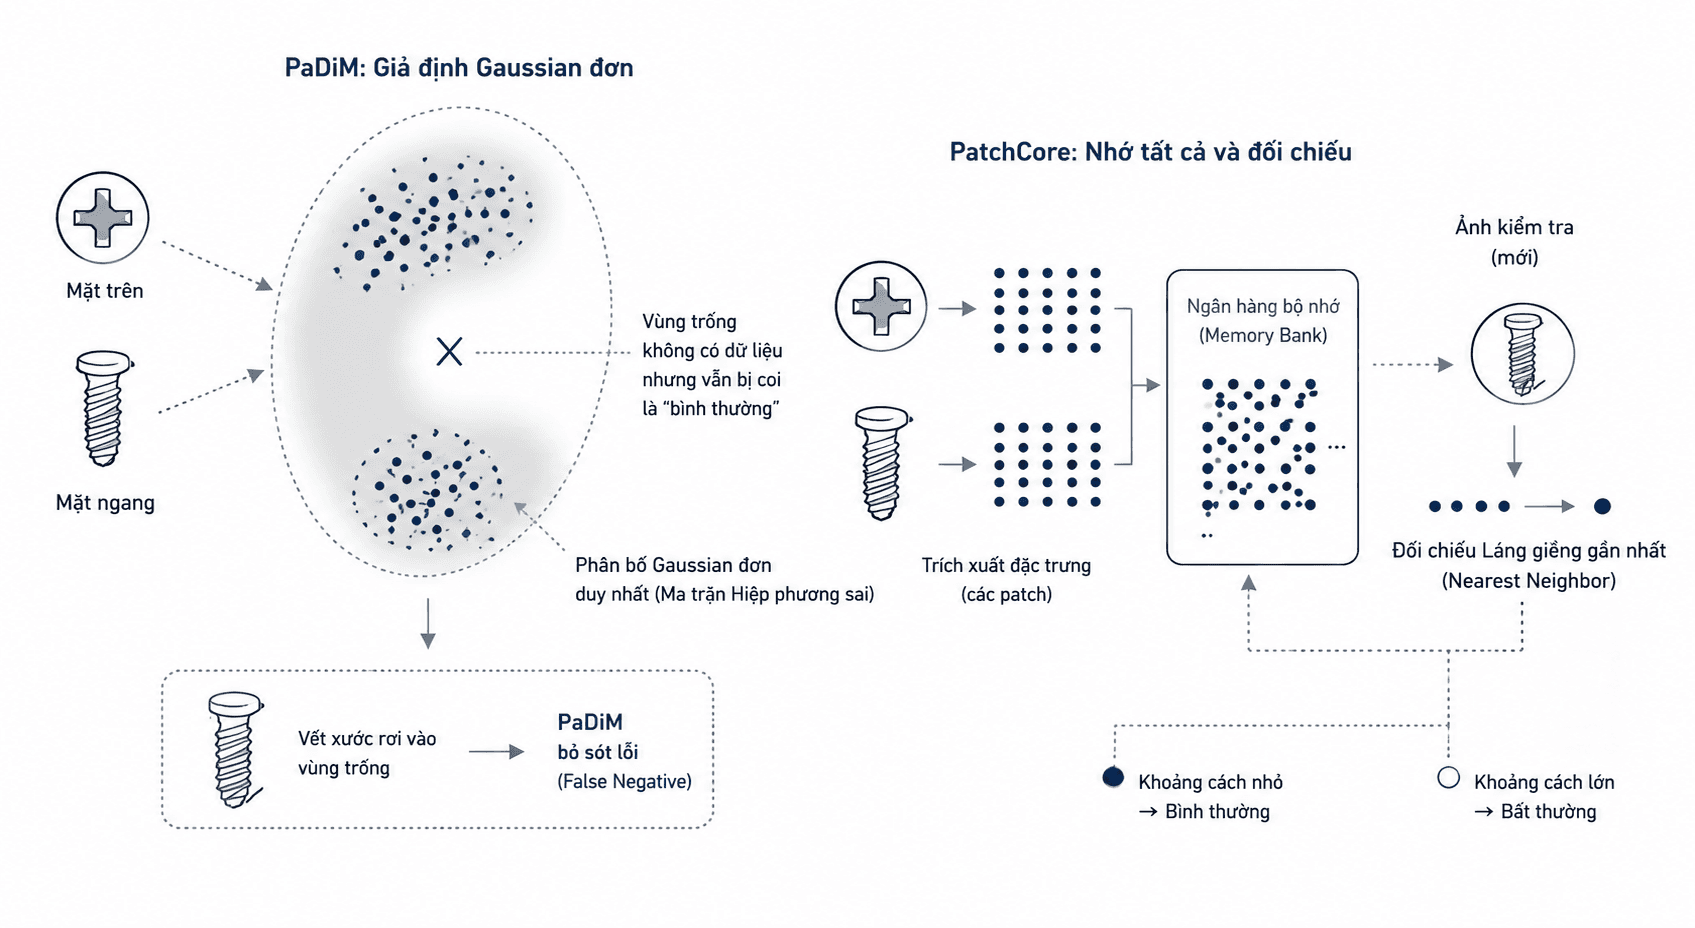
PatchCore giải quyết triệt để điều này bằng cách từ bỏ hoàn toàn việc nén dữ liệu thành các công thức thống kê. Thay vào đó, thuật toán trích xuất đặc trưng (feature) của tất cả các patch từ ảnh bình thường và lưu "sống" chúng vào một Ngân hàng bộ nhớ (Memory Bank). Bạn có thể coi PatchCore sở hữu một "trí nhớ nhiếp ảnh" (photographic memory), ghi nhớ chính xác từng điểm dữ liệu mà không cần nội suy hay tính trung bình.
Khi kiểm tra một ảnh mới, PatchCore cắt ảnh thành các vùng nhỏ (patch) và dùng thuật toán Láng giềng gần nhất (Nearest Neighbor) để đối chiếu. Thuật toán sẽ cầm từng patch của ảnh test và hỏi Ngân hàng bộ nhớ: "Trong hàng triệu patch bình thường mày từng học, có cái nào giống y hệt cái này không?". Giống như việc bạn nhặt một mảnh ghép hình và cố gắng đối chiếu với một kho chứa hàng triệu mảnh ghép mẫu. Nếu mảnh ghép đó không thể tìm thấy bất kỳ mảnh nào tương đồng (khoảng cách Nearest Neighbor quá lớn), hệ thống sẽ ngay lập tức gán nhãn mảnh đó là điểm bất thường. Cách tiếp cận "nhớ tất cả và đối chiếu" này giúp PatchCore bắt được cả những lỗi tinh vi nhất mà không bị đánh lừa bởi hình dạng phân bố dữ liệu.
Tuy nhiên, câu hỏi đặt ra là: "Mảnh ghép" (patch) ở đây thực chất là gì? Chúng không phải là những điểm ảnh (pixel) thô cắt vật lý từ bức hình, vì pixel rất dễ bị nhiễu bởi ánh sáng. Mảnh ghép ở đây phải là các vector đặc trưng giàu ngữ nghĩa. Vậy làm thế nào để biến một bức ảnh thành tập hợp các mảnh ghép cấp cao như vậy? Đó chính là nhiệm vụ của bước đầu tiên: Trích xuất đặc trưng.
Trích xuất đặc trưng cục bộ (Local Feature Extraction)
Lựa chọn mạng và tầng trích xuất
Đầu tiên, hình ảnh (ví dụ kích thước ) được đưa qua một mạng CNN pretrained như ResNet hoặc WideResNet.
Việc lựa chọn tầng (layer) nào trong mạng CNN để trích xuất đặc trưng mang tính quyết định. Nếu chọn tầng quá nông (như Layer 1), đặc trưng thu được chỉ là các đường nét hoặc màu sắc thô, chứa nhiều nhiễu và thiếu ngữ cảnh xung quanh. Ngược lại, nếu chọn tầng quá sâu (như Layer 4), feature map bị thu nhỏ quá mức (ví dụ chỉ còn ). Ở độ phân giải thấp này, thông tin không gian bị mất hoàn toàn; mô hình có thể nhận biết bức ảnh có lỗi, nhưng không thể định vị chính xác vết xước mảnh 1mm nằm ở tọa độ nào.
Do đó, PatchCore sử dụng tầng trung gian (mid-level features), cụ thể là ghép Layer 2 và Layer 3 của mạng ResNet.
- Qua Layer 2, ta thu được feature map kích thước với 512 channels (chiều sâu).
- Qua Layer 3, ta thu được feature map kích thước với 1024 channels.
Làm sao để ghép hai khối có kích thước bề mặt khác biệt ( và ) này lại với nhau? Hãy tưởng tượng bạn đang có hai tấm bản đồ: một tấm lớn và một tấm nhỏ gọn. Bạn không thể dập ghim chúng lại với nhau nếu các mép không khớp.
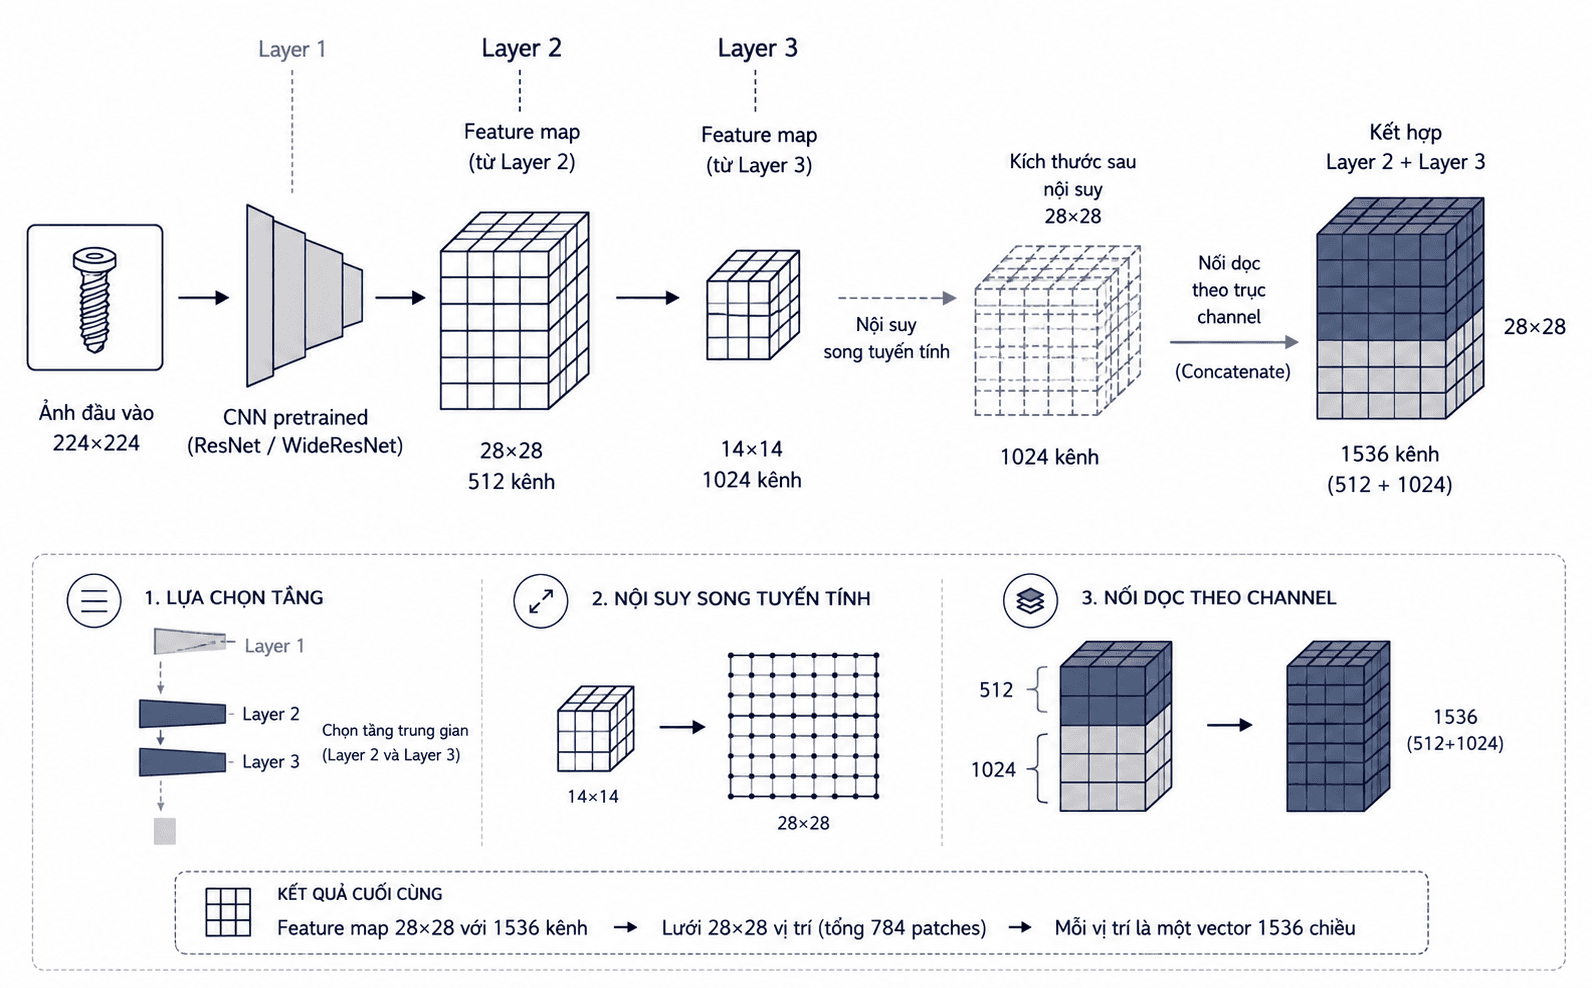
Để giải quyết, thuật toán dùng kỹ thuật nội suy song tuyến tính (Bi-linear Interpolation). Về mặt hình ảnh, nó giống như việc bạn cầm tấm bản đồ và "kéo giãn" nó ra cho to bằng , thuật toán sẽ tự động tính toán và điền thêm các điểm ảnh bị khuyết dựa trên các điểm xung quanh để không làm vỡ hình.
Khi cả hai khối đã có chung mặt bằng , thao tác tiếp theo là đặt chúng lên nhau và nối dọc theo chiều sâu (concatenate dọc trục channel). Bạn có khối thứ nhất dày 512 lớp, và khối thứ hai dày 1024 lớp. Chồng khít chúng lên nhau, bạn sẽ thu được một khối dữ liệu (Tensor) duy nhất có kích thước không gian , và có độ sâu tổng cộng là lớp đặc trưng. Nghĩa là trên bức ảnh, ta có lưới vị trí (tổng 784 patches), mỗi vị trí là một vector 1536 chiều cực kỳ giàu thông tin.
Cấu trúc Locally Aware Patch Features
Đến bước trên, tại mỗi tọa độ trên lưới , ta có một vector 1536 chiều mô tả vùng ảnh tại đó. Nhìn về mặt toán học thì có vẻ hoàn hảo, nhưng thực tế lại nảy sinh một vấn đề: Ngữ cảnh (Context).
Hãy tưởng tượng một vector đặc trưng báo hiệu rằng nó đang nhìn thấy "một đoạn thẳng". Nếu chỉ đứng đơn lẻ, hệ thống sẽ không thể biết đoạn thẳng đó là: (A) Lề bình thường của thiết kế sản phẩm, hay (B) Một vết xước dài vạch ngang trên một bề mặt vốn dĩ phải nhẵn mịn. Cách duy nhất để phân biệt là nhìn sang các vùng lân cận xung quanh nó.
Để giúp mỗi patch không bị "mù" với môi trường xung quanh, PatchCore áp dụng một kỹ thuật rất đơn giản nhưng hiệu quả: Average Pooling 2D (với kernel , stride , padding ).
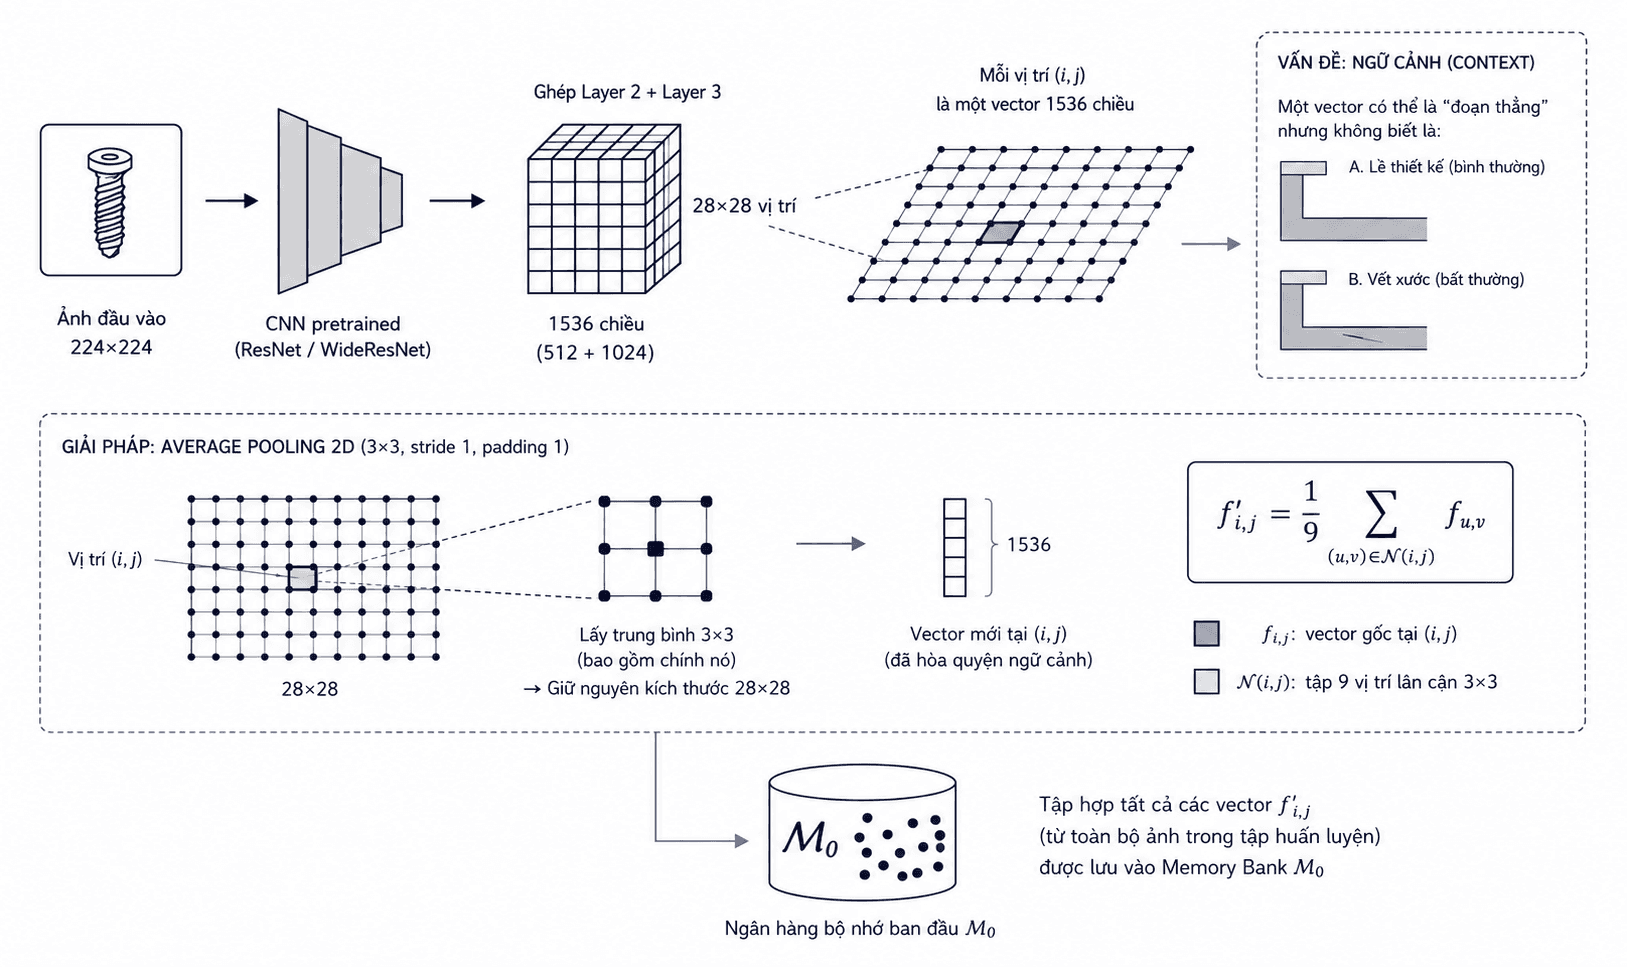
Hiểu một cách trực quan, thuật toán sẽ đi đến từng ô tọa độ trên lưới . Nó gom vector của chính ô đó cùng với 8 ô láng giềng xung quanh (tạo thành một khối ), đem tất cả cộng lại rồi chia trung bình. Do sử dụng cấu hình stride và padding , kích thước của lưới không hề bị teo nhỏ (vẫn giữ nguyên ), nhưng lúc này, nội dung bên trong mỗi vector đã mang thêm "hơi hướng" của 8 hàng xóm xung quanh nó.
Về mặt công thức chính thức trong bài báo, quá trình hòa quyện này được viết là:
Trong đó, là các vector đặc trưng ban đầu, và chính là tập hợp 9 tọa độ lân cận xung quanh .
Chính nhờ cơ chế "Locally Aware" này, vector mới đủ khả năng phân biệt rạch ròi giữa một đường vân mép bình thường và một vết xước lạ. Tập hợp tất cả các vector đã được hòa quyện này (từ toàn bộ ảnh trong tập huấn luyện) sẽ được đổ chung vào một cái thùng lớn, tạo thành Ngân hàng bộ nhớ ban đầu .
Coreset Subsampling: Bài toán tối ưu hóa Min-Max
Như đã phân tích ở trên, mỗi bức ảnh đầu vào sau khi qua mạng CNN sẽ sinh ra một lưới không gian , tương đương với việc cung cấp đúng vector đặc trưng (patch features).
Ở giai đoạn huấn luyện, ta phải gom toàn bộ số vector này từ tất cả các ảnh mẫu để ném vào Ngân hàng bộ nhớ . Hãy làm một phép tính nhỏ: Nếu dây chuyền của bạn cung cấp 10.000 ảnh sản phẩm bình thường để huấn luyện, ngân hàng bộ nhớ sẽ phải chứa tới triệu vector (mỗi vector lại mang 1536 chiều dữ liệu). Hậu quả là dung lượng RAM sẽ bùng nổ, và nghiêm trọng hơn, thuật toán đối chiếu láng giềng gần nhất (Nearest Neighbor) ở quá trình test sẽ chạy chậm như rùa bò vì phải quét qua một khối dữ liệu khổng lồ như vậy.
Giải pháp lấy mẫu ngẫu nhiên (Random Sampling) để giảm bớt kích thước bộ nhớ thường không mang lại hiệu quả. Giả sử 95% diện tích bề mặt sản phẩm là vùng nền phẳng nhẵn (chứa các vector đặc trưng giống hệt nhau), và chỉ 5% là phần viền ốc vít phức tạp mang giá trị cốt lõi. Nếu hệ thống nhắm mắt lấy ngẫu nhiên 1%, nó rất dễ bốc toàn bộ vector đại diện cho nền phẳng và bỏ sót hoàn toàn viền ốc vít. Hậu quả là khi test thực tế, hệ thống sẽ liên tục báo lỗi giả (False Positive) ngay trên những con ốc vít bình thường.
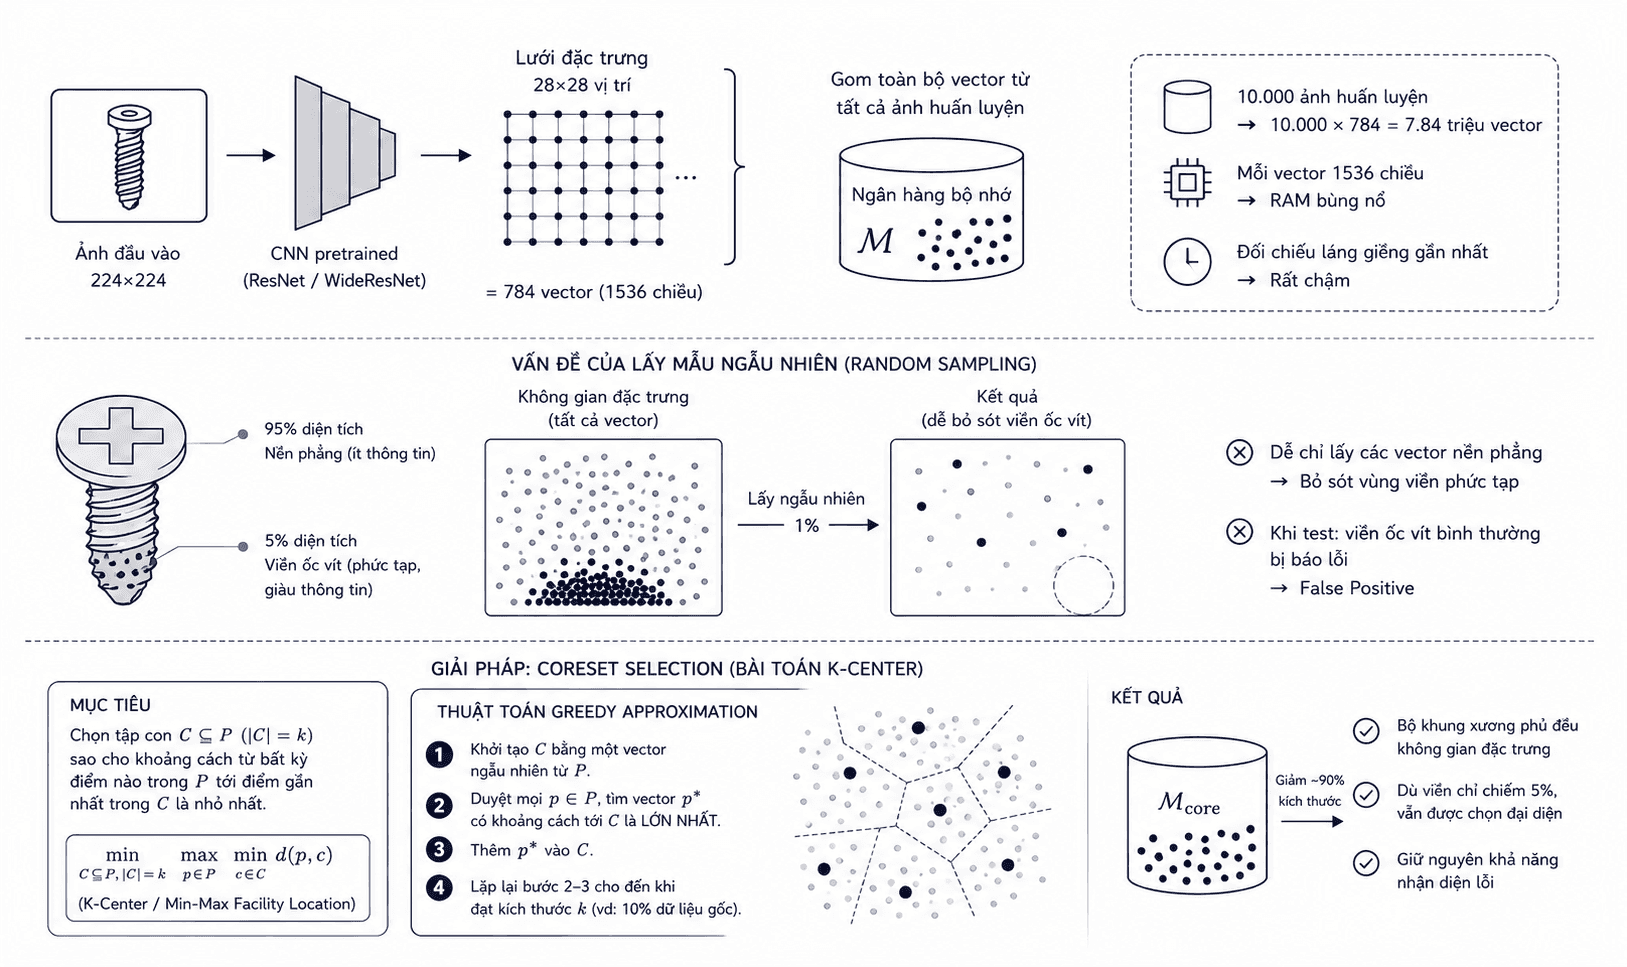
Để giải quyết, PatchCore áp dụng bài toán Coreset Selection, mục tiêu là tìm tập con sao cho khoảng cách từ bất kỳ điểm nào trong tới điểm gần nhất trong là nhỏ nhất. Về mặt toán học, đây là bài toán K-Center (Min-Max Facility Location):
Vì bài toán này là NP-Hard, PatchCore sử dụng thuật toán Greedy Approximation (K-Center Greedy):
- Khởi tạo bằng một vector ngẫu nhiên từ .
- Vòng lặp: Duyệt mọi vector , tìm vector cô lập nhất (tức là vector có khoảng cách ngắn nhất đến là LỚN NHẤT).
- Đưa vector cô lập đó vào và lặp lại cho đến khi đạt kích thước mong muốn (ví dụ 10% dữ liệu gốc).
Cách này tạo ra một "bộ khung xương" trải đều khắp không gian đặc trưng. Dù viền ốc vít chỉ chiếm 5%, hệ thống vẫn bắt buộc phải chọn ra các vector đại diện cho nó vì chúng nằm xa vùng nền phẳng. Kết quả: Bộ nhớ giảm 90% nhưng khả năng nhận diện không hề bị suy giảm.
Tính điểm bất thường (KNN Reweighting) và Anomaly Map
Đến đây, quá trình huấn luyện đã kết thúc với "thành quả" là một Ngân hàng bộ nhớ cô đọng . Bây giờ, hệ thống được đưa lên băng chuyền thực tế. Khi một sản phẩm mới chạy qua camera, làm thế nào để PatchCore chấm điểm lỗi và khoanh vùng vết xước?
Đầu tiên, bức ảnh test cũng được đưa qua mạng CNN để trích xuất ra tập hợp 784 patch đặc trưng, gọi là . Với mỗi patch của ảnh test, thuật toán sẽ tra cứu trong Ngân hàng bộ nhớ để tìm ra patch mẫu giống nó nhất. Khoảng cách thô (ngắn nhất) này được tính bằng công thức:
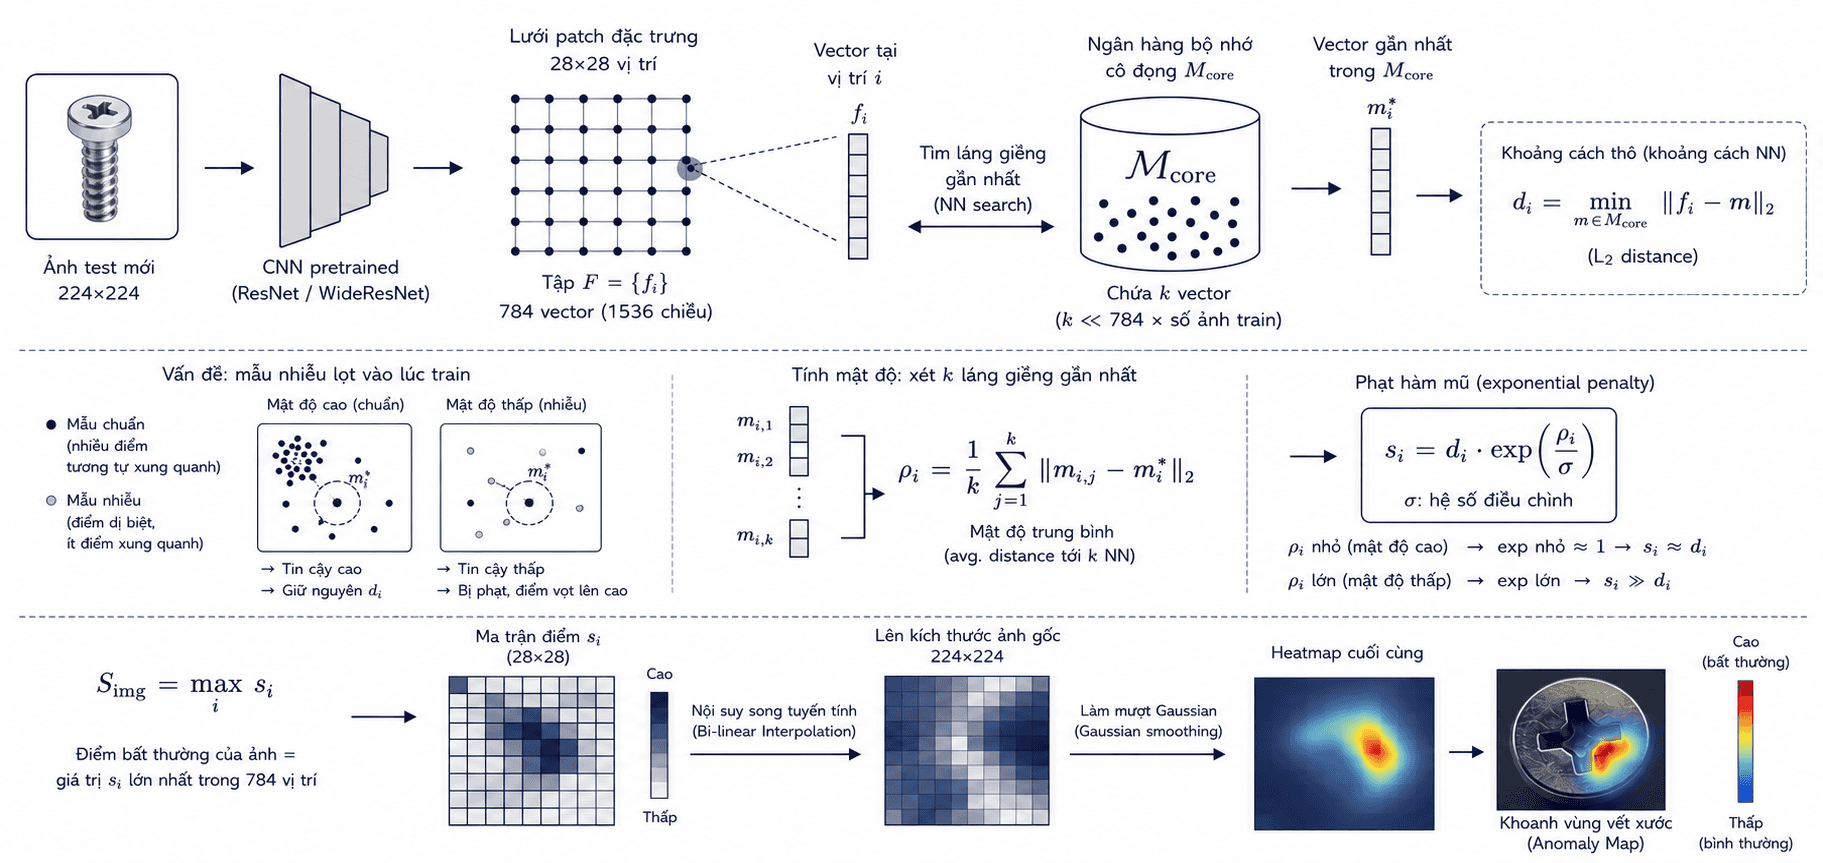
Nhưng trong thực tế công nghiệp, nếu chỉ dùng khoảng cách thô thì rất nguy hiểm do vấn đề nhiễu dữ liệu huấn luyện.
Hãy tưởng tượng một kịch bản: Trong lúc thu thập 10.000 ảnh "bình thường" để huấn luyện, có một sản phẩm bị xước nhỏ vô tình lọt vào. Vết xước này được lưu vào Ngân hàng bộ nhớ dưới dạng một patch mẫu .
Khi chạy thực tế, một sản phẩm test thực sự bị xước () đi qua. Nó tra cứu trong Ngân hàng bộ nhớ và ngay lập tức khớp hoàn hảo với điểm nhiễu kia. Khoảng cách lúc này tiến về 0. Nếu hệ thống chỉ dựa vào , nó sẽ kết luận: "Ồ, tôi tìm thấy mẫu giống hệt trong tập bình thường rồi, sản phẩm này KHÔNG CÓ LỖI!". Đây là một pha bỏ lọt lỗi (False Negative) tai hại.
Để triệt tiêu rủi ro này, PatchCore áp dụng cơ chế Phạt mật độ (Density-Aware Reweighting). Trước khi tin tưởng , thuật toán sẽ kiểm tra "mật độ láng giềng" của trong Ngân hàng bộ nhớ bằng cách xét thêm vector gần nó nhất:
- Nếu là một đặc trưng chuẩn (ví dụ: mép ốc vít), sẽ có hàng ngàn mép ốc vít tương tự nằm ken đặc xung quanh nó trong không gian đặc trưng. Mật độ cao Độ tin cậy cao Điểm khoảng cách được giữ nguyên.
- Nếu là vết xước vô tình lọt vào lúc train, nó sẽ là một điểm dị biệt đứng cô lập (mật độ cực kỳ thưa thớt). Thuật toán lập tức phát hiện sự bất thường này và giáng một đòn "phạt" bằng hệ số hàm mũ, bẩy điểm lỗi vọt lên cao bất chấp khoảng cách có nhỏ đến đâu.
Công thức phạt hàm mũ (exponential penalty) chính thức:
Cuối cùng, điểm bất thường của bức ảnh (Image Anomaly Score) là:
Để có được một Anomaly Map chính xác:
- Ma trận chứa các giá trị được nội suy song tuyến tính (Bi-linear Interpolation) lên lại kích thước ảnh gốc .
- Chạy qua bộ lọc làm mượt (Gaussian smoothing) để xóa các đường viền gãy góc.
Ta thu được một Heatmap hoàn chỉnh, chỉ rõ ràng từng mm vùng bị lỗi.
So sánh PatchCore và PaDiM: Tại sao PatchCore lại là "Tiêu chuẩn vàng"?
Nếu bạn đã theo dõi bài toán phát hiện điểm bất thường (Anomaly Detection), chắc chắn bạn sẽ thấy hai cái tên PaDiM và PatchCore luôn được đặt lên bàn cân. Để hiểu tại sao PatchCore hiện nay lại được giới công nghiệp coi là lựa chọn mặc định (default choice), hãy cùng nhìn vào bảng phân tích sự đánh đổi dưới đây:
| Tiêu chí | Mô hình PaDiM | Mô hình PatchCore (State-of-the-Art) |
|---|---|---|
| Giả định dữ liệu | Phân bố chuẩn hình chuông (Gaussian) | Vector đặc trưng rời rạc (Memory Bank) |
| Bề mặt phức tạp (Multi-modal) | Dễ sinh "vùng mù", bỏ lọt lỗi (False Negative) | Bảo toàn ranh giới gốc, bắt lỗi tinh vi cực tốt |
| Ràng buộc vị trí (Spatial Alignment) | Rất khắt khe (Cố định theo tọa độ pixel) | Linh hoạt tuyệt đối (Không phụ thuộc tọa độ) |
| Sử dụng bộ nhớ (RAM) | Rất nhẹ (Chỉ lưu ma trận thống kê) | Nặng hơn (Đã được nén bằng Coreset) |
| Tốc độ suy luận (Inference) | Cực kỳ nhanh | Cần OpenVINO/FAISS để đạt Real-time |
| Môi trường ứng dụng | Đồ gá cố định, sai lệch dưới 1mm | Băng tải tự do, sản phẩm có thể xê dịch |
Nhìn vào bảng trên, ta thấy PaDiM thắng tuyệt đối về mặt tài nguyên phần cứng (nhẹ và nhanh). Tuy nhiên, nó lại mang một lỗ hổng quá lớn về mặt thực tiễn: Sự ràng buộc vị trí. Trên dây chuyền nhà máy, việc đảm bảo một sản phẩm luôn nằm chính xác đến từng milimet là điều cực kỳ tốn kém, đòi hỏi thiết kế hệ thống cơ khí và đồ gá (jig) phức tạp. Hơn nữa, việc ép dữ liệu vào phân bố Gaussian khiến PaDiM dễ bị "lừa" bởi các bề mặt họa tiết đa dạng.
PatchCore ra đời, chấp nhận đánh đổi tốc độ và RAM để giải phóng hoàn toàn sự trói buộc cơ học này. Tuy nhiên, bạn có thể đặt câu hỏi: "Khâu trích xuất đặc trưng bằng mạng CNN của PatchCore và PaDiM là giống hệt nhau (đều trôi qua các layer của ResNet), vậy tại sao PatchCore lại chậm hơn và cần tới OpenVINO?".
Sự chênh lệch tốc độ này hoàn toàn không nằm ở khâu trích xuất CNN, mà nằm ở khâu chấm điểm lỗi (Inference):
- Ở PaDiM, việc tính điểm lỗi chỉ là một phép nhân ma trận đại số cơ bản (Khoảng cách Mahalanobis) với một ma trận hiệp phương sai đã lưu sẵn. Phép tính này cực kỳ nhẹ (Độ phức tạp ) và ra kết quả ngay lập tức.
- Ở PatchCore, để chấm điểm một vùng ảnh test, hệ thống bắt buộc phải thực hiện thuật toán K-Nearest Neighbors (KNN). Tức là nó phải lật tung toàn bộ Ngân hàng bộ nhớ để quét và tính khoảng cách (Euclidean) với hàng trăm ngàn vector mẫu nhằm tìm ra điểm láng giềng gần nhất. Phép toán duyệt tuần tự này có độ phức tạp , và nó chính là "nút thắt cổ chai" làm CPU bị nghẽn.
Do đó, các thư viện tìm kiếm vector chuyên dụng như FAISS hay công cụ tăng tốc biên dịch phần cứng như OpenVINO được sử dụng không phải để tăng tốc quá trình chạy CNN, mà mục đích duy nhất của chúng là tối ưu hóa phần cứng để ép tốc độ quét/truy xuất khổng lồ của thuật toán KNN xuống mức vài mili-giây.
Nhờ sự hỗ trợ đắc lực này, nhược điểm duy nhất của PatchCore (sự ì ạch của KNN) đã bị xóa nhòa hoàn toàn. Kết hợp với tính linh hoạt tuyệt đối trong không gian, PatchCore chính thức vươn lên thành "Tiêu chuẩn vàng" cho mọi hệ thống kiểm tra ngoại quan (Visual Inspection) hiện đại.
Triển khai thực tế
Hiểu được toán học và kiến trúc đằng sau PatchCore là một chuyện, nhưng việc lập trình từ con số 0 để mang những công thức này lên băng chuyền lại là một thách thức hoàn toàn khác. Việc tự viết lại bài toán NP-Hard K-Center Greedy hay tối ưu hóa bộ tra cứu KNN trên Tensor hàng triệu chiều với tốc độ mili-giây đòi hỏi kỹ năng cực sâu về FAISS, C++ và PyTorch.
Anomalib là một thư viện do Intel phát triển, nó được tích hợp cả Padim & PatchCore, nếu bạn ưu tiên sử dụng nhanh và được tối ưu sẵn tôi đề xuất bạn nên sử dụng công cụ này. Nhưng nếu bạn muốn nhìn qua cách thiết kế thuật toán, tôi có làm một notebook để dựng lại 1 bản cơ bản của thuật toán tại đây.