Q-learning
Hãy hình dung một robot di chuyển trong kho. Nó đang ở một ô trên bản đồ lưới, có thể đi lên, xuống, trái, phải, một vài ô là chướng ngại, một ô là trạm lấy hàng, và một ô khác là vùng cấm phải tránh. Ta không đưa cho robot một bản kế hoạch tối ưu từ đầu. Ta chỉ nói rằng: đến được đích thì thưởng cao, mỗi bước di chuyển tốn một ít chi phí, còn đi vào vùng xấu thì bị phạt nặng.
Đây là đúng kiểu bài toán mà Q-learning được sinh ra để xử lý. Agent không học từ nhãn đúng sai như trong supervised learning. Nó học bằng tương tác với môi trường, nhận reward, rồi dần dần sửa lại đánh giá của mình về từng hành động trong từng trạng thái.
Điểm hay của Q-learning là nó rất đơn giản ở mức ý tưởng, nhưng lại đặt nền cho một phần rất lớn của reinforcement learning hiện đại. Nếu hiểu thật chắc Q-learning, ta sẽ dễ hiểu hơn vì sao sau này người ta cần SARSA, DQN, policy gradient hay actor-critic.
Bài toán quyết định tuần tự
Trong supervised learning, một mẫu đầu vào thường đi kèm một đầu ra mong muốn. Mô hình chỉ cần học ánh xạ từ đầu vào sang nhãn. Với robot trong kho thì khác. Chất lượng của một hành động không chỉ nằm ở kết quả tức thời, mà còn nằm ở chuyện nó đưa robot sang trạng thái nào tiếp theo.
Ví dụ, đi sang phải có thể không nhận được phần thưởng gì ngay. Nhưng nếu bước đó đưa robot đến gần trạm lấy hàng hơn, nó vẫn là một bước tốt. Ngược lại, một bước nhìn có vẻ vô hại ở hiện tại có thể đẩy agent vào ngõ cụt hoặc đi sát vùng phạt, làm phần thưởng dài hạn xấu đi rõ rệt.
Vì vậy, thứ ta cần học không chỉ là "hành động nào có reward ngay lập tức cao nhất", mà là "hành động nào mở ra tổng lợi ích dài hạn tốt nhất". Đó là lý do reinforcement learning luôn gắn với bài toán quyết định tuần tự, và Q-learning tập trung trực tiếp vào phần dài hạn ấy.
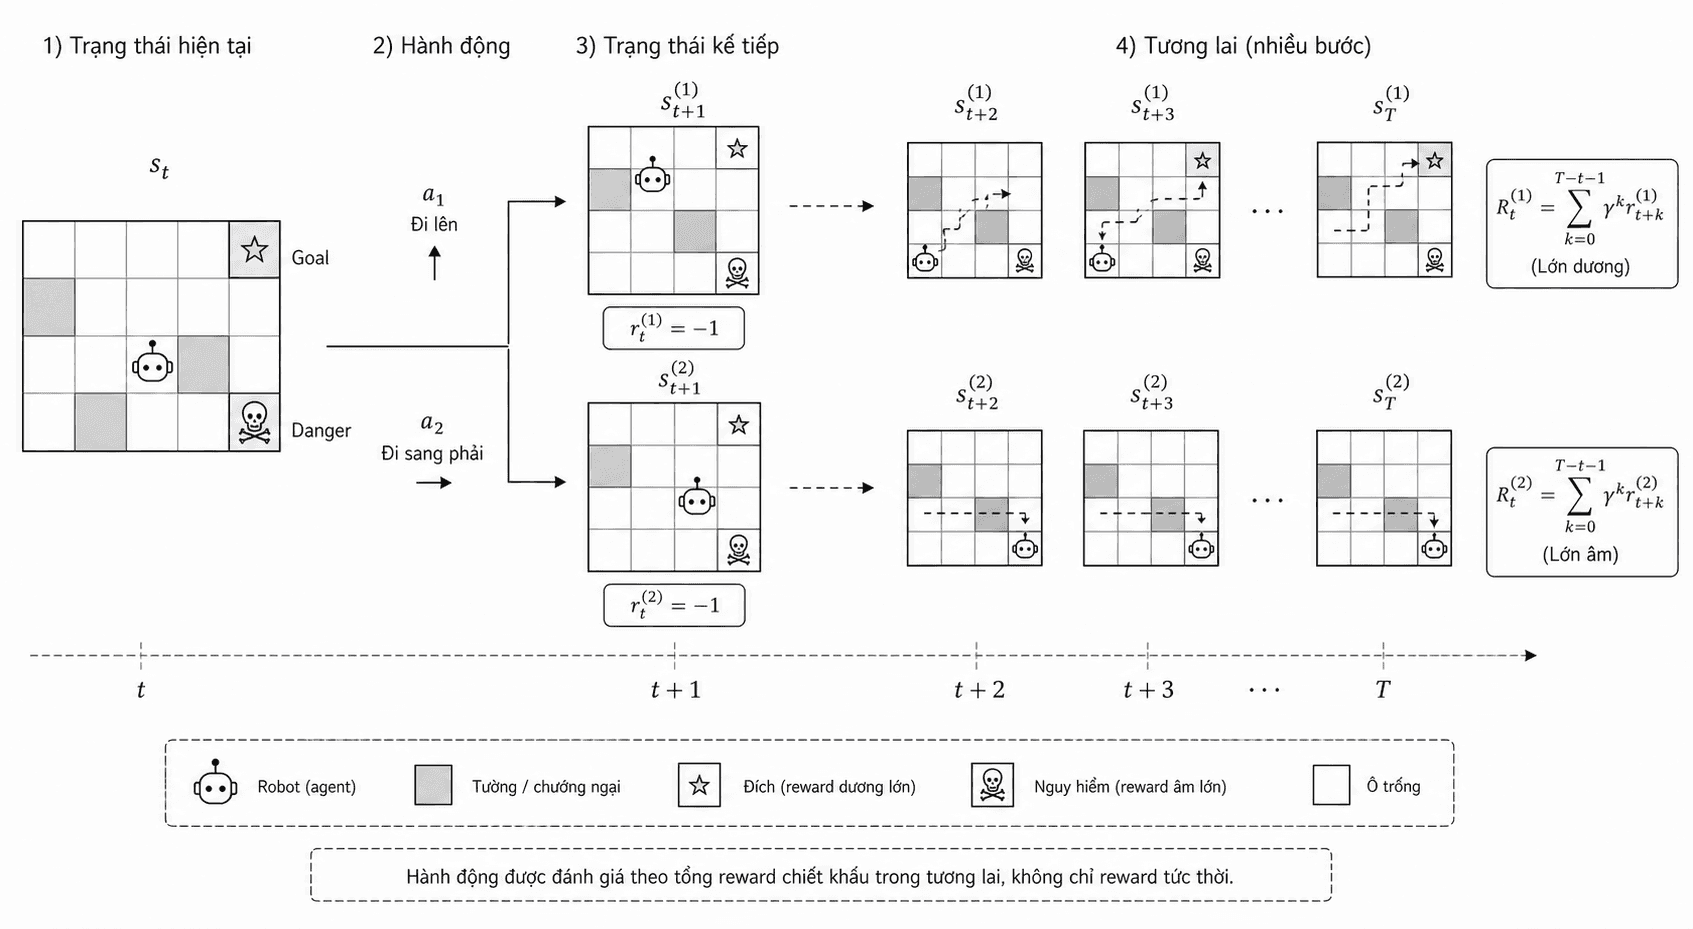
Nhìn theo cách này, Q-learning không cố học quy tắc phản xạ ngắn hạn. Nó cố học cấu trúc giá trị của môi trường.
Mô hình hóa State, Action và Reward
Để nói chuyện rõ ràng hơn, ta ký hiệu:
Trong đó:
- là trạng thái hiện tại của agent.
- là tập các trạng thái có thể có.
- là hành động agent chọn.
- là tập hành động khả dĩ.
Sau khi thực hiện hành động tại trạng thái , môi trường chuyển sang trạng thái mới và trả về reward .
Trong ví dụ kho hàng, trạng thái có thể đơn giản là vị trí hiện tại của robot trên lưới. Hành động là bốn hướng di chuyển. Reward có thể được thiết kế như sau:
- đến ô đích: ,
- đụng vùng cấm: ,
- mỗi bước đi thường: .
Thiết kế reward kiểu này rất quan trọng. Nếu không phạt nhẹ cho từng bước, robot có thể đi lòng vòng quá lâu mà vẫn không có động lực tìm đường ngắn hơn. Nếu phạt quá nặng, agent lại sợ di chuyển và khó khám phá được đường tốt.
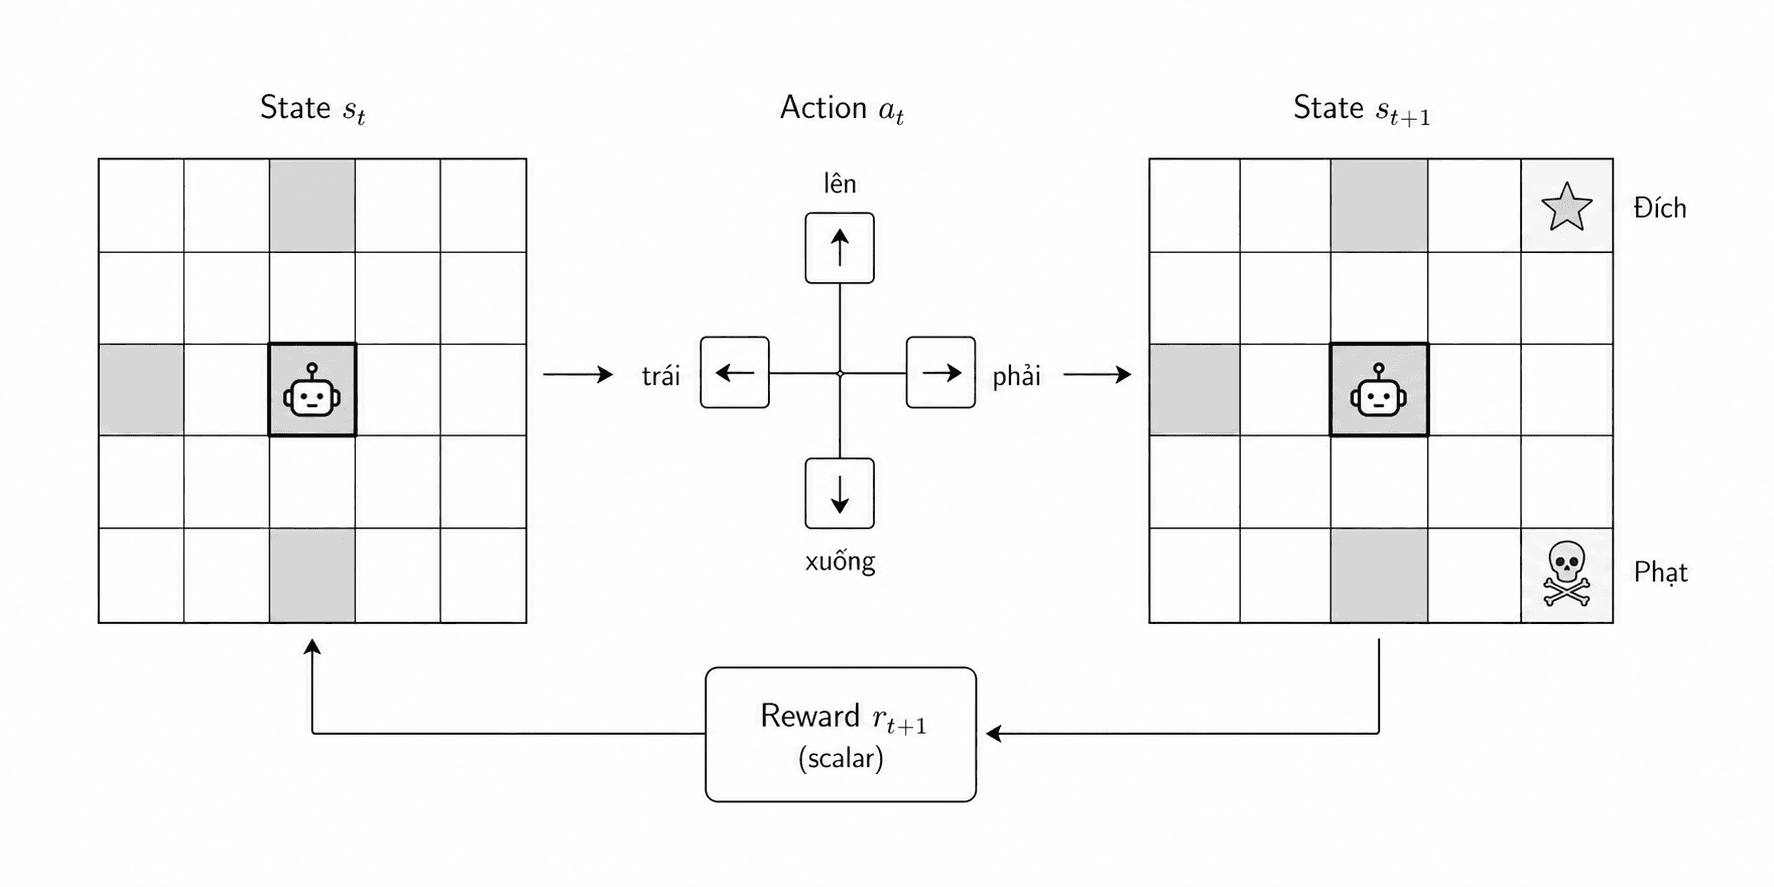
Từ cách thiết kế reward đó, ta có thể hiểu mục tiêu tối ưu của reinforcement learning một cách trực tiếp hơn: agent cần học một chiến lược hành động sao cho tổng reward nhận được theo thời gian là lớn nhất. Nói cách khác, robot không chỉ quan tâm một bước đi hiện tại có bị phạt hay được thưởng hay không, mà phải đánh giá cả chuỗi hệ quả phía sau bước đi đó. Một hành động tốt là hành động giúp robot tiến gần hơn tới đích, tránh vùng phạt, giảm số bước thừa và cuối cùng tạo ra tổng reward dài hạn cao hơn.
Chiến lược hành động này thường được gọi là policy, ký hiệu là . Policy cho biết ở mỗi trạng thái, agent nên chọn hành động nào. Trong bài toán robot điều hướng, policy có thể hiểu đơn giản là “đứng ở ô này thì nên đi lên, xuống, trái hay phải”. Ban đầu policy có thể rất kém vì agent chưa hiểu môi trường. Nhưng thông qua quá trình thử, sai và nhận reward, agent dần điều chỉnh cách ra quyết định để tạo ra tổng reward tốt hơn.
Vì vậy, mục tiêu của Q-learning không phải là ghi nhớ một đường đi cố định từ Start đến Goal. Mục tiêu của nó là học ra một chiến lược ra quyết định tốt cho từng trạng thái trong môi trường. Khi chiến lược này đủ tốt, robot có thể tự chọn các hành động hợp lý để đi tới đích, tránh chướng ngại và hạn chế các bước di chuyển không cần thiết.
Hàm giá trị hành động Q(s, a)
Sau khi đã xác định được state, action và reward, câu hỏi tiếp theo là: làm sao agent biết ở một trạng thái cụ thể thì hành động nào nên được ưu tiên?
Giả sử robot đang đứng tại một ô trong mê cung. Từ ô đó, nó có thể chọn bốn hành động: đi lên, đi xuống, đi trái hoặc đi phải. Một số hành động có thể đưa robot tiến gần hơn tới đích. Một số hành động khác có thể làm robot đi vào ngõ cụt, va vào tường, hoặc mất thêm nhiều bước mới quay lại được đường đúng.
Vì vậy, agent cần một cách để đánh giá chất lượng của từng hành động tại từng trạng thái. Q-learning làm điều này bằng cách gán cho mỗi cặp trạng thái–hành động một con số gọi là Q-value:
Trong đó:
- là trạng thái hiện tại của agent.
- là hành động agent chọn tại trạng thái đó.
- là giá trị đánh giá hành động khi agent đang ở trạng thái .
Có thể hiểu là mức độ “đáng chọn” của một hành động nếu xét cả reward hiện tại và các hệ quả phía sau. Nói cách khác, Q-value không chỉ trả lời câu hỏi:
Hành động này có tốt ngay tại bước hiện tại không?
mà còn trả lời câu hỏi quan trọng hơn:
Nếu chọn hành động này, tổng reward trong tương lai có khả năng tốt đến mức nào?
Ví dụ, giả sử robot đang đứng tại một ô gần ngã rẽ trong mê cung. Tại đó, nó có thể chọn một trong bốn hành động. Sau một thời gian học, agent có thể đánh giá các hành động như sau:
| Hành động | Q-value | Ý nghĩa | Có nên chọn không? |
|---|---|---|---|
| Lên | Có xu hướng đưa robot đi xa khỏi đích hoặc vào vùng kém lợi | Không nên ưu tiên | |
| Xuống | Có khả năng đưa robot tiến gần hơn tới goal và tạo reward dài hạn tốt | Nên ưu tiên nhất | |
| Trái | Có thể dẫn vào tường, ngõ cụt hoặc vùng phạt | Tránh chọn | |
| Phải | Tốt hơn đi trái hoặc đi lên, nhưng chưa phải lựa chọn tốt nhất | Có thể chọn nếu cần khám phá |
Từ bảng trên, nếu agent muốn khai thác những gì đã học, nó sẽ chọn hành động xuống, vì hành động này có Q-value lớn nhất:
Điểm quan trọng là Q-value không chỉ phản ánh reward ngay lập tức. Một hành động ở hiện tại có thể chưa nhận được reward cao, nhưng nếu nó đưa robot đến vị trí thuận lợi hơn cho các bước sau, Q-value của nó vẫn có thể lớn. Ngược lại, một hành động có vẻ không gây hại ngay lập tức nhưng dẫn robot vào ngõ cụt hoặc vùng phạt thì Q-value của nó sẽ thấp dần sau quá trình học.
Nếu agent đã học được giá trị tốt nhất có thể cho mọi cặp trạng thái–hành động, ta ký hiệu hàm đó là hàm giá trị hành động tối ưu:
Khác với , vốn là giá trị agent đang ước lượng trong quá trình học, là giá trị lý tưởng mà agent muốn tiến tới. Nó biểu diễn tổng reward kỳ vọng tốt nhất có thể đạt được nếu agent chọn hành động tại trạng thái , rồi sau đó tiếp tục chọn các hành động tối ưu.
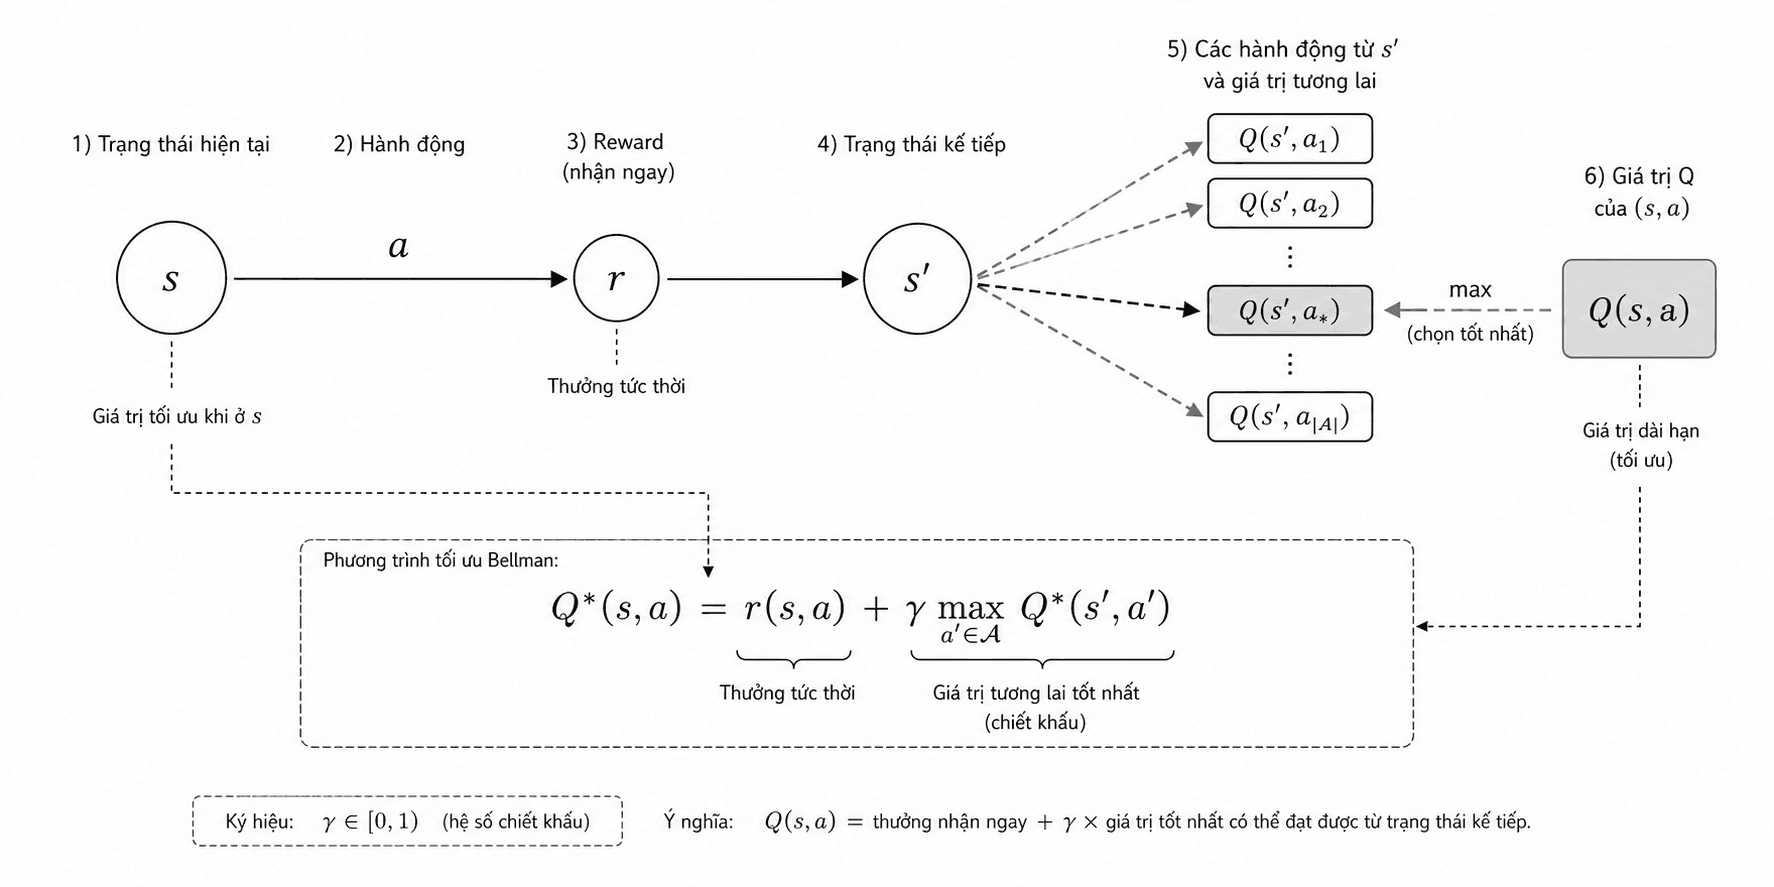
Ở dạng Bellman optimality equation, ta có:
Trong đó:
- là giá trị tối ưu của hành động tại trạng thái .
- là phần thưởng (reward) nhận được ngay sau khi thực hiện hành động hiện tại.
- là trạng thái kế tiếp sau khi agent thực hiện hành động .
- là một hành động có thể chọn ở trạng thái kế tiếp.
- là giá trị tốt nhất có thể đạt được từ trạng thái kế tiếp .
- là hệ số chiết khấu (discount factor), dùng để điều chỉnh mức độ coi trọng phần thưởng trong tương lai.
Phương trình trên cho thấy giá trị tối ưu của một hành động được cấu thành từ hai phần:
Nói theo bối cảnh robot, khi robot chọn một hành động, ta không chỉ xem hành động đó nhận được reward gì ngay bây giờ. Ta còn phải xem hành động đó đưa robot sang trạng thái nào, và từ trạng thái mới đó robot còn có thể đạt được lợi ích tốt đến đâu.
Đây là lý do Q-learning phù hợp với bài toán quyết định tuần tự: một hành động không được đánh giá riêng lẻ, mà được đánh giá dựa trên cả chuỗi kết quả mà nó mở ra về sau.
Trong thực tế, agent không biết sẵn . Nó chỉ bắt đầu từ những ước lượng ban đầu, rồi cập nhật dần các giá trị qua quá trình thử, sai và nhận reward. Mục tiêu của Q-learning là làm cho các giá trị đang ước lượng ngày càng tiến gần hơn tới giá trị tối ưu .
Nếu hiểu chắc câu này, ta sẽ thấy Q-learning không phải đang "ghi nhớ phần thưởng". Nó đang học một bảng dự báo lợi ích dài hạn của từng quyết định cục bộ.
Q-table trong Tabular Q-learning
Phần trên mới nói về một giá trị riêng lẻ. Tuy nhiên, trong bài toán mê cung, agent không chỉ cần đánh giá một hành động tại một trạng thái. Robot có nhiều trạng thái khác nhau, và tại mỗi trạng thái nó lại có nhiều hành động khả dĩ.
Vì vậy, ta cần lưu giá trị cho toàn bộ các cặp trạng thái–hành động. Trong tabular Q-learning, tập hợp các giá trị đó được lưu trong một bảng gọi là Q-table.
Nếu môi trường có trạng thái và hành động, Q-table có kích thước:
Mỗi hàng của bảng ứng với một trạng thái. Mỗi cột ứng với một hành động. Mỗi ô trong bảng là một giá trị cụ thể.
Ví dụ, nếu mê cung có 25 trạng thái và mỗi trạng thái có 4 hành động, Q-table sẽ có kích thước:
Nói cụ thể hơn, nếu robot di chuyển trong một mê cung dạng lưới , ta có thể đánh số từng ô thành một state. Chẳng hạn:
- ô là state 0,
- ô là state 1,
- ô là state 2,
- và tiếp tục như vậy theo thứ tự từ trái sang phải, từ trên xuống dưới.
Với mỗi state, robot có bốn hành động: lên, xuống, trái, phải. Khi đó, Q-table có thể được hình dung như sau:
| State | Vị trí robot | Q(lên) | Q(xuống) | Q(trái) | Q(phải) |
| 0 | |||||
| 1 | |||||
| 2 | |||||
| 7 | |||||
| 12 |
Bảng trên không phải là bản đồ mê cung. Nó là bảng lưu đánh giá của agent đối với từng hành động tại từng trạng thái. Giá trị trong từng ô cho biết hành động đó đang được agent đánh giá tốt hay xấu dựa trên kinh nghiệm đã học.
Ví dụ, tại state 0, tương ứng với vị trí , các Q-value là:
| Hành động | Q-value tại state 0 |
| Lên | |
| Xuống | |
| Trái | |
| Phải |
Hành động phải có Q-value lớn nhất:
Do đó, nếu agent đang chọn hành động theo cách tham lam, tức luôn chọn hành động có Q-value cao nhất, nó sẽ chọn đi phải tại state 0.
Tương tự, tại state 12, các Q-value là:
| Hành động | Q-value tại state 12 |
| Lên | |
| Xuống | |
| Trái | |
| Phải |
Hành động xuống có Q-value lớn nhất:
Vì vậy, policy học được tại state 12 sẽ ưu tiên hành động xuống.
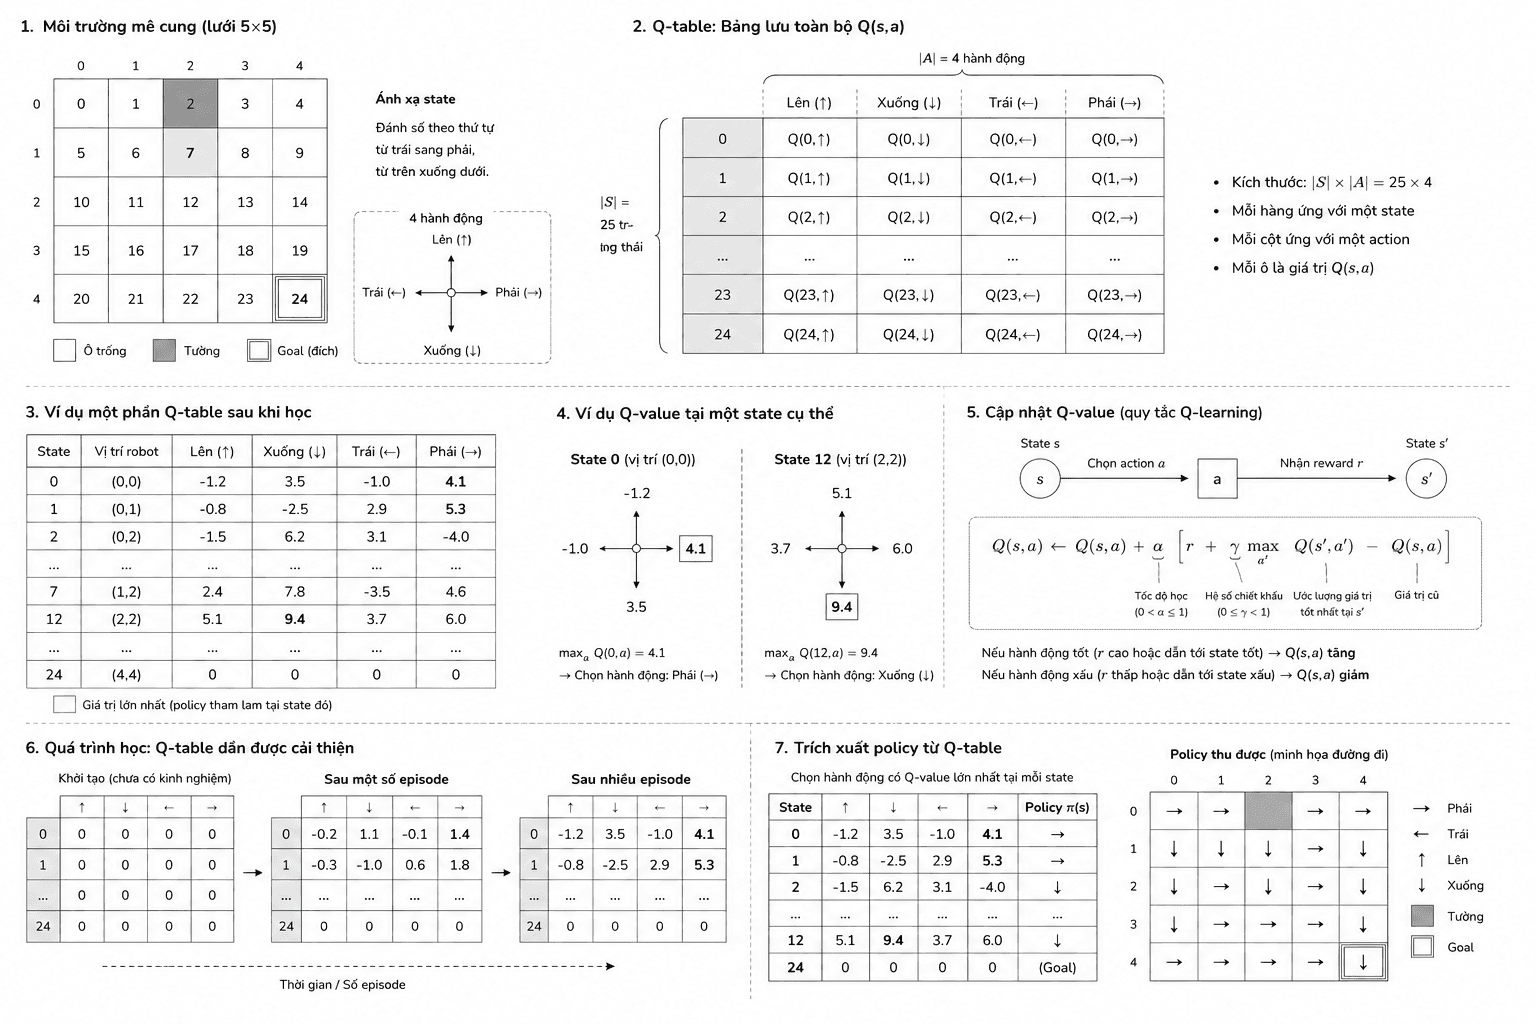
Ở thời điểm ban đầu, Q-table thường được khởi tạo bằng 0:
Điều này có nghĩa là agent chưa biết hành động nào là tốt, hành động nào là xấu. Nó chưa có kinh nghiệm về môi trường, nên mọi lựa chọn ban đầu gần như được xem là ngang nhau. Các con số trong bảng minh họa phía trên không được nhập thủ công. Chúng chỉ xuất hiện sau nhiều lần robot thử di chuyển, nhận reward tốt hoặc xấu, rồi cập nhật dần giá trị trong Q-table.
Trong quá trình học, robot liên tục tương tác với môi trường. Nó chọn một hành động, di chuyển sang trạng thái mới, nhận reward, rồi dùng trải nghiệm đó để điều chỉnh lại một giá trị trong Q-table. Nếu một hành động thường giúp robot tiến gần tới goal và tạo ra tổng reward tốt, Q-value của hành động đó sẽ dần tăng lên. Ngược lại, nếu một hành động thường dẫn tới tường, vùng phạt, ngõ cụt hoặc làm robot đi vòng lâu hơn, Q-value của nó sẽ dần giảm xuống.
Khi Q-table đã được cập nhật qua đủ nhiều trải nghiệm, policy của agent có thể được suy ra bằng cách chọn hành động có Q-value lớn nhất tại mỗi trạng thái:
Công thức này có nghĩa là: tại trạng thái , agent chọn hành động làm cho lớn nhất. Với bài toán robot điều hướng, policy chính là quy tắc ra quyết định kiểu “ở ô này thì nên đi hướng nào”.
Tóm lại, Q-value là giá trị đánh giá một hành động tại một trạng thái cụ thể, còn Q-table là cấu trúc dùng để lưu toàn bộ các Q-value đó trong bài toán tabular. Khi Q-table đủ tốt, chiến lược điều hướng của robot sẽ tự xuất hiện từ việc chọn hành động có Q-value cao nhất ở từng trạng thái.
Công thức cập nhật của Q-learning
Ở phần trước, ta đã biết rằng Q-table là nơi lưu đánh giá của agent về từng hành động tại từng trạng thái. Mỗi ô trong Q-table là một giá trị . Giá trị này cho biết: nếu agent đang ở trạng thái và chọn hành động , thì hành động đó được đánh giá tốt hay xấu về dài hạn.
Tuy nhiên, ban đầu agent chưa biết gì về môi trường. Vì vậy, Q-table thường được khởi tạo bằng 0:
Điều này có nghĩa là ở thời điểm đầu, agent chưa biết đi lên tốt hơn, đi xuống tốt hơn, hay đi sang phải tốt hơn. Nó phải tự học bằng cách thử hành động, nhận reward và sửa dần các giá trị trong Q-table.
Mỗi lần agent thực hiện một hành động, nó sẽ quan sát được bốn thông tin:
| Thành phần | Ý nghĩa |
|---|---|
| Trạng thái hiện tại | |
| Hành động vừa chọn | |
| Reward nhận được sau hành động đó | |
| Trạng thái mới sau khi di chuyển |
Ví dụ, robot đang ở ô hiện tại , chọn đi phải, nhận reward , rồi chuyển sang ô mới . Từ trải nghiệm này, Q-learning sẽ cập nhật lại giá trị của hành động vừa thực hiện, tức là cập nhật ô:
trong Q-table.
Ý tưởng cập nhật rất trực quan:
- Nếu hành động vừa chọn dẫn đến kết quả tốt, giá trị nên tăng lên.
- Nếu hành động vừa chọn dẫn đến kết quả xấu, giá trị nên giảm xuống.
- Nếu hành động vừa chọn dẫn đến một trạng thái mới có nhiều lựa chọn tốt tiếp theo, giá trị cũng nên được đánh giá cao hơn.
Vì vậy, Q-learning không chỉ nhìn reward ngay lập tức. Nó còn nhìn trạng thái kế tiếp để xem từ đó agent có thể tiếp tục đi tốt hay không. Đây là điểm nối trực tiếp với ý nghĩa của Q-value ở phần trước: Q-value không chỉ đo lợi ích hiện tại, mà đo lợi ích dài hạn.
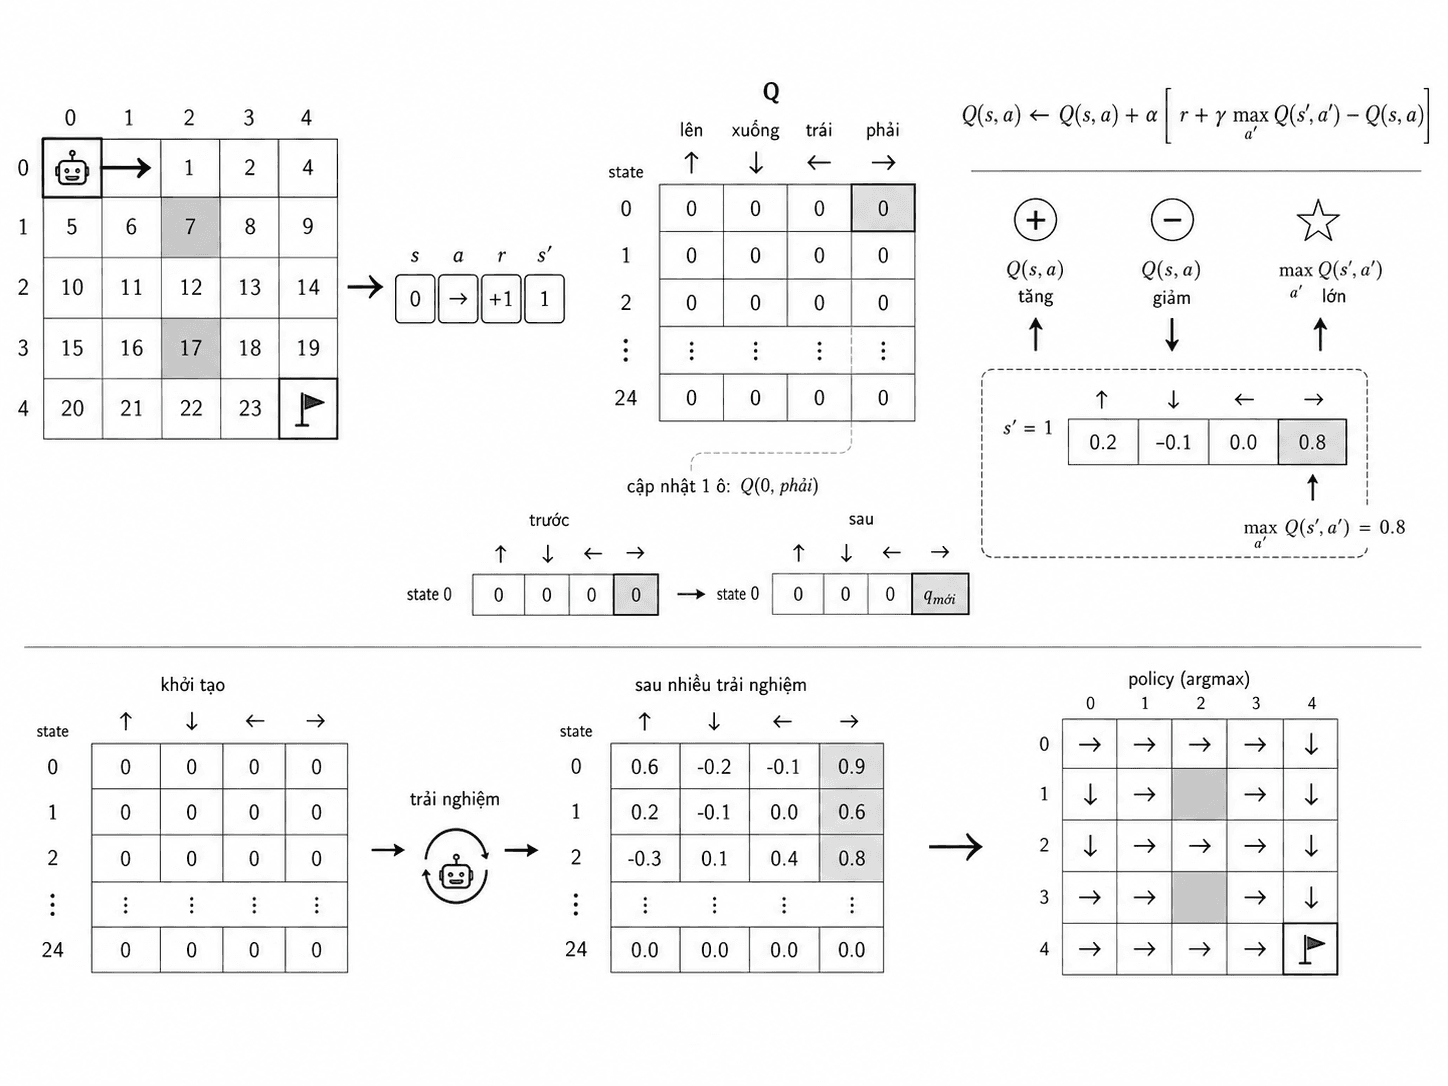
Công thức cập nhật của Q-learning là:
Trong công thức này:
| Ký hiệu | Ý nghĩa |
| Giá trị hiện tại của hành động tại trạng thái | |
| Reward vừa nhận được | |
| Trạng thái kế tiếp | |
| Giá trị tốt nhất có thể chọn tiếp từ trạng thái mới | |
| Mức độ coi trọng phần thưởng trong tương lai | |
| Tốc độ học, quyết định cập nhật mạnh hay nhẹ |
Có thể đọc công thức này theo ngôn ngữ tự nhiên như sau:
Giá trị mới của hành động vừa chọn bằng giá trị cũ, cộng thêm một phần điều chỉnh dựa trên reward hiện tại và triển vọng tốt nhất ở trạng thái kế tiếp.
Với ví dụ chúng ta đang đề cập nếu:
Robot đang ở state 0 và chọn hành động phải.
Trước khi cập nhật:
Sau khi đi phải, robot nhận reward:
Robot chuyển sang state 1. Ở state 1, hành động tốt nhất hiện có Q-value là:
Nếu chọn:
thì công thức cập nhật là:
Tính phần trong ngoặc:
Do đó:
Sau bước này, giá trị của hành động phải tại state 0 tăng từ lên . Điều đó có nghĩa là agent đánh giá hành động này tốt hơn một chút, vì nó dẫn đến một trạng thái kế tiếp có triển vọng tốt.
Điều quan trọng là Q-learning chỉ sửa một ô trong Q-table ở mỗi bước: ô tương ứng với trạng thái và hành động vừa xảy ra. Sau rất nhiều lần thử như vậy, các giá trị trong Q-table dần thay đổi. Hành động tốt dần có Q-value cao hơn, hành động xấu dần có Q-value thấp hơn.
Tóm lại, mối liên hệ giữa Q-table và Q-learning là:
| Thành phần | Vai trò |
| Q-table | Nơi lưu kinh nghiệm của agent |
| Q-value | Giá trị đánh giá một hành động tại một trạng thái |
| Q-learning | Quy tắc dùng reward và trạng thái kế tiếp để cập nhật Q-table |
| Policy | Cách chọn hành động dựa trên Q-table sau khi học |
Như vậy, Q-learning chính là cơ chế giúp Q-table chuyển từ một bảng toàn số 0 thành một bảng chứa kinh nghiệm điều hướng. Khi Q-table đủ tốt, agent có thể chọn hành động hợp lý bằng cách lấy hành động có Q-value lớn nhất tại mỗi trạng thái.
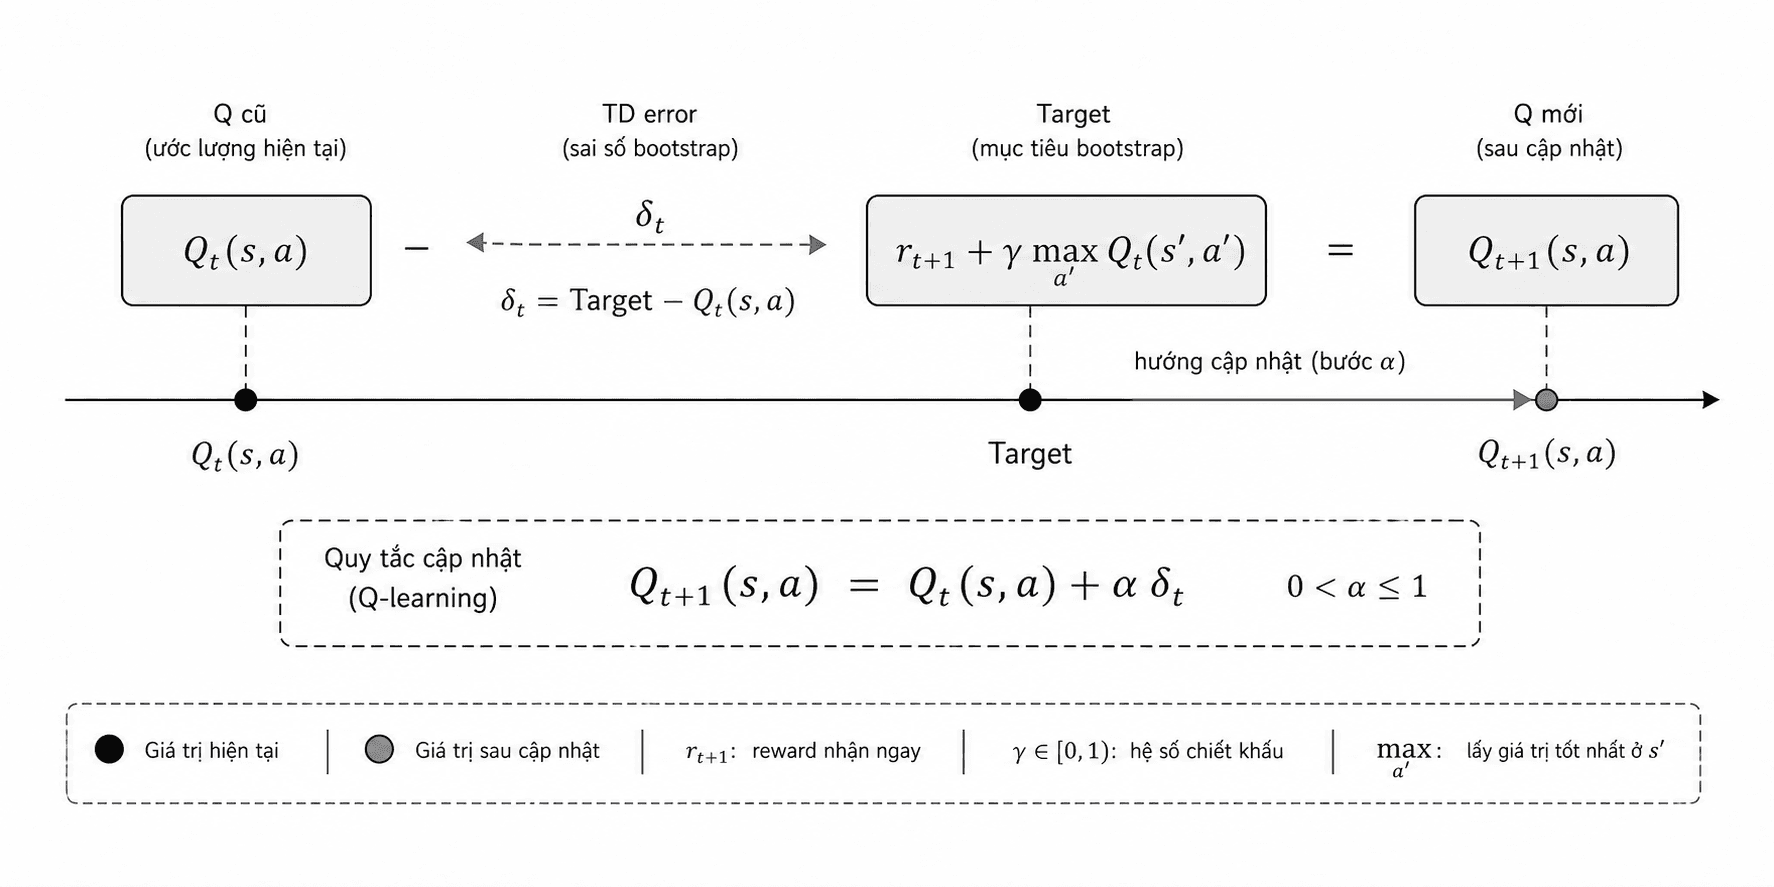
Khi trạng thái kế tiếp là terminal state, phần bootstrap thường biến mất vì sau đó không còn hành động nào để tích lũy giá trị nữa.
Khám phá và khai thác (Exploration & Exploitation)
Sau khi Q-table được cập nhật qua nhiều bước, agent có thể dùng các Q-value trong bảng để chọn hành động. Cách đơn giản nhất là: tại trạng thái hiện tại, chọn hành động có Q-value lớn nhất.
Ví dụ, nếu robot đang ở state 0 và Q-table tại state đó có dạng:
| Hành động | Q-value |
|---|---|
| Lên | |
| Xuống | |
| Trái | |
| Phải |
thì hành động phải có Q-value lớn nhất. Nếu agent chỉ dựa vào Q-table hiện tại, nó sẽ chọn đi phải.
Cách chọn này được gọi là exploitation, tức khai thác những gì agent đã học được. Agent tin rằng Q-table hiện tại đã chứa thông tin hữu ích, nên nó chọn hành động đang được đánh giá tốt nhất.
Tuy nhiên, vấn đề là ở giai đoạn đầu, Q-table chưa đáng tin. Ban đầu, các giá trị trong Q-table thường đều bằng 0. Sau một vài lần thử, một số hành động có thể tình cờ nhận reward tốt hơn, nhưng điều đó chưa chắc có nghĩa là chúng thật sự tốt nhất. Nếu agent luôn chọn hành động có Q-value lớn nhất ngay từ đầu, nó có thể bị kẹt trong một chiến lược chưa tối ưu.
Ví dụ, robot có thể sớm tìm được một đường đi tới goal nhưng đường đó rất vòng vèo. Nếu nó chỉ khai thác đường này và không thử các hướng khác, nó sẽ không phát hiện ra một đường ngắn hơn. Trong trường hợp đó, Q-table vẫn được cập nhật, nhưng kinh nghiệm của agent bị giới hạn bởi những hành động mà nó đã từng thử.
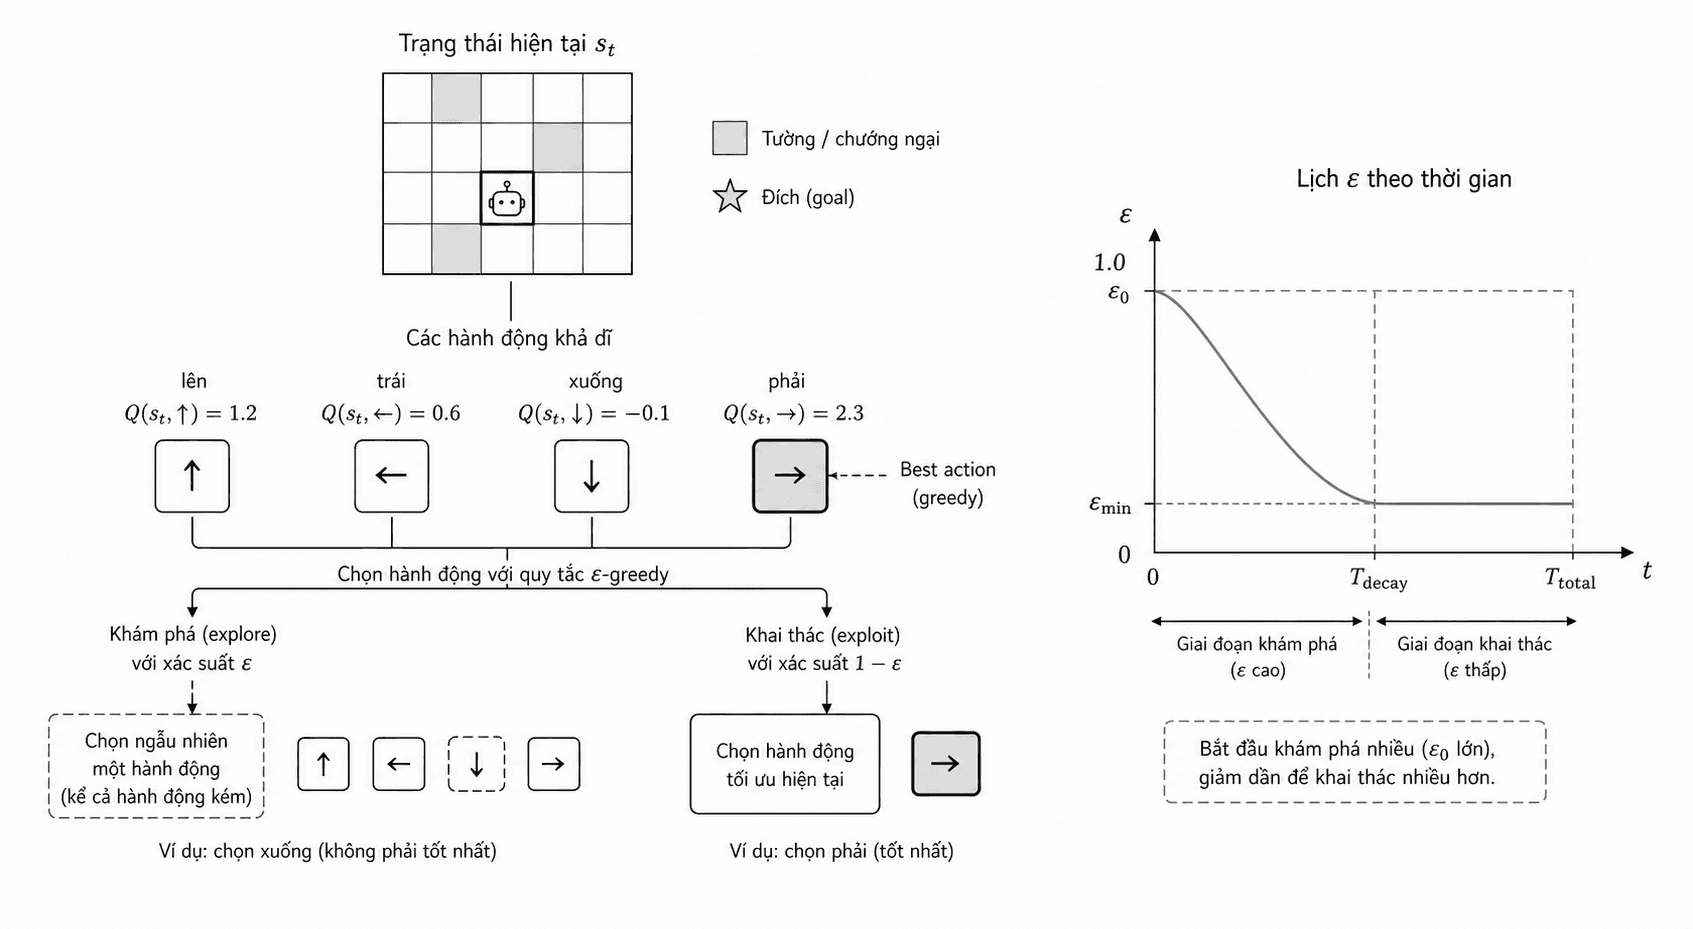
Vì vậy, agent cần thêm một cơ chế gọi là exploration, tức khám phá. Thay vì lúc nào cũng chọn hành động có Q-value cao nhất, đôi khi agent sẽ cố ý chọn một hành động ngẫu nhiên. Việc chọn ngẫu nhiên này có thể khiến robot đi sai, va vào tường hoặc nhận reward thấp trong ngắn hạn. Nhưng đổi lại, agent có cơ hội thu thêm thông tin về môi trường và phát hiện những đường đi tốt hơn.
Có thể hiểu ngắn gọn như sau:
| Khái niệm | Ý nghĩa | Khi nào cần nhiều? |
Exploration | Thử các hành động khác để thu thêm kinh nghiệm | Giai đoạn đầu, khi Q-table còn ít thông tin |
Exploitation | Chọn hành động có Q-value cao nhất hiện tại | Giai đoạn sau, khi Q-table đã học đủ tốt |
Trong Q-learning, một cách phổ biến để cân bằng hai yếu tố này là dùng epsilon-greedy.
Ý tưởng của epsilon-greedy rất đơn giản. Tại mỗi bước, agent sinh ra một số ngẫu nhiên. Nếu số đó nhỏ hơn , agent sẽ chọn hành động ngẫu nhiên để khám phá. Ngược lại, agent sẽ chọn hành động có Q-value lớn nhất để khai thác.
Công thức có thể viết như sau:
Trong đó:
- là hành động được chọn tại thời điểm .
- là trạng thái hiện tại.
- là xác suất agent chọn hành động ngẫu nhiên.
- là xác suất agent chọn hành động tốt nhất theo Q-table.
- nghĩa là chọn hành động làm cho lớn nhất.
Ví dụ, nếu:
thì agent sẽ:
- chọn hành động ngẫu nhiên khoảng số lần,
- chọn hành động có Q-value cao nhất khoảng số lần.
Nếu:
thì agent sẽ khám phá rất nhiều. Điều này phù hợp ở giai đoạn đầu, khi Q-table chưa có thông tin đáng tin cậy.
Nếu:
thì agent chủ yếu khai thác. Điều này phù hợp ở giai đoạn sau, khi Q-table đã học được khá nhiều từ môi trường.
Do đó, trong thực tế, ta thường không giữ cố định. Thay vào đó, ta cho giảm dần theo thời gian. Ban đầu, lớn để agent thử nhiều hướng khác nhau. Sau mỗi episode, giảm dần để agent chuyển sang khai thác Q-table nhiều hơn.
Một cách cập nhật đơn giản là:
Trong đó:
- là giá trị nhỏ nhất mà được phép giảm tới.
- là hệ số giảm, thường nhỏ hơn 1.
- Hàm giúp đảm bảo không giảm xuống dưới mức tối thiểu.
Ví dụ:
Ở episode đầu, agent gần như chọn hành động ngẫu nhiên hoàn toàn. Sau nhiều episode, giảm dần, agent bớt khám phá và bắt đầu tin vào Q-table hơn. Khi chạm mức , agent vẫn giữ lại một lượng khám phá nhỏ để tránh quá cứng nhắc.
Có thể hình dung quá trình này như sau:
| Giai đoạn học | Giá trị | Hành vi của agent |
| Đầu quá trình học | Cao, ví dụ | Chủ yếu khám phá, đi thử nhiều hướng |
| Giữa quá trình học | Trung bình, ví dụ | Vừa thử hướng mới, vừa dùng Q-table |
| Cuối quá trình học | Thấp, ví dụ | Chủ yếu chọn hành động tốt nhất đã học |
Trong bài toán robot giải mê cung, điều này rất quan trọng. Nếu robot chỉ khai thác từ đầu, nó có thể nhanh chóng lặp lại một đường đi chưa tốt. Nếu robot chỉ khám phá mãi, nó sẽ tiếp tục đi ngẫu nhiên và không tận dụng được kinh nghiệm đã học. Epsilon-greedy giúp robot bắt đầu bằng việc thử nhiều hành động, rồi dần dần chuyển sang sử dụng các giá trị trong Q-table để đi tới goal hiệu quả hơn.
Ở mức trực giác, exploration là khoản chi phí bắt buộc phải trả để biết môi trường thực sự có gì. Nếu không chịu trả khoản đó ở đầu quá trình, agent rất dễ tự nhốt mình trong một lời giải ngắn hạn.
Giới hạn của Tabular Q-learning
Đến đây, ta đã thấy Q-learning có một ý tưởng rất rõ ràng: agent học bằng cách tương tác với môi trường, nhận reward, rồi cập nhật dần các giá trị trong Q-table. Khi Q-table đủ tốt, agent có thể chọn hành động bằng cách lấy hành động có Q-value lớn nhất tại trạng thái hiện tại.
Trong bài toán mê cung dạng lưới nhỏ, cách làm này rất trực quan và hiệu quả. Mỗi ô trong mê cung có thể được xem là một state. Mỗi state có một số hành động cố định như lên, xuống, trái, phải. Vì số lượng state và action không quá lớn, ta có thể lưu toàn bộ giá trị trong một bảng.
Ví dụ, với mê cung , ta có 25 state. Nếu mỗi state có 4 action, Q-table chỉ có:
giá trị cần lưu. Đây là một kích thước rất nhỏ. Agent có thể thử nhiều lần, cập nhật từng ô trong bảng, rồi dần học được đường đi hợp lý.
Tuy nhiên, vấn đề xuất hiện khi môi trường lớn hơn. Nếu mê cung có kích thước , số state đã là:
Nếu mỗi state vẫn có 4 action, Q-table cần:
giá trị. Con số này vẫn có thể lưu được, nhưng quá trình học sẽ chậm hơn nhiều vì agent cần trải nghiệm đủ nhiều để cập nhật các trạng thái khác nhau.
Với robot thật, vấn đề còn lớn hơn. Trạng thái của robot thường không chỉ là một ô trên lưới. Nó có thể bao gồm:
- vị trí liên tục của robot,
- vận tốc,
- hướng quay,
- khoảng cách tới vật cản,
- dữ liệu từ lidar hoặc camera,
- trạng thái của môi trường xung quanh.
Khi state không còn là một số lượng nhỏ các ô rời rạc, Q-table bắt đầu trở nên khó dùng. Lý do là tabular Q-learning cần lưu riêng một giá trị cho từng cặp trạng thái–hành động:
Nếu số lượng trạng thái quá lớn, bảng Q sẽ phình ra rất nhanh. Nếu trạng thái là liên tục, ví dụ vị trí robot có thể là bất kỳ giá trị thực nào, thì về lý thuyết số trạng thái có thể là vô hạn. Khi đó, ta không thể tạo một hàng riêng trong Q-table cho từng trạng thái được nữa.
Đây là giới hạn lớn nhất của tabular Q-learning: nó chỉ phù hợp tốt khi state space và action space nhỏ, rời rạc, và có thể liệt kê được.
Có thể tóm tắt như sau:
| Trường hợp | Tabular Q-learning có phù hợp không? | Lý do |
|---|---|---|
| Mê cung nhỏ dạng lưới | Phù hợp | Số state ít, dễ lưu bằng Q-table |
| Mê cung lớn | Có thể dùng nhưng học chậm | Q-table lớn, cần nhiều trải nghiệm |
| Robot có trạng thái liên tục | Không phù hợp trực tiếp | Không thể liệt kê mọi state |
| Robot dùng ảnh camera làm đầu vào | Không phù hợp trực tiếp | State là dữ liệu nhiều chiều, không thể lưu bằng bảng |
| Môi trường thay đổi phức tạp | Khó dùng | Q-table khó bao phủ đủ mọi tình huống |
Một giới hạn khác là Q-table không có khả năng tổng quát hóa tốt. Nếu agent đã học được rằng hành động phải là tốt ở một state cụ thể, kiến thức đó chỉ nằm ở đúng hàng tương ứng với state đó. Khi agent gặp một state mới nhưng khá giống state cũ, Q-table không tự suy luận rằng kinh nghiệm trước đó có thể vẫn hữu ích. Nó cần phải học lại bằng trải nghiệm tại state mới.
Điều này khác với các mô hình học máy dùng hàm xấp xỉ. Một mô hình neural network có thể học ra quy luật chung từ nhiều trạng thái khác nhau. Nhờ đó, khi gặp một trạng thái mới nhưng có cấu trúc tương tự, mô hình có thể đưa ra dự đoán hợp lý hơn. Q-table thì đơn giản và dễ hiểu, nhưng đổi lại nó khá cứng nhắc.
Q-learning cũng là một thuật toán off-policy. Điều này có nghĩa là agent có thể học về một policy tối ưu, dù trong quá trình thu thập dữ liệu nó vẫn đang hành động theo một policy khác. Ví dụ, agent có thể dùng epsilon-greedy để thỉnh thoảng chọn hành động ngẫu nhiên nhằm khám phá, nhưng công thức cập nhật vẫn dùng hành động tốt nhất ở trạng thái kế tiếp:
Nói đơn giản, agent có thể vừa khám phá bằng hành động ngẫu nhiên, vừa cập nhật Q-table theo hướng học một policy tốt hơn. Đây là một điểm mạnh của Q-learning.
Tuy vậy, điểm mạnh này không xóa được giới hạn về kích thước Q-table. Khi trạng thái quá lớn hoặc quá phức tạp, vấn đề không còn nằm ở công thức cập nhật, mà nằm ở cách biểu diễn . Ta không thể tiếp tục lưu mọi giá trị trong một bảng hữu hạn.
Đó là lý do các phương pháp dùng hàm xấp xỉ xuất hiện. Thay vì lưu trong Q-table, ta dùng một mô hình để xấp xỉ hàm Q. Nổi tiếng nhất là Deep Q-Network, hay DQN. Trong DQN, Q-table được thay bằng một mạng neural. Mạng nhận trạng thái làm đầu vào và dự đoán Q-value cho các hành động. Trong ghi chú tiếp sau, tôi sẽ trình bày kỹ hơn về thuật toán DQN.