Các mô hình học tăng cường (Reinforcement Learning)
Một robot di chuyển trong kho không chỉ cần nhận ra kệ hàng hay đọc được mã QR trên sàn. Nó còn phải quyết định nên rẽ hướng nào, đi nhanh hay chậm, chờ người đi qua hay tìm đường vòng, tiếp tục bám theo lộ trình cũ hay đổi sang lộ trình khác. Mỗi quyết định hôm nay có thể ảnh hưởng đến trạng thái vài giây sau: rẽ sai làm robot đến gần vật cản hơn, đi quá chậm làm trễ đơn hàng, đi quá sát người làm hệ thống mất an toàn.
Nếu chỉ nhìn bài toán như một lần dự đoán độc lập, ta dễ chọn cách quen thuộc của supervised learning: đưa ảnh hoặc trạng thái vào mô hình, yêu cầu nó trả ra nhãn đúng. Nhưng trong nhiều hệ thống điều khiển, không phải lúc nào cũng có sẵn nhãn đúng cho từng trạng thái. Một chuyên gia có thể nói robot hoàn thành nhiệm vụ tốt hay tệ, nhưng không thể gán nhãn thủ công cho mọi tình huống rằng ở trạng thái này phải chọn action nào là tối ưu. Cái hệ thống quan sát được thường là hậu quả của một chuỗi hành động.
Học tăng cường, hay reinforcement learning, xuất hiện từ chính khoảng trống đó. Nó nghiên cứu cách một agent học hành động bằng cách tương tác với environment và nhận phản hồi. Phản hồi này không nhất thiết chỉ ra hành động đúng ngay lập tức. Nó có thể là phần thưởng khi robot giao hàng thành công, hình phạt khi va chạm, hoặc chi phí khi đi quá lâu. Từ những tín hiệu rời rạc và đôi khi đến muộn, agent phải học một chiến lược hành động đủ tốt cho cả quá trình.
Bài toán quyết định tuần tự
Điểm khác biệt đầu tiên của học tăng cường nằm ở chữ “tuần tự”. Trong supervised learning, một ảnh mèo được dự đoán sai thường không làm thay đổi ảnh kế tiếp trong dataset. Mỗi mẫu dữ liệu có thể được xem gần như độc lập. Trong học tăng cường, action của agent làm environment chuyển sang trạng thái mới, và chính trạng thái mới đó lại quyết định agent sẽ thấy gì tiếp theo.
Với robot kho, trạng thái hiện tại có thể gồm vị trí robot, vận tốc, bản đồ cục bộ, khoảng cách đến vật cản, vị trí điểm giao hàng và mức pin. Action có thể là lệnh vận tốc, hướng quay, hoặc lựa chọn waypoint kế tiếp. Nếu robot chọn đi thẳng, nó tiến gần mục tiêu hơn nhưng cũng có thể tiến gần một lối đi đang bị chặn. Nếu robot quay lại, nó tránh rủi ro trước mắt nhưng mất thêm thời gian. Một action tốt không chỉ tốt tại khoảnh khắc hiện tại; nó còn phải mở ra những trạng thái sau này dễ xử lý hơn.
Cách mô tả chuẩn cho bài toán này là agent-environment loop. Agent quan sát state, chọn action, environment cập nhật trạng thái, rồi trả về reward và state mới. Chuỗi này lặp lại cho đến khi nhiệm vụ kết thúc hoặc hệ thống bị reset. Học không diễn ra từ một nhãn cố định, mà từ việc cải thiện hành vi qua nhiều lần tương tác.
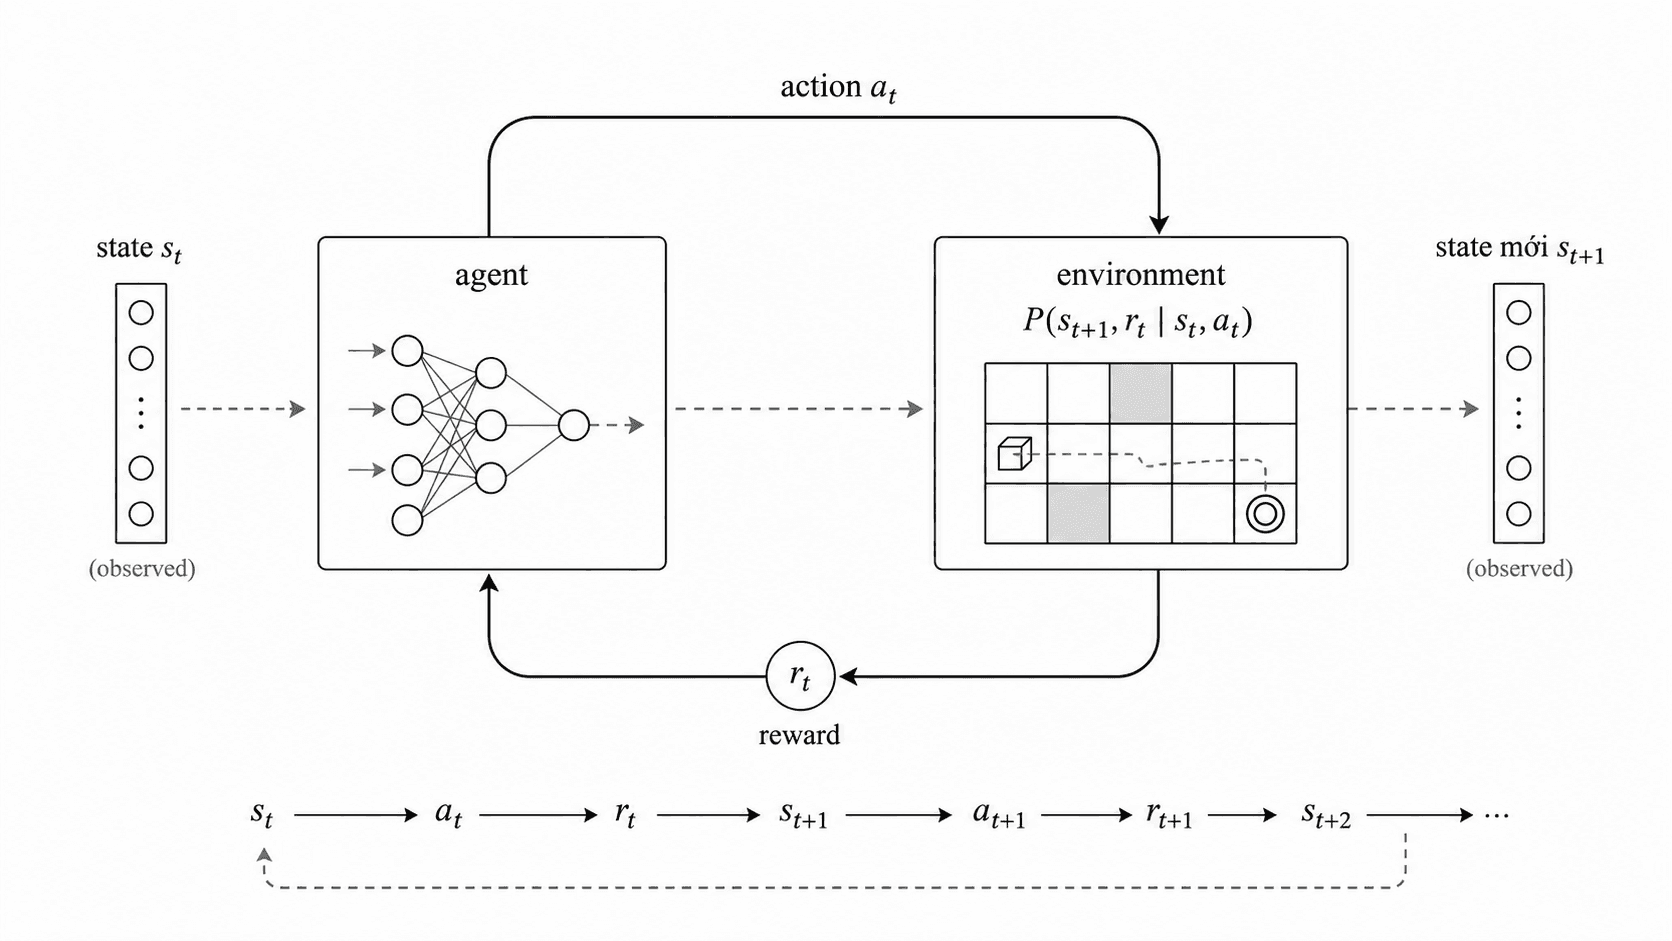
Vì action ảnh hưởng đến dữ liệu tương lai, dữ liệu trong học tăng cường không còn là thứ đứng yên để mô hình học thụ động. Một policy chưa tốt sẽ tạo ra những trải nghiệm kém, và chính những trải nghiệm đó lại trở thành dữ liệu huấn luyện. Đây là lý do học tăng cường thường khó ổn định hơn supervised learning: mô hình không chỉ học từ dataset, nó còn tham gia tạo ra dataset của chính mình.
State, action và reward
Ba thành phần cơ bản nhất của học tăng cường là state, action và reward. Chúng nghe đơn giản, nhưng cách định nghĩa ba thứ này quyết định phần lớn hình dạng của bài toán.
State là những gì agent dùng để ra quyết định. Trong ví dụ robot kho, state có thể là vector trạng thái đã xử lý từ cảm biến, ảnh camera, lidar scan, bản đồ local costmap hoặc một latent representation do mạng neural trích xuất. State không nhất thiết chứa toàn bộ sự thật của environment. Nếu robot không nhìn thấy phía sau kệ hàng, phần đó vẫn ảnh hưởng đến tương lai nhưng không có mặt trực tiếp trong quan sát hiện tại. Khi state không đầy đủ, bài toán trở thành partially observable và agent phải dựa vào lịch sử, bộ nhớ hoặc belief state.
Action là những lựa chọn agent có thể thực hiện. Action space có thể rời rạc, chẳng hạn đi thẳng, rẽ trái, rẽ phải, dừng. Nó cũng có thể liên tục, chẳng hạn vận tốc tuyến tính và vận tốc góc của robot. Action rời rạc thường dễ phân tích hơn, nhưng action liên tục gần với điều khiển vật lý hơn. Một số nhánh của học tăng cường được sinh ra gần như chỉ vì action space thay đổi: thuật toán phù hợp cho game Atari chưa chắc phù hợp cho cánh tay robot có nhiều khớp.
Reward là tín hiệu đánh giá sau mỗi bước hoặc sau cả nhiệm vụ. Robot nhận reward dương khi giao hàng đúng vị trí, reward âm khi va chạm, và có thể nhận một chi phí nhỏ ở mỗi bước để khuyến khích đường đi ngắn. Reward không phải lúc nào cũng dễ thiết kế. Nếu chỉ thưởng cho việc đến đích thật nhanh, robot có thể học cách đi sát vật cản hoặc phanh gấp. Nếu phạt rủi ro quá nặng, nó có thể học cách đứng yên để tránh mọi tình huống xấu.
Điểm cần chú ý là reward không giống nhãn đúng trong supervised learning. Nó không nói trực tiếp action nào nên được chọn. Nó chỉ nói kết quả sau hành động đó tốt hay xấu theo một thước đo nào đó. Agent phải tự suy ngược: nếu sau nhiều bước cuối cùng nhận được reward cao, những action trước đó đóng góp như thế nào? Câu hỏi này dẫn đến khái niệm return.
Return và discount factor
Nếu chỉ tối đa hóa reward ngay bước tiếp theo, agent sẽ trở nên ngắn hạn. Robot có thể chọn lối đi gần nhất trước mắt dù lối đó dẫn đến vùng tắc nghẽn. Học tăng cường vì thế quan tâm đến tổng phần thưởng trong tương lai, gọi là return.
Một cách viết phổ biến là:
là return bắt đầu từ thời điểm , còn là reward nhận được tại từng bước. Hệ số nằm trong khoảng từ đến và được gọi là discount factor. Khi gần , agent quan tâm nhiều đến reward trước mắt. Khi gần , agent nhìn xa hơn vào tương lai.
Discount factor không chỉ là mẹo toán học. Nó phản ánh cách ta muốn agent cân bằng giữa lợi ích gần và lợi ích xa. Trong một nhiệm vụ ngắn, robot cần giao hàng càng nhanh càng tốt, nhưng vẫn phải tránh tình huống khiến nó mắc kẹt sau đó. Nếu nhìn quá ngắn, nó dễ tham lam. Nếu nhìn quá xa trong môi trường nhiều bất định, tín hiệu học có thể nhiễu và khó quy trách nhiệm cho từng action.
Return đặt mục tiêu cho toàn bộ chuỗi hành động, nhưng agent vẫn phải ra quyết định ở từng state cụ thể. Để làm được điều đó, học tăng cường cần một cách đánh giá: ở trạng thái này, action nào có triển vọng dẫn đến return tốt hơn?
Policy và value function
Policy là chiến lược hành động của agent. Nó cho biết trong một state, agent sẽ chọn action nào hoặc phân phối xác suất trên các action. Nếu policy của robot kho thấy lối đi trước mặt trống và mục tiêu nằm phía trước, nó có thể chọn đi thẳng. Nếu lidar cho thấy người đang băng qua, policy có thể giảm tốc hoặc dừng.
Value function là cách agent đánh giá tương lai. Thay vì chỉ hỏi action nào được chọn ngay bây giờ, value function hỏi state hoặc cặp state-action này hứa hẹn bao nhiêu return về sau. Với state-value function, ta đánh giá một state dưới một policy:
là kỳ vọng return nếu agent bắt đầu ở state và tiếp tục hành động theo policy . Với action-value function, ta đánh giá trực tiếp một action tại state:
trả lời câu hỏi gần với quyết định hơn: nếu ở state ta chọn action , rồi sau đó tiếp tục theo policy , return kỳ vọng là bao nhiêu? Từ đây, agent có thể chọn action có cao nhất hoặc dùng để cải thiện policy.
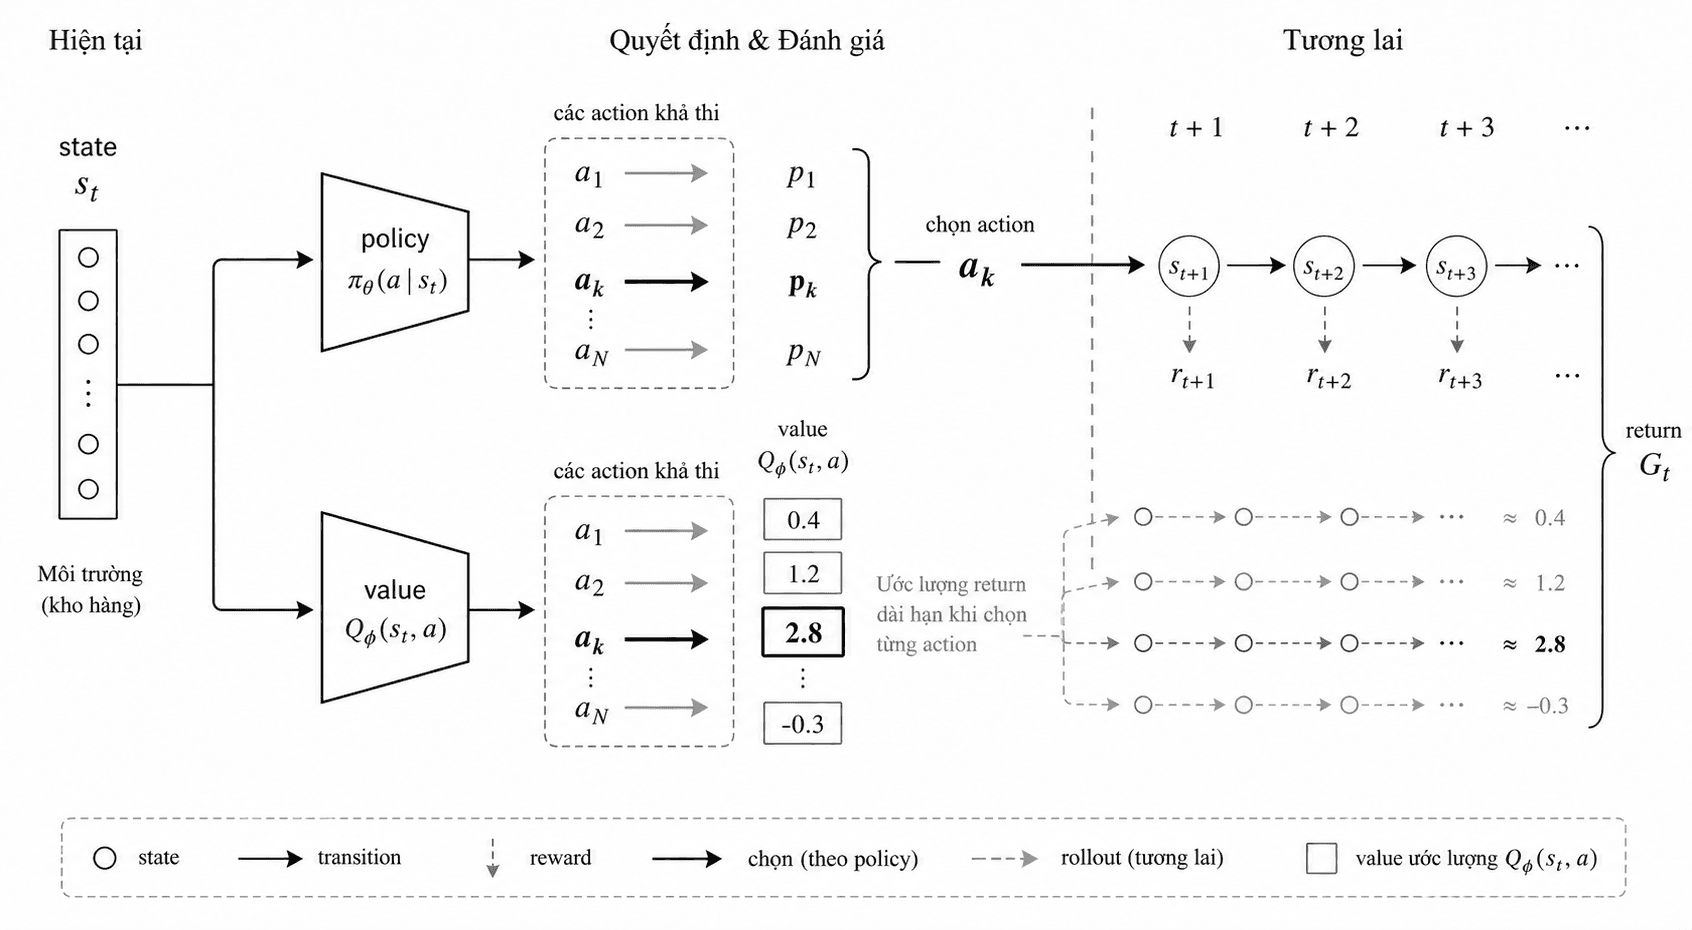
Policy và value function tạo ra hai cách nhìn bổ sung. Policy nói “nên làm gì”. Value function nói “tương lai của lựa chọn này đáng giá bao nhiêu”. Một số thuật toán học trực tiếp policy. Một số thuật toán học value rồi suy ra policy. Nhiều thuật toán hiện đại học cả hai, vì policy cần hành động trơn tru còn value giúp giảm nhiễu khi đánh giá tương lai.
Nhưng dù học policy hay value, agent vẫn gặp một vấn đề chung: nếu chỉ lặp lại những action hiện tại có vẻ tốt, nó có thể không bao giờ khám phá ra lựa chọn tốt hơn.
Exploration và exploitation
Exploitation là dùng những gì agent đã biết để lấy reward cao. Exploration là thử những action chưa chắc tốt để thu thập thông tin. Hai nhu cầu này luôn kéo ngược nhau.
Trong robot kho, nếu robot đã biết một lối đi thường an toàn, nó có lý do để tiếp tục dùng lối đó. Nhưng nếu một lối mới vừa được mở, robot cần thử để biết liệu đường đó có ngắn hơn hay không. Thử quá ít khiến agent mắc kẹt trong hành vi trung bình. Thử quá nhiều khiến nó hành động bất ổn và có thể vi phạm an toàn.
Exploration khó vì reward thường đến muộn. Một action ban đầu có vẻ tệ, chẳng hạn đi vòng xa hơn, có thể dẫn đến đường ít tắc và hoàn thành nhiệm vụ nhanh hơn. Ngược lại, một action có reward trước mắt cao có thể đưa robot vào vùng khó thoát. Agent phải học từ những chuỗi trải nghiệm dài, trong đó tác dụng của một action chỉ lộ ra sau nhiều bước.
Các thuật toán khác nhau xử lý exploration theo nhiều cách: thêm nhiễu vào action, chọn ngẫu nhiên theo xác suất nhỏ, thưởng cho trạng thái mới, hoặc duy trì bất định trong value estimate. Không có một chiến lược exploration chung tốt cho mọi môi trường. Game, mô phỏng vật lý, trading, robotics và recommendation đều có rủi ro khác nhau khi agent thử sai.
Vấn đề exploration cũng cho thấy vì sao học tăng cường không chỉ là “supervised learning với reward”. Supervised learning thường giả định dữ liệu đã có sẵn và đại diện đủ tốt cho phân phối cần học. Học tăng cường phải quyết định thu thập dữ liệu nào tiếp theo, và quyết định thu thập đó cũng là một hành động có hậu quả.
Model-free và model-based
Một cách chia lớn trong học tăng cường là model-free và model-based. Ở đây, “model” không có nghĩa là neural network nói chung, mà là mô hình động học của environment: nếu ở state này chọn action này, state tiếp theo và reward sẽ ra sao.
Model-free reinforcement learning không cố học rõ environment chuyển trạng thái như thế nào. Nó học trực tiếp policy hoặc value từ trải nghiệm. Q-learning, SARSA, policy gradient và actor-critic đều nằm trong vùng này theo các biến thể khác nhau. Cách tiếp cận model-free thường đơn giản về mặt thiết kế mô hình môi trường, nhưng cần nhiều tương tác vì agent phải tự trải nghiệm đủ tình huống.
Model-based reinforcement learning cố học hoặc sử dụng một mô hình chuyển trạng thái. Nếu robot có một mô hình dự đoán rằng đi thẳng trong 0.5 giây sẽ đưa nó đến vị trí nào, nó có thể mô phỏng nhiều action trong đầu trước khi thực hiện thật. Điều này giúp tiết kiệm tương tác với môi trường thật, đặc biệt quan trọng trong robotics, nơi thử sai có thể gây hư hỏng hoặc nguy hiểm.
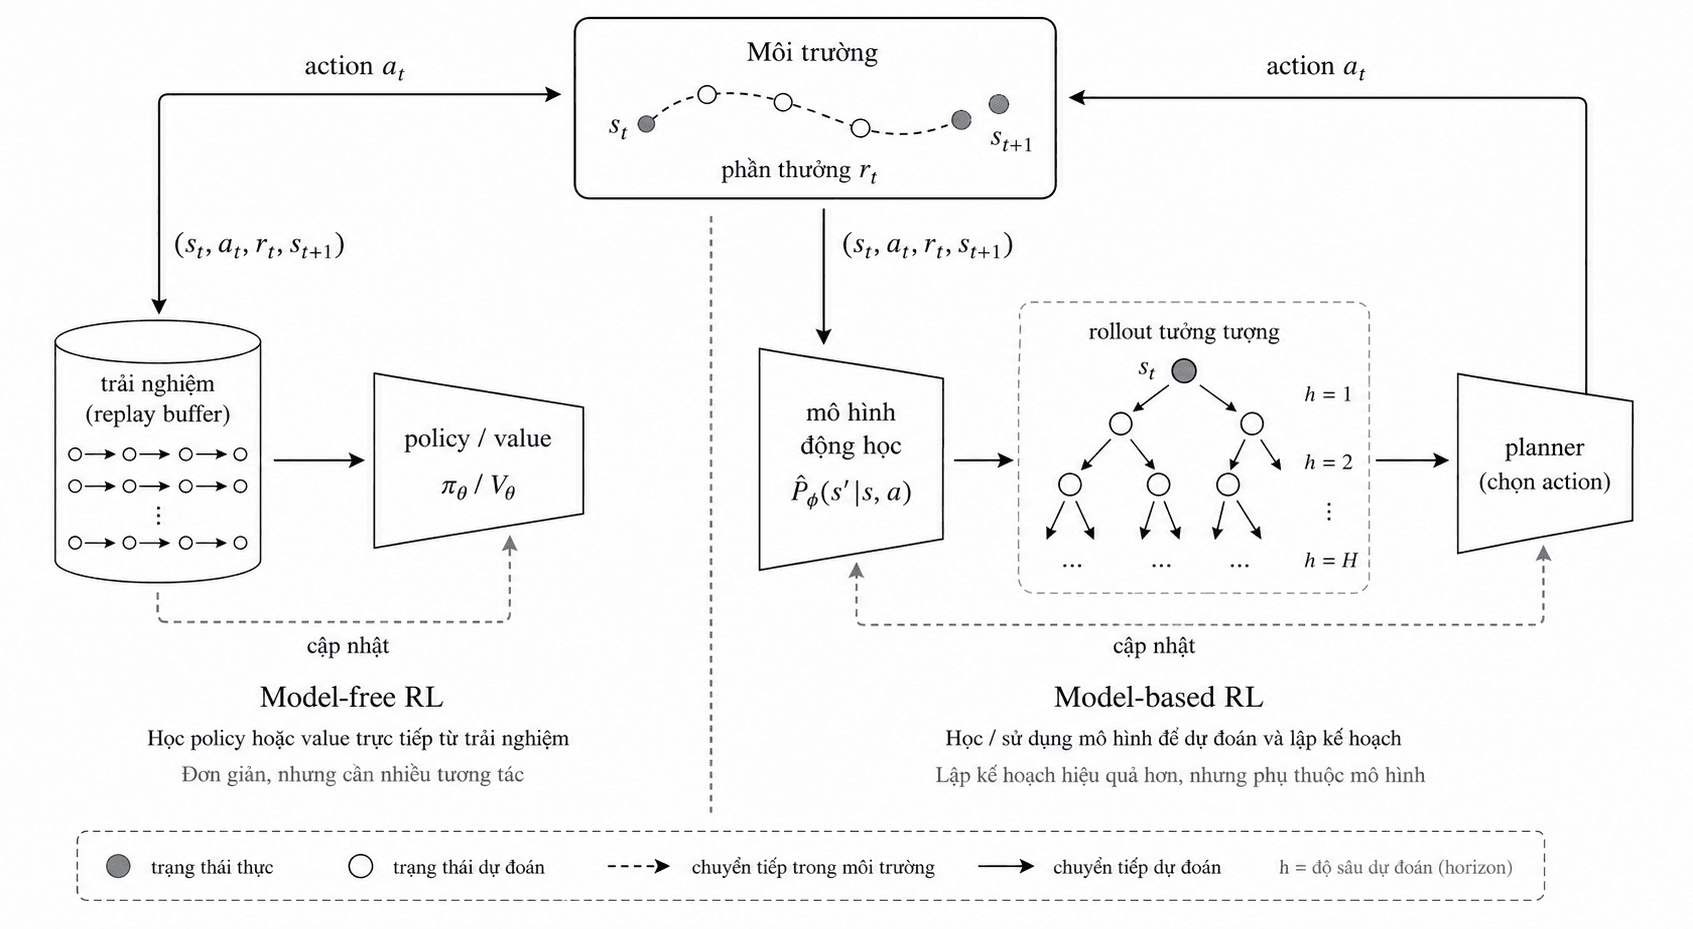
Đổi lại, model-based phụ thuộc vào chất lượng mô hình môi trường. Nếu mô hình dự đoán sai ma sát bánh xe, độ trễ điều khiển hoặc hành vi người đi bộ, kế hoạch sinh ra có thể đẹp trong mô phỏng nhưng kém ngoài đời thật. Model-free tránh việc mô hình hóa rõ ràng, nhưng trả giá bằng sample efficiency thấp. Nhiều hệ thống thực tế kết hợp cả hai: dùng model để lập kế hoạch ngắn hạn, dùng learning để cải thiện phần khó mô hình hóa.
Deep reinforcement learning
Khi state nhỏ và rời rạc, value function có thể được lưu trong bảng. Nhưng robot thật, game có hình ảnh, hệ thống recommendation hoặc mô phỏng điều khiển liên tục đều có state space quá lớn. Không thể tạo một hàng trong bảng cho mọi ảnh camera hoặc mọi cấu hình cảm biến. Deep reinforcement learning dùng neural network để xấp xỉ policy, value function hoặc model của environment.
Trong DQN, mạng neural nhận state và dự đoán Q-value cho các action rời rạc. Trong policy gradient và actor-critic, mạng có thể sinh trực tiếp action hoặc phân phối action. Với robotics, mạng đôi khi nhận ảnh, proprioception và goal, rồi trả về lệnh điều khiển liên tục. Deep learning mở rộng học tăng cường sang dữ liệu giàu hơn, nhưng cũng làm bài toán tối ưu khó hơn.
Khó khăn chính nằm ở sự kết hợp của ba yếu tố. Dữ liệu không độc lập vì các transition nằm trong cùng trajectory. Target học thay đổi vì policy đang được cập nhật liên tục. Reward có thể thưa, khiến gradient yếu hoặc nhiễu. Vì vậy, deep RL thường cần các thành phần ổn định hóa như replay buffer, target network, advantage estimation, entropy regularization hoặc constraint an toàn.
Ở mức tổng quát, deep RL không thay đổi bản chất của học tăng cường. Nó vẫn xoay quanh agent, environment, reward, policy và return. Neural network chỉ thay đổi cách biểu diễn các hàm cần học. Khi state phức tạp, biểu diễn học được là điều kiện để agent nhìn ra cấu trúc của môi trường. Nhưng nếu reward sai, exploration kém hoặc môi trường mô phỏng lệch thực tế, mạng lớn hơn không tự giải quyết được vấn đề.
Dữ liệu, mô phỏng và giới hạn
Học tăng cường hấp dẫn vì nó mô tả đúng nhiều bài toán ra quyết định: agent hành động, thấy hậu quả, rồi cải thiện hành vi. Nhưng chính điểm hấp dẫn đó cũng làm nó khó dùng. Dữ liệu trong RL thường đắt hơn dữ liệu supervised. Một nhãn ảnh sai có thể sửa trong dataset; một action sai của robot có thể làm gián đoạn vận hành hoặc gây hỏng thiết bị.
Vì vậy, nhiều hệ thống RL được huấn luyện trong mô phỏng trước. Simulation cho phép agent thử hàng triệu episode mà không gây rủi ro vật lý. Tuy nhiên, mô phỏng luôn có khoảng cách với thế giới thật. Ma sát, ánh sáng, độ trễ cảm biến, sai số actuator và hành vi con người đều khó mô hình hóa hoàn hảo. Khi policy học quá khớp với simulator, nó có thể suy giảm mạnh khi triển khai.
Reward design cũng là một giới hạn lớn. Agent không học điều ta “muốn” theo nghĩa mơ hồ; nó học tối ưu tín hiệu reward được viết ra. Nếu reward bỏ sót yếu tố an toàn, công bằng, chi phí hoặc ràng buộc vận hành, agent có thể tìm ra cách đạt điểm cao nhưng không phù hợp với mục tiêu thật. Đây không phải lỗi phụ, mà là vấn đề trung tâm của học tăng cường.
Ngoài ra, nhiều bài toán thực tế cần offline RL hoặc batch RL, nơi agent học từ log dữ liệu có sẵn thay vì tự do tương tác. Điều này an toàn hơn, nhưng làm xuất hiện một rủi ro khác: policy mới có thể chọn những action hiếm hoặc chưa từng xuất hiện trong dữ liệu log, khiến value estimate trở nên thiếu tin cậy. Khi không được thử trực tiếp, agent phải học trong vùng dữ liệu đã quan sát và tránh tự tin quá mức ở vùng chưa biết.
Nhìn rộng ra, học tăng cường không phải một thuật toán đơn lẻ. Nó là một nhánh nghiên cứu về học hành vi trong môi trường có phản hồi và hậu quả dài hạn. Q-learning, policy gradient, actor-critic, model-based RL, offline RL, multi-agent RL hay RLHF đều là các hướng phát triển khác nhau từ cùng một khung: agent phải chọn action trong state hiện tại sao cho chuỗi kết quả tương lai tốt hơn. Sức mạnh của RL nằm ở việc đặt đúng câu hỏi về quyết định tuần tự; độ khó của RL nằm ở việc biến câu hỏi đó thành một hệ thống học ổn định, an toàn và đủ dữ liệu.