Mô hình VLA (Vision-Language-Action)
Vài năm gần đây, robotics bắt đầu đi theo một hướng đã rất quen trong NLP và computer vision. Thay vì chia hệ thống thành nhiều mô-đun nhỏ rồi nối chúng lại bằng rule, người ta huấn luyện một mô hình lớn hơn trên nhiều dữ liệu hơn để nó học trực tiếp ánh xạ từ quan sát sang đầu ra cần thiết. Với robot, đầu ra đó không còn là caption, class label hay bounding box. Nó là hành động.
VLA xuất hiện trong bối cảnh đó. Vision-Language-Action model nhận ảnh, nhận thêm chỉ dẫn ngôn ngữ, rồi sinh ra action cho robot. Ở mức trừu tượng, đây là một policy được điều kiện hóa bởi thị giác và ngôn ngữ. Ở mức hệ thống, nó kéo ba phần vốn thường đứng khá xa nhau trong robot truyền thống, perception, hiểu lệnh và control, lại gần nhau hơn trong cùng một mô hình học được.
Điểm khiến VLA đáng chú ý không chỉ là chuyện "gom nhiều thứ vào một chỗ". Điều quan trọng hơn là nó mở ra khả năng tận dụng tri thức thị giác-ngôn ngữ đã học từ dữ liệu web, rồi đưa phần tri thức đó vào bài toán điều khiển. Khi ta yêu cầu robot "nhặt cái cốc màu đỏ phía sau chai nước" hoặc "đặt khối nhỏ nhất vào khay", bài toán không còn là servoing thuần túy nữa. Robot phải gắn ngôn ngữ với vật thể trong ảnh, hiểu quan hệ không gian, rồi từ đó chọn ra hành động tiếp theo. Đó chính là vùng giao nhau mà các công trình như RT-2 muốn khai thác.
Hạn chế của pipeline robot truyền thống trong môi trường mở
Trong một stack robot cổ điển, bài toán thao tác thường bị tách thành nhiều lớp: perception phát hiện object, language parser đọc lệnh, task planner chọn bước, motion planner tìm quỹ đạo, còn low-level controller bám quỹ đạo đó.
Mỗi khối riêng lẻ có thể làm rất tốt phần việc của mình. Vấn đề là sai số tích lũy qua từng lớp. Detector nhầm object thì planner đi sai nhánh. Parser bỏ sót quan hệ không gian thì task planner chọn nhầm mục tiêu. Calibration giữa camera và robot lệch một chút cũng có thể làm cú grasp cuối cùng thất bại. Càng nhiều interface do con người thiết kế thủ công, hệ càng có nhiều chỗ phải tinh chỉnh.
Với những cell công nghiệp cố định, cách làm này vẫn rất hiệu quả. Nhưng khi ta muốn robot xử lý nhiều object hơn, nhiều bố cục bàn khác nhau hơn, nhiều kiểu câu lệnh hơn, hoặc thậm chí nhiều embodiment khác nhau, pipeline tách rời bắt đầu lộ rõ sự cứng nhắc.
VLA không xóa bỏ hoàn toàn stack cổ điển. Motion planning, safety controller, IK, force control và collision checking vẫn còn đó trong nhiều hệ thực. Thứ nó thay đổi là phần policy ở phía trên. Thay vì định nghĩa quá sớm một tầng trung gian biểu tượng rồi buộc hệ phải đi qua tầng đó, ta để mô hình học trực tiếp từ trajectory robot và instruction ngôn ngữ.
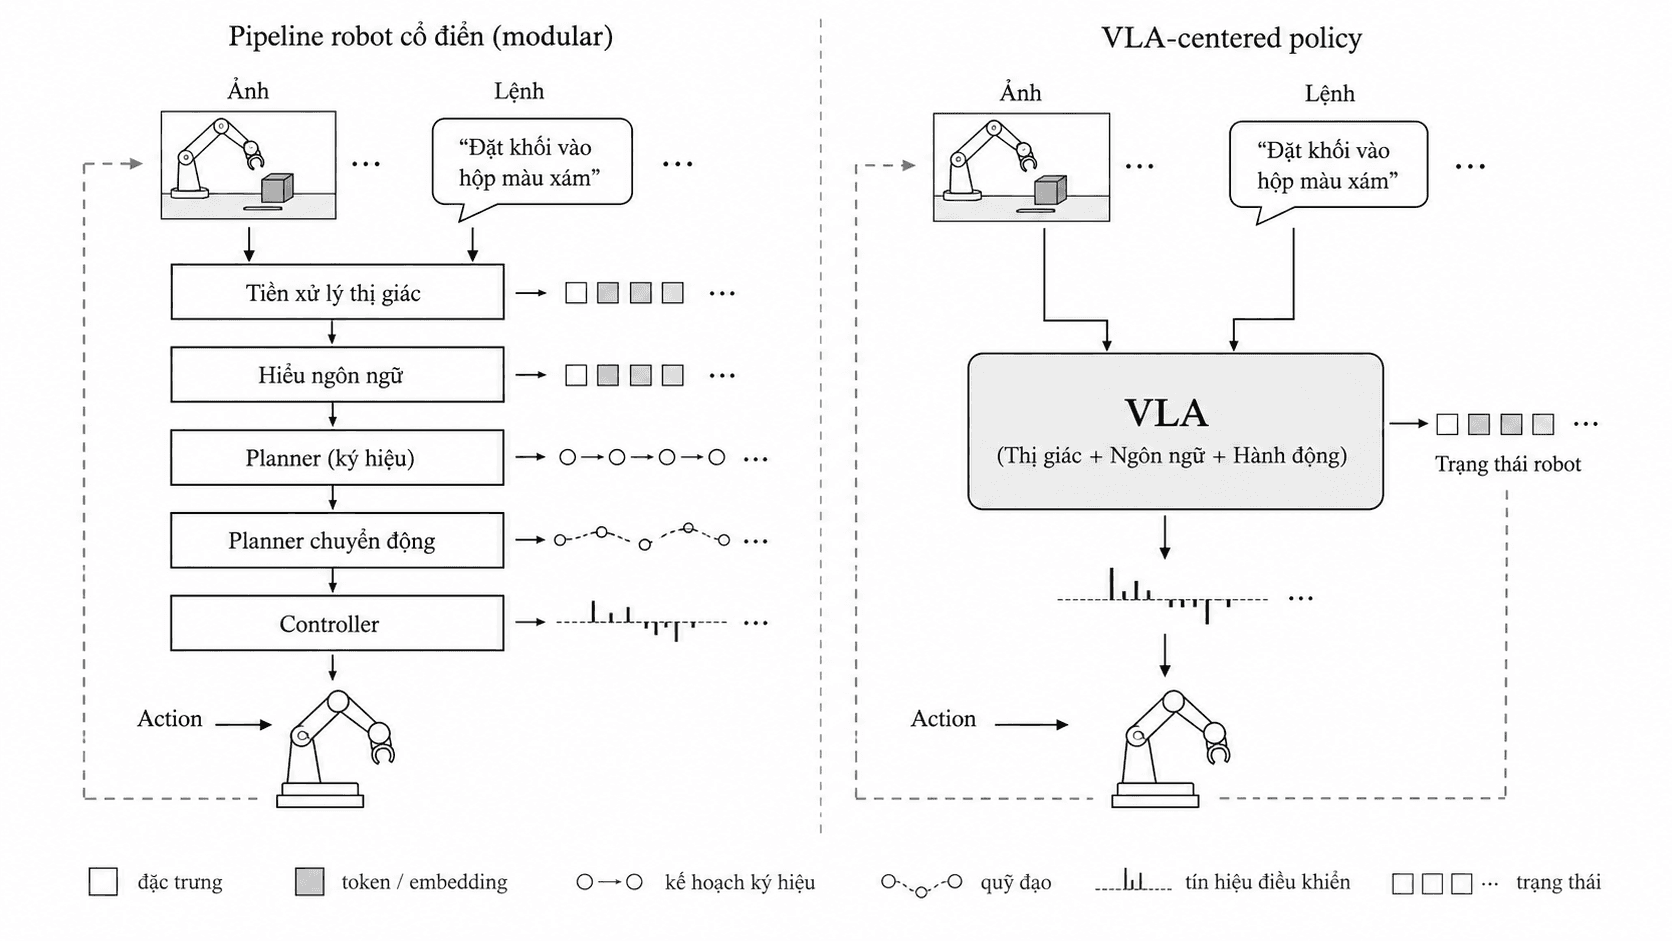
Nếu nhìn từ first principles, bản chất bài toán không hề đổi: robot vẫn phải chọn ra một chuỗi action để tăng xác suất hoàn thành nhiệm vụ. Khác ở chỗ trạng thái đầu vào không còn bị nén sẵn thành một state vector "sạch sẽ" do kỹ sư tự tay thiết kế. Nó có thể là ảnh RGB, proprioception, text instruction và cả lịch sử quan sát gần đó.
Mô hình hóa VLA dưới dạng policy có điều kiện
Ở mức trừu tượng nhất, ta có thể viết VLA dưới dạng:
Trong đó:
- là policy với tham số .
- là action tại thời điểm .
- là quan sát hiện tại, thường gồm ảnh từ một hoặc nhiều camera.
- là instruction ngôn ngữ.
- là lịch sử trước đó: các frame cũ, action cũ, hoặc hidden state nội bộ.
Trong nhiều hệ, đầu ra không chỉ là một action đơn lẻ mà là một action chunk:
Trong đó:
- là một đoạn hành động tương lai dài bước.
- là horizon của action chunk.
Lý do dùng action chunk khá thực tế. Vòng lặp điều khiển của robot thường chạy nhanh hơn đáng kể so với thời gian suy luận của một mô hình lớn. Nếu mô hình chỉ dự đoán đúng một action rồi dừng lại chờ ảnh mới, throughput sẽ không đủ cho nhiều tác vụ thật. Dự đoán trước một đoạn hành động giúp robot tiếp tục di chuyển trong vài bước tiếp theo, rồi replan lại theo kiểu receding horizon.
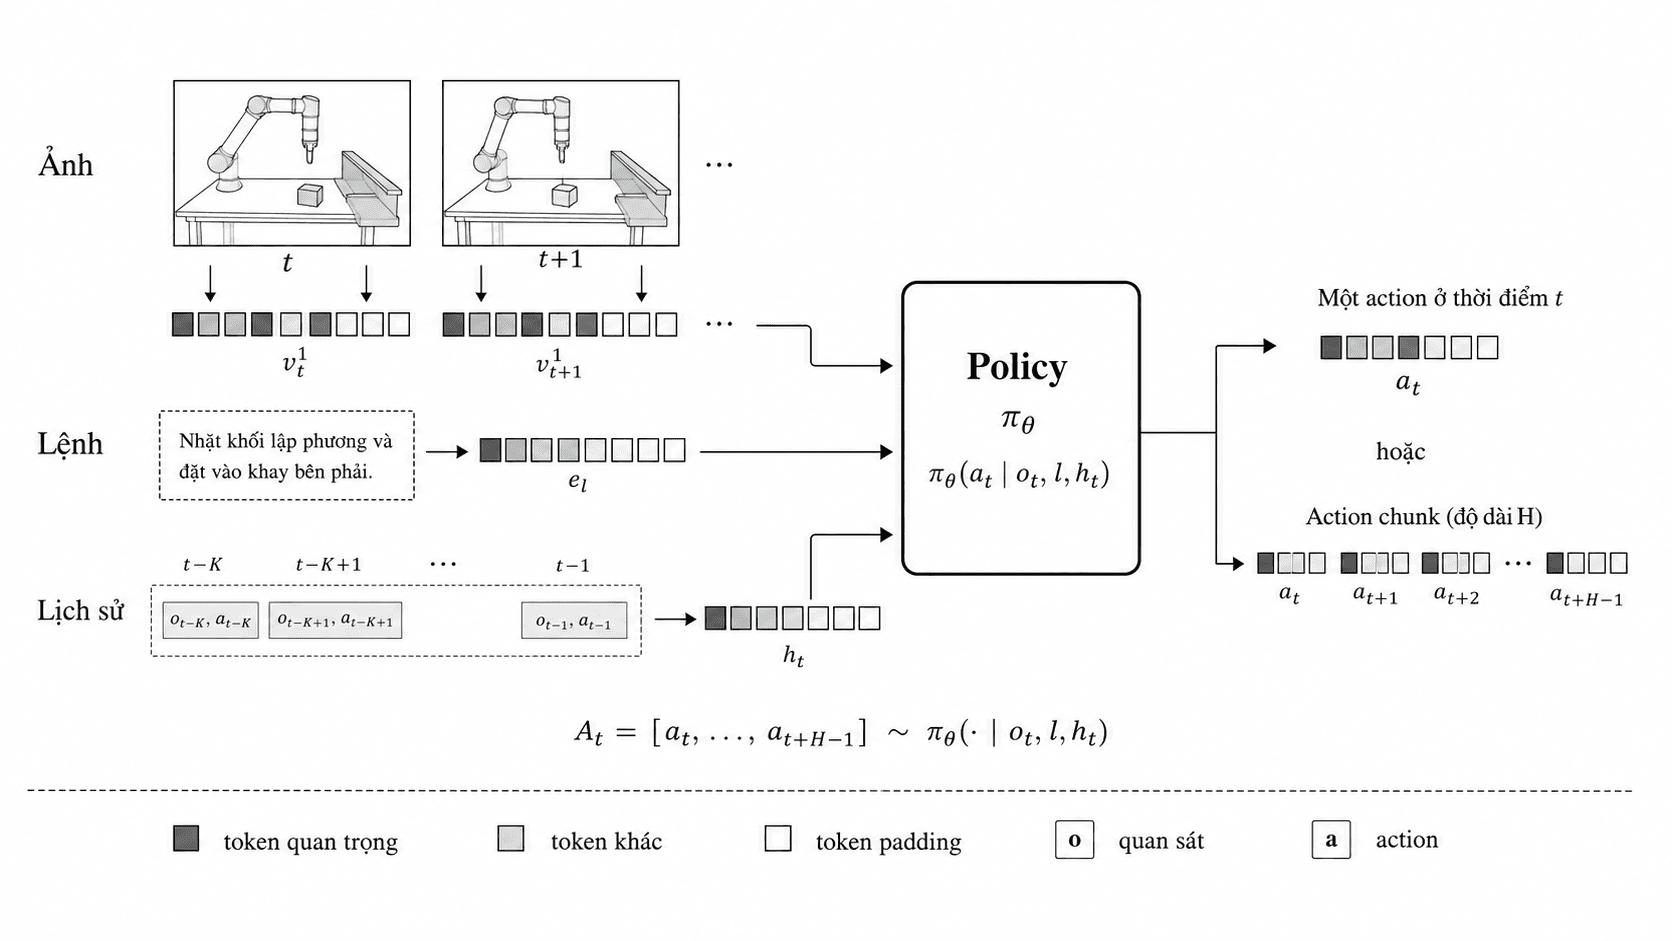
Điều cần giữ rất rõ ở đây là VLA không phải chỉ là một VLM gắn thêm đầu ra điều khiển nhỏ ở phía sau. Một khi mô hình phải thực sự phát action cho robot, representation của action space, cách đưa proprioception vào mô hình, độ dài history và tần số điều khiển đều trở thành quyết định trung tâm.
Dữ liệu huấn luyện cho Vision-Language-Action Models
Dữ liệu nền tảng của VLA không phải ảnh tĩnh kèm caption. Nó là trajectory:
Trong đó:
- là một trajectory thực hiện nhiệm vụ.
- là quan sát ở bước .
- là instruction gắn với cả episode hoặc một đoạn của episode.
- là action của robot ở bước .
- là chiều dài trajectory.
Trong robot manipulation, o_t thường không chỉ là một ảnh. Nó có thể gồm camera ngoài nhìn toàn cảnh bàn, wrist camera nhìn gần end-effector, trạng thái gripper, joint angles, joint velocities và pose end-effector.
Điểm quan trọng là dữ liệu robot đắt hơn dữ liệu web rất nhiều. Mỗi episode đều cần phần cứng thật hoặc một môi trường mô phỏng đủ sát. Vì vậy, nhiều công trình VLA hiện nay dựa trên hai nguồn tri thức khác nhau: tri thức perception-language từ pretraining lớn trên dữ liệu web, và tri thức hành động từ robot trajectories.
RT-1 cho thấy giá trị của robot data khi đủ lớn và đủ đa dạng. RT-2 đi thêm một bước khi đồng huấn luyện với vision-language data để chuyển tri thức semantic từ web vào control. OpenVLA tiếp tục đẩy hướng này theo tinh thần open-source và fine-tuning thực dụng hơn.
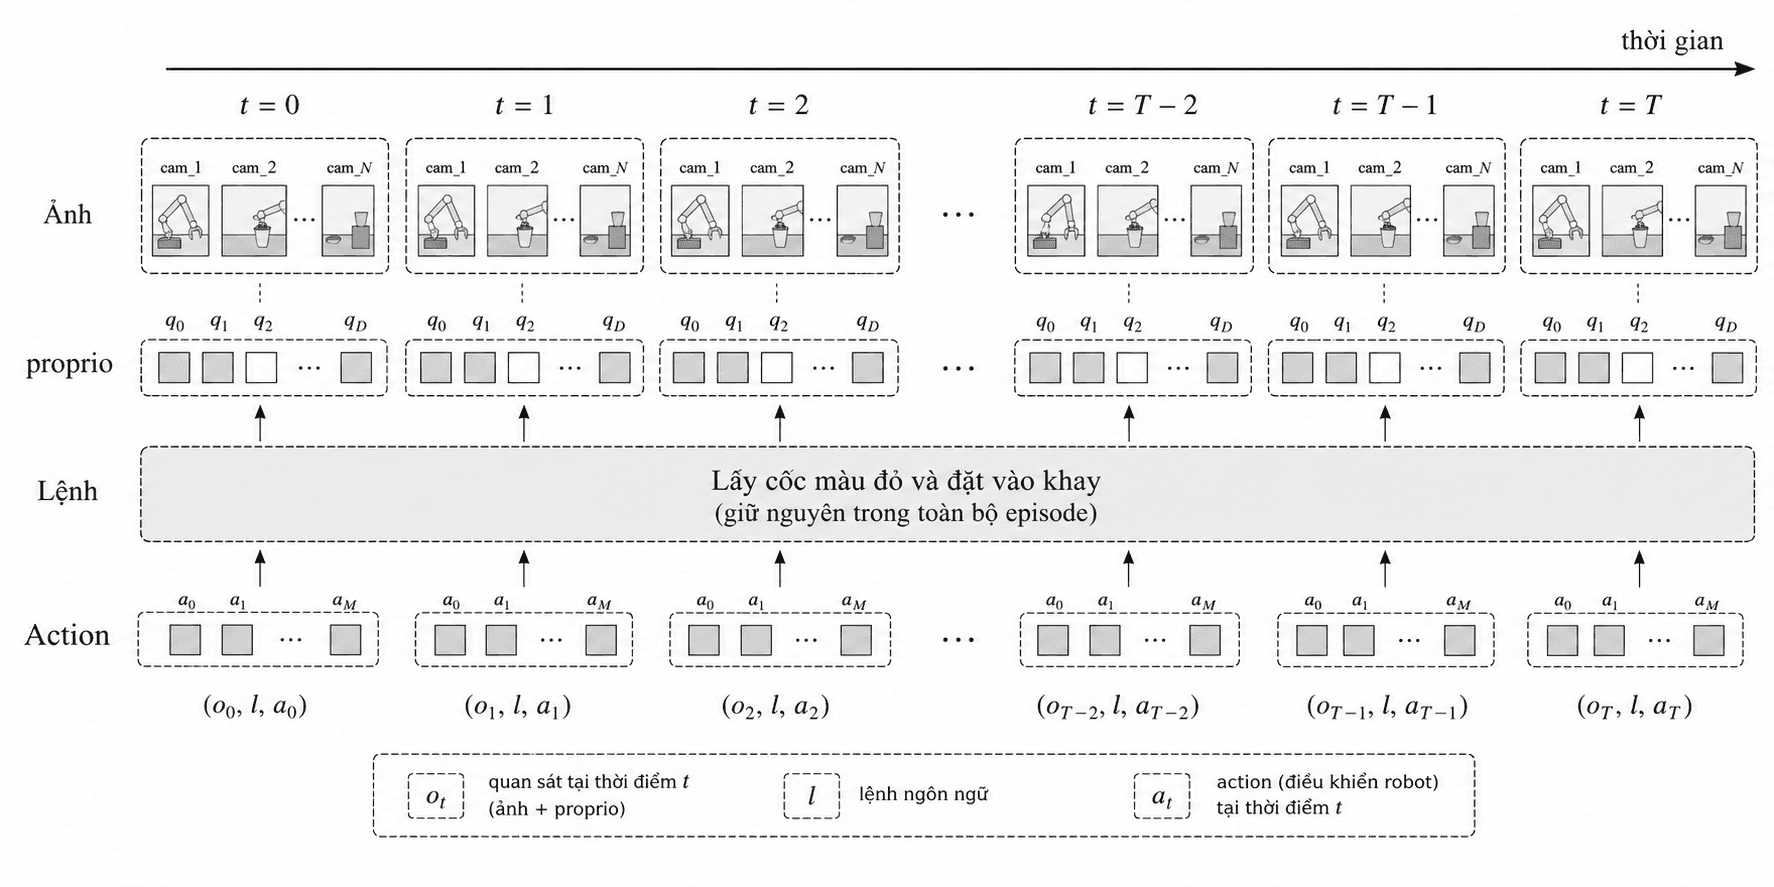
Khi đọc một paper VLA, đừng dừng lại ở số tham số. Nên hỏi thêm trajectory được thu như thế nào, có bao nhiêu embodiment, action frequency là bao nhiêu, instruction được gắn ở mức episode hay từng đoạn, proprioception có được dùng không, và robot policy học từ teleoperation, scripted policy hay replay từ controller khác. Những chi tiết đó quyết định rất mạnh mô hình thực sự học được gì.
Biểu diễn action trong các mô hình VLA
Trong NLP, token là thứ gần như hiển nhiên. Trong robotics, action representation mới là nơi thiết kế có thể rẽ sang rất nhiều hướng. Ta có thể dùng action liên tục trực tiếp, lượng tử hóa action thành token rời rạc, dự đoán action chunk nhiều bước, dùng delta pose của end-effector, delta joint, hoặc tách riêng trạng thái open/close của gripper.
Một action liên tục có thể được viết:
Trong đó:
- là dịch chuyển end-effector.
- là thay đổi orientation.
- là trạng thái gripper.
RT-2 chọn một hướng rất đáng chú ý: biểu diễn action dưới dạng text token để dùng chung cơ chế sinh chuỗi với vision-language model. Ý tưởng này nghe hơi lạ nếu nhìn từ robotics truyền thống, nhưng nó giải quyết một vấn đề rất thực dụng: đưa "ngôn ngữ" và "hành động" về cùng một interface autoregressive.
OpenVLA đại diện cho một hướng khác. Nó nhấn mạnh một backbone mở, lớn hơn, dễ fine-tune hơn và gần hơn với câu chuyện dùng thật. Điều này nhắc ta rằng "VLA" không phải tên của một kiến trúc duy nhất. Nó là cả một họ thiết kế, trong đó action representation và cách ghép backbone với robot policy là hai quyết định rất lớn.
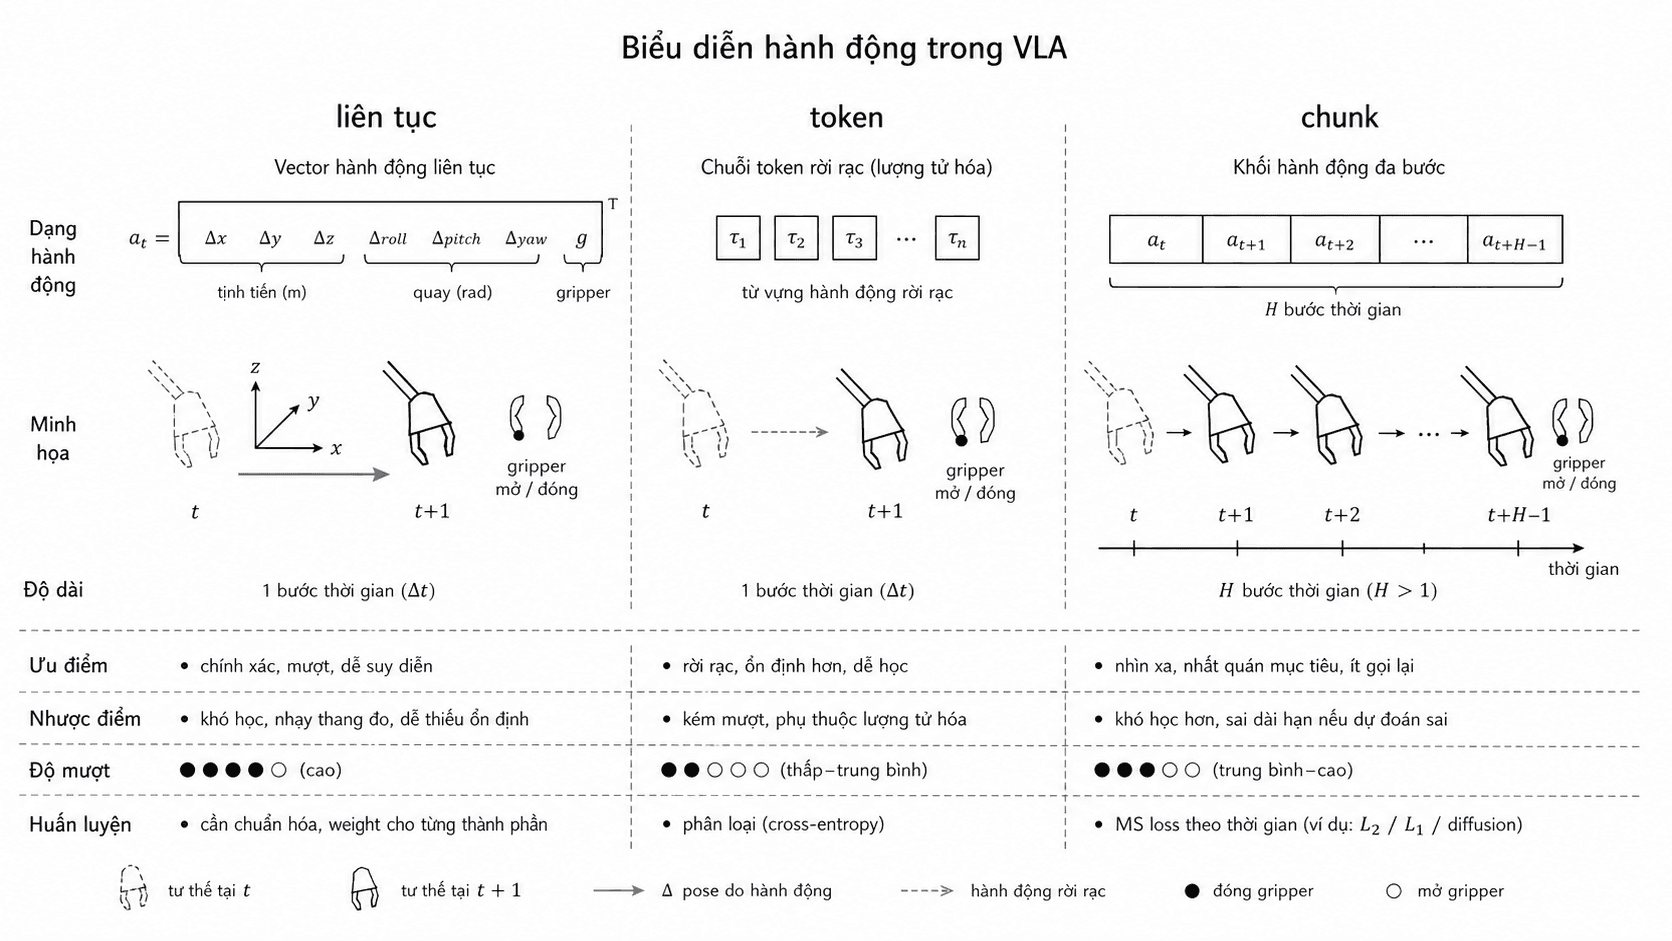
Chỉ cần đổi action representation, hành vi của hệ có thể khác đi đáng kể. Một policy delta pose nhìn bài toán khác hẳn một policy joint-space. Một hệ dự đoán action token cũng không vận hành giống một hệ hồi quy trực tiếp vector liên tục.
Kiến trúc mô hình kết hợp thị giác, ngôn ngữ và hành động
Nhiều VLA hiện đại có một bố cục khá quen: visual encoder biến ảnh thành visual tokens, language model hoặc transformer backbone xử lý instruction và context, rồi head phía sau sinh action token hoặc action vector.
Nếu viết ở mức trừu tượng:
Trong đó:
- là visual encoder.
- là thành phần xử lý ngôn ngữ.
- là embedding từ ảnh.
- là embedding từ instruction.
- là khối hợp nhất để sinh action.
Triển khai cụ thể có thể khác nhau khá nhiều. Có hệ nối token ảnh và token ngôn ngữ vào cùng một chuỗi rồi chạy self-attention chung. Có hệ dùng cross-attention. Có hệ thêm proprioception như một loại token riêng. Cũng có hệ xen lịch sử frame hoặc previous action vào context window.
Đó là lý do VLA không thể được hiểu chỉ bằng một sơ đồ high-level. Muốn hiểu mô hình thực sự hoạt động ra sao, ta cần biết ảnh được patch hóa như thế nào, history dài bao nhiêu bước, action head là autoregressive hay feedforward, proprioception đi vào ở đâu, latency inference là bao nhiêu và hệ có dùng action chunk hay không.
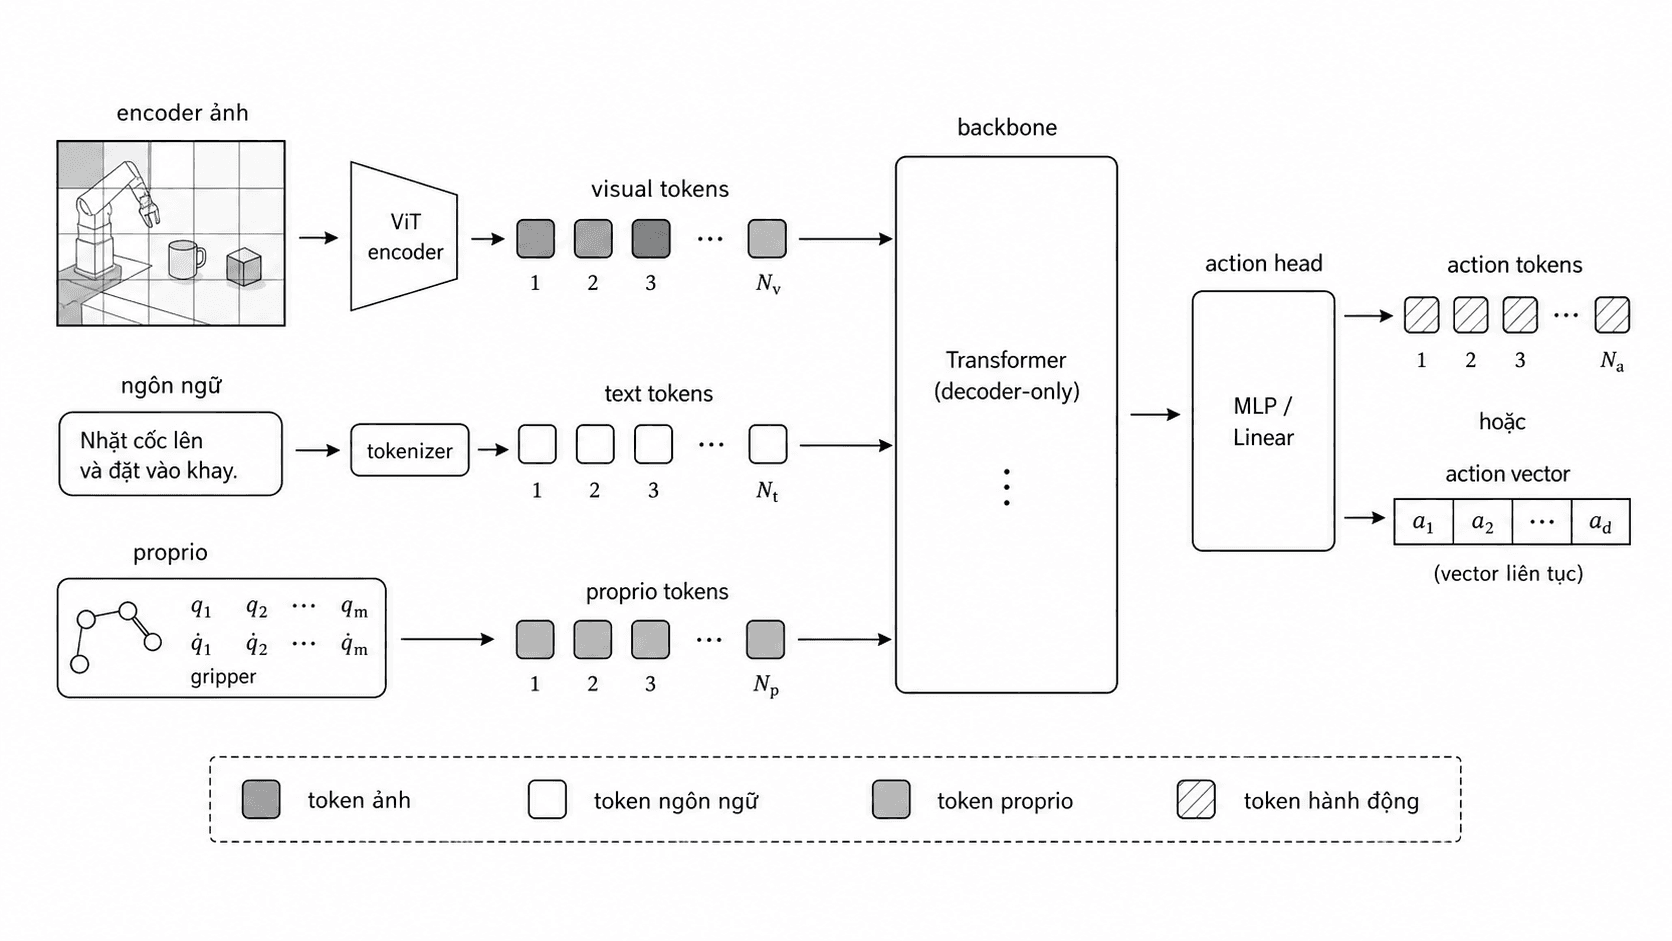
Cũng nên tách bạch giữa chuyện "hiểu ngôn ngữ" và chuyện "thực thi lệnh". Một language backbone có thể rất mạnh ở semantic reasoning, nhưng nếu action head yếu hoặc dữ liệu robot nghèo, policy vẫn có thể thất bại ở bước grasp hay placement cuối cùng. Robotics luôn kéo câu chuyện trở lại mặt đất ở đúng chỗ đó.
Hàm mục tiêu huấn luyện trong VLA
Mức tối thiểu, một VLA có thể được huấn luyện bằng imitation learning:
Trong đó:
- là loss behavior cloning.
- là hàm lỗi giữa action dự đoán và action mẫu.
- kỳ vọng được lấy trên các mẫu trong robot dataset.
Nếu action là liên tục, có thể là L1 hoặc L2 loss. Nếu action đã token hóa, loss có thể là cross-entropy trên token action. Nhưng với VLA, câu chuyện hiếm khi dừng ở một loss duy nhất.
RT-2 cho thấy một hướng rất quan trọng: đồng huấn luyện hoặc fine-tune trên cả dữ liệu robotics và vision-language tasks. Cách làm này cho phép mô hình giữ lại năng lực semantic từ web data, đồng thời học cách biến tri thức đó thành control signal.
Ta có thể viết khái quát:
Trong đó:
- là loss trên trajectory robot.
- là loss trên dữ liệu vision-language.
- là hệ số cân bằng.
Điểm khó không nằm ở công thức, mà ở chỗ hai miền dữ liệu này có thống kê rất khác nhau. Nếu robot data quá ít, mô hình có thể "hiểu" câu lệnh nhưng phát action không chắc tay. Nếu chỉ chăm chăm vào robot data nhỏ, mô hình lại dễ mất bớt phần tri thức semantic mà pretraining web đem lại.
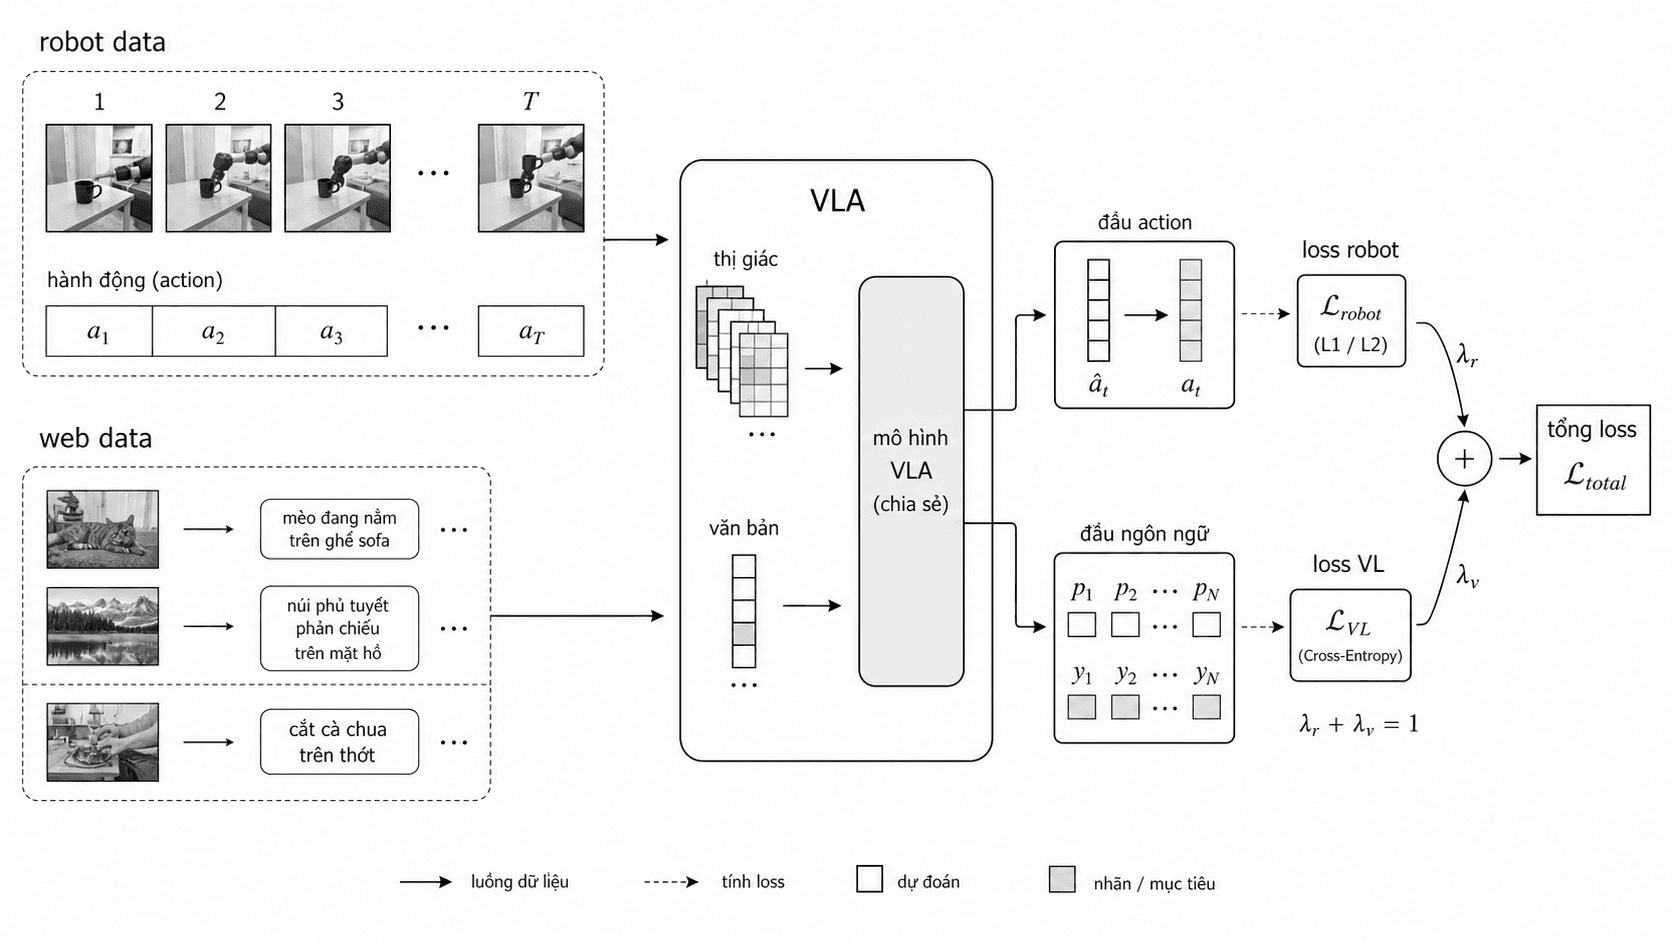
Chính ở điểm này, các công trình như RT-2 tạo ra bước ngoặt về mặt nhận thức: thay vì xem language grounding là thứ nằm ngoài policy, họ đưa nó vào ngay bên trong policy.
Cơ chế suy luận và thực thi action trong control loop
Một mô hình có thể rất đẹp trên paper nhưng vẫn khó dùng nếu inference quá chậm. Robot không chờ model "nghĩ thêm một lúc". Camera vẫn đổ frame, vật thể vẫn di chuyển, gripper vẫn đang đóng hoặc mở.
Vì vậy, inference của VLA thường đi cùng một vòng lặp receding horizon. Robot đọc ảnh và proprioception mới, đưa instruction cùng context vào mô hình, sinh ra một action hoặc một action chunk, thực thi một phần của chunk đó, rồi quan sát lại để replan.
Nếu viết gọn:
Trong đó:
- là action chunk dự đoán.
- là số action đầu được thực thi trước khi replan lại.
Chọn quá lớn thì robot phản ứng chậm với thay đổi của môi trường. Chọn quá nhỏ thì chi phí inference lại nặng. Đây là một đánh đổi thuần hệ thống, không chỉ là chuyện của mô hình.
Khi đưa hệ vào deployment, còn rất nhiều thứ đời thường phải kiểm soát: camera latency, timestamp lệch giữa ảnh và proprioception, frame drop, rolling shutter, action clipping, workspace limit và safety stop. Một policy VLA mạnh trên benchmark nhưng không kiểm soát được các chi tiết này vẫn có thể rất khó dùng trong cell thật.
Vai trò của RT-1, RT-2 và OpenVLA trong phát triển VLA
RT-1 đáng nhớ vì nó cho thấy khá rõ một dạng scale law cho robot policy: khi dữ liệu robot đủ lớn, đủ đa dạng và kiến trúc đủ sức chứa, khả năng generalization trên control thực tế cải thiện rõ rệt. Chỉ riêng điều đó đã là một thay đổi quan trọng so với cách nghĩ rằng robot policy luôn phải nhỏ và chuyên biệt.
RT-2 đẩy thêm một bước quan trọng về mặt ý niệm. Nó không chỉ mở rộng robot data, mà còn cố chuyển tri thức semantic từ web-scale vision-language pretraining vào action generation. Nói cách khác, nó làm cho câu chuyện "hiểu ảnh, hiểu lệnh, rồi hành động" trở thành một mô hình thống nhất hơn.
OpenVLA lại có ý nghĩa theo hướng khác. Nó làm cho câu chuyện này bớt mang màu sắc "chỉ vài lab lớn mới làm được". Một mô hình mở, có code, có checkpoint và có đường fine-tune thực tế giúp cộng đồng có thứ để cầm lên, sửa tiếp và đo đạc lại trên chính hệ của mình.
Nếu nhìn ba cái tên này như ba cột mốc, ta có thể nhớ ngắn gọn như sau:
- RT-1 nhấn mạnh quy mô dữ liệu robot và policy generalist.
- RT-2 nhấn mạnh việc chuyển tri thức vision-language sang control.
- OpenVLA nhấn mạnh openness, fine-tuning và khả năng dùng rộng hơn.
Các failure mode thường gặp khi triển khai VLA ngoài benchmark
VLA nghe có vẻ rất "end-to-end", nhưng robot thật thì không hiền như vậy. Một số failure mode lặp đi lặp lại khá rõ: language grounding đúng nhưng grasp sai vì perception gần end-effector chưa đủ chắc; action chunk hợp lý ở đầu nhưng đi quá đà ở cuối vì môi trường đã đổi; mô hình bám vào texture hoặc bố cục bàn quen thuộc từ training; object mới có ngôn ngữ đúng nhưng affordance lạ; embodiment mới làm action distribution lệch mạnh; hoặc latency inference khiến control loop hụt nhịp.
Một ví dụ rất điển hình là mô hình hiểu đúng câu "nhặt cốc đỏ phía sau chai nước", nhưng wrist camera bị glare hoặc chai nước che mất mép cốc. Tầng semantic đã làm đúng việc của nó, còn tầng execution vẫn trượt.
Một ví dụ khác là dataset có rất nhiều hành vi như lau bàn, mở ngăn kéo hay đặt vật vào hộp, nhưng hầu hết đều được thu trên cùng một loại gripper và một mặt bàn gần giống nhau. Khi chuyển sang embodiment khác, distribution shift có thể đánh mạnh hơn ta tưởng.
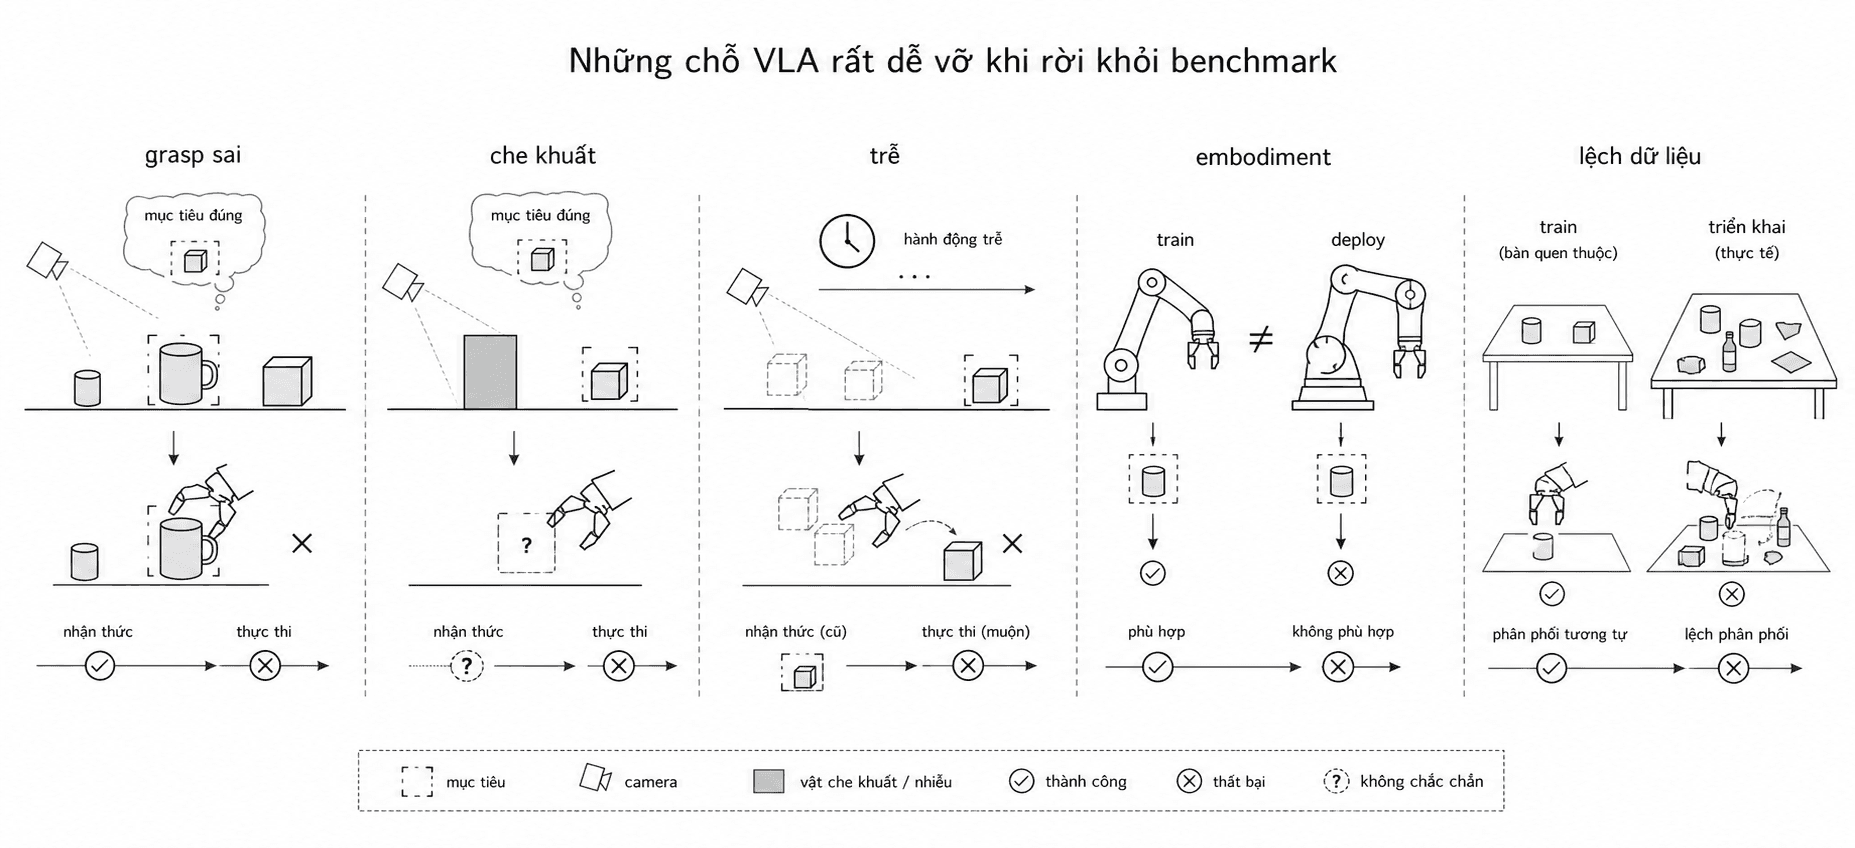
Vì vậy, nhiều hệ VLA thực tế vẫn đặt thêm guardrail ở ngoài policy: workspace bounding, collision checker đơn giản, grasp validator, replan threshold, confidence threshold và human override.
Một hệ robot tốt không nhất thiết phải "thuần end-to-end". Nhiều khi nó là một sự thỏa hiệp khôn ngoan giữa policy học được và những lớp an toàn đủ cứng để giữ hệ vận hành ổn định.