Visual Odometry
Khi một robot chạy trong nhà xưởng, encoder bánh xe cho ta biết bánh đã quay bao nhiêu vòng. Nhưng bánh xe có thể trượt. IMU cho ta biết gia tốc và vận tốc góc, nhưng nhiễu tích lũy rất nhanh. Camera thì khác: nó nhìn thấy cấu trúc của môi trường. Nếu robot đi qua một hàng kệ, các góc kệ, mép thùng, vạch sàn và nhãn hàng dịch chuyển trong ảnh theo một quy luật hình học nhất định. Visual odometry khai thác chính sự dịch chuyển đó để ước lượng camera đã đi như thế nào.
Nói ngắn gọn, visual odometry là bài toán khôi phục chuyển động tương đối của camera từ một chuỗi ảnh. Ta không cần nhận diện “đây là cái kệ” hay “đây là cái thùng”. Ta chỉ cần các điểm, cạnh hoặc vùng ảnh đủ ổn định để tìm lại giữa những frame liên tiếp. Từ các tương ứng hình ảnh đó, ta suy ra chuyển động của camera trong không gian.
💡 Info: Visual odometry không thay thế toàn bộ SLAM. Nó thường là phần “đo chuyển động cục bộ” rất quan trọng bên trong một hệ SLAM lớn hơn.
Hạn chế của encoder và IMU trong dead reckoning
Hãy lấy một robot kéo hàng chạy trên nền bê tông. Khi bánh xe lăn đều, encoder cho kết quả khá tốt. Nhưng chỉ cần sàn bụi, bánh mòn, robot kéo tải nặng hoặc cua gấp, bánh có thể trượt một đoạn nhỏ. Encoder vẫn tin rằng bánh đã lăn đúng quãng đường, trong khi thân robot thực tế đi ít hơn hoặc lệch hướng.
IMU giúp đo quay và gia tốc, nhưng để lấy vị trí từ gia tốc ta phải tích phân hai lần. Sai số bias nhỏ trong gia tốc sẽ biến thành sai số vị trí lớn sau vài chục giây. Vì vậy, nếu chỉ dựa vào dead reckoning từ encoder và IMU, quỹ đạo thường trôi dần.
Camera đưa vào một loại ràng buộc khác. Nếu một góc kệ xuất hiện ở frame và tiếp tục xuất hiện ở frame , vị trí pixel của nó thay đổi vì camera đã di chuyển. Khi có nhiều điểm như vậy, chuyển động camera không còn là một con số đo từ bánh xe, mà là một biến phải nhất quán với hình học của cả cảnh.
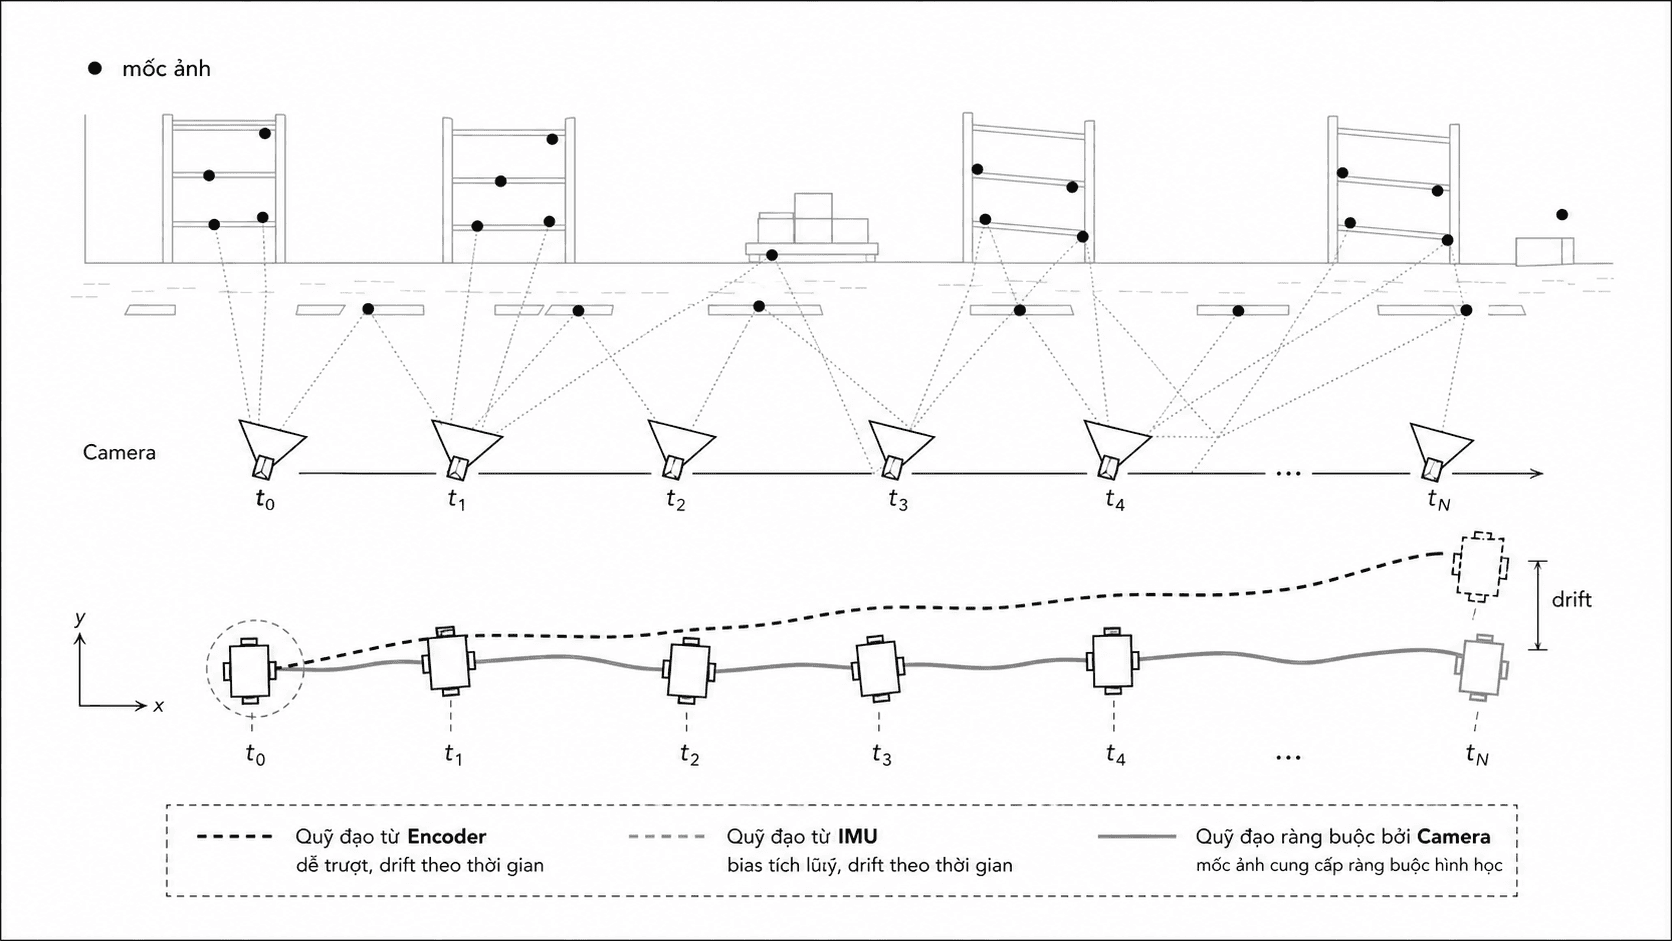
Trong hệ robot thật, visual odometry thường không đứng một mình. Nó được fuse với IMU, encoder, GPS, lidar hoặc map có sẵn. Nhưng hiểu visual odometry trước giúp ta thấy rõ phần hình học nằm ở đâu, và vì sao một vài match ảnh sai có thể kéo cả quỹ đạo đi lệch.
Mô hình chiếu ảnh và chuyển động tương đối của camera
Trước khi nói camera chuyển động ra sao, ta cần nhắc lại camera nhìn thế giới như thế nào. Một điểm 3D trong hệ camera có tọa độ:
Với pinhole camera, điểm này chiếu lên mặt ảnh theo:
Trong đó:
- là tọa độ pixel ở dạng homogeneous.
- là ma trận nội tại camera, chứa tiêu cự và tâm ảnh.
- là tọa độ của điểm trong hệ camera.
- Phép chia cho thể hiện hiệu ứng phối cảnh: vật càng xa thì dịch chuyển trên ảnh càng nhỏ.
Nếu camera di chuyển từ frame này sang frame kế tiếp, cùng một điểm 3D sẽ có tọa độ khác trong hệ camera mới. Gọi chuyển động tương đối là , với là rotation và là translation:
Trong đó:
- là tọa độ điểm trong hệ camera cũ.
- là tọa độ điểm trong hệ camera mới.
- xoay hệ tọa độ.
- tịnh tiến hệ tọa độ.
Visual odometry đi ngược chiều phép chiếu này. Ta quan sát pixel thay đổi trong ảnh, rồi tìm sao cho chuyển động đó hợp lý nhất với các tương ứng ảnh.
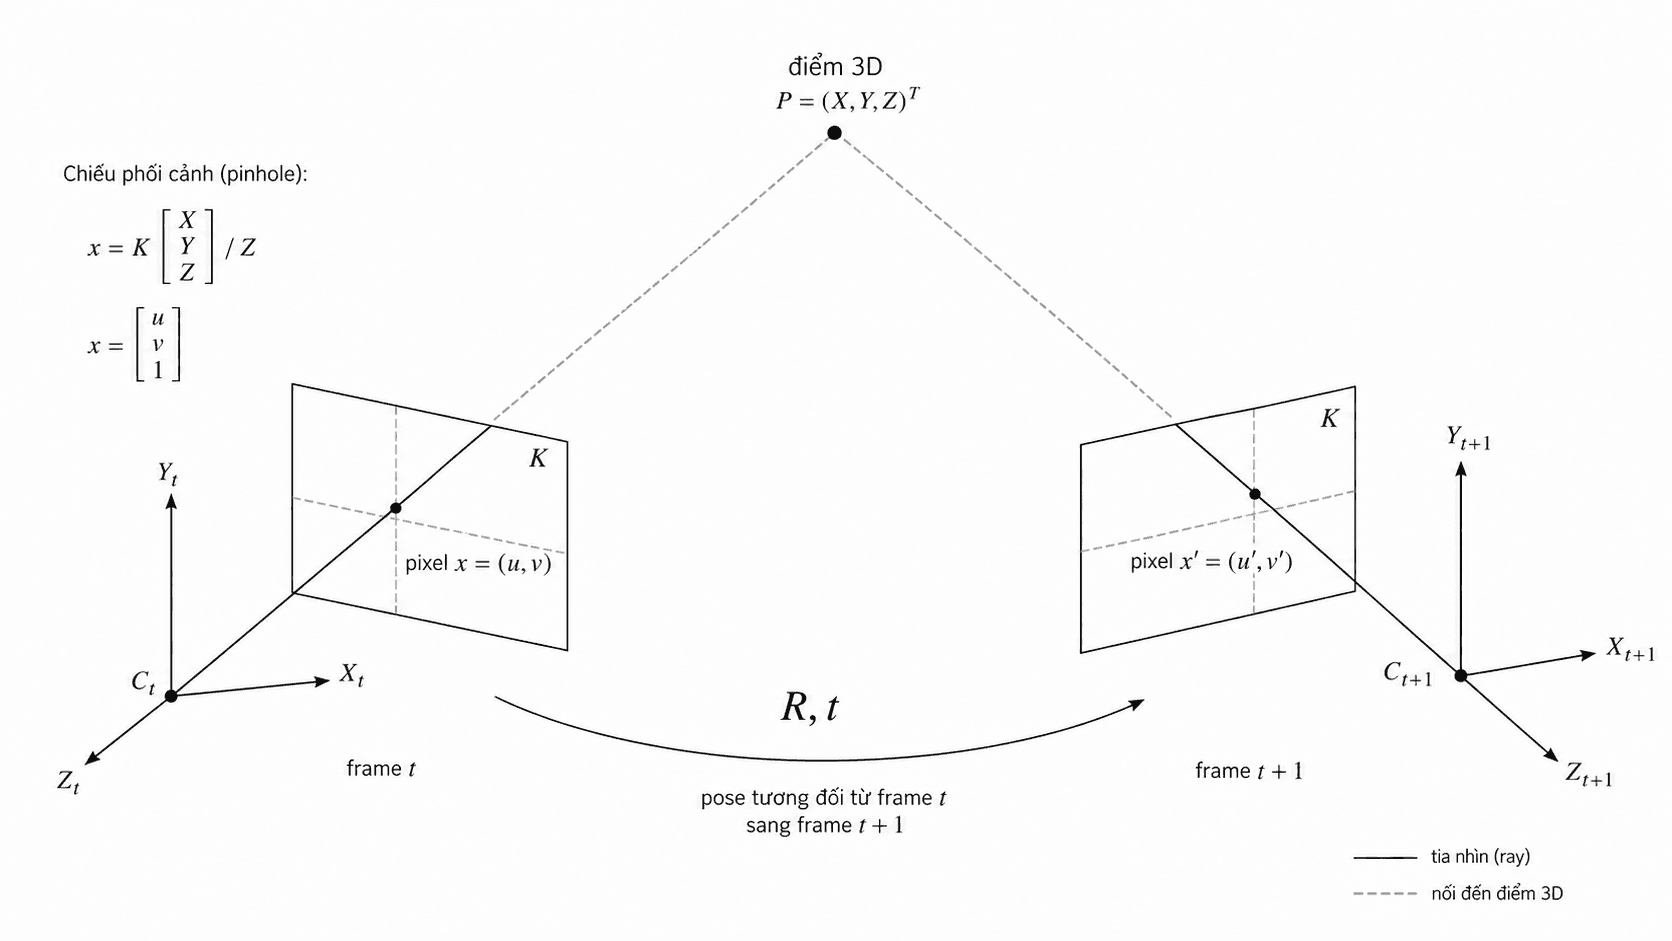
Điều làm bài toán khó là ta không trực tiếp thấy độ sâu của từng điểm nếu chỉ dùng một camera đơn. Ta chỉ thấy pixel. Vì thế monocular visual odometry luôn phải xử lý một vấn đề nhạy cảm: scale.
Ước lượng chuyển động từ tương ứng điểm ảnh giữa hai frame
Một pipeline visual odometry cổ điển thường bắt đầu bằng matching. Ở frame , ta phát hiện keypoints và descriptor. Ở frame , ta làm lại việc đó. Sau đó ta tìm các cặp điểm tương ứng:
Trong đó:
- là pixel của điểm thứ ở frame đầu.
- là pixel tương ứng ở frame sau.
- Cặp được lấy từ feature matching hoặc optical flow.
Với camera đã calibration, ta đưa pixel về normalized camera coordinates:
Các cặp điểm này phải thỏa ràng buộc epipolar:
Trong đó:
- là essential matrix.
- và là tọa độ normalized của cùng một điểm trong hai frame.
- Ràng buộc này nói rằng điểm ở frame sau phải nằm trên epipolar line sinh ra bởi điểm ở frame trước và chuyển động camera.
Essential matrix có dạng:
Trong đó:
- là rotation giữa hai camera.
- là translation giữa hai camera.
- là ma trận skew-symmetric biểu diễn phép nhân chéo với vector .
Từ các match, ta ước lượng , rồi tách thành và hướng của . Đây là lõi hình học của monocular visual odometry hai frame.
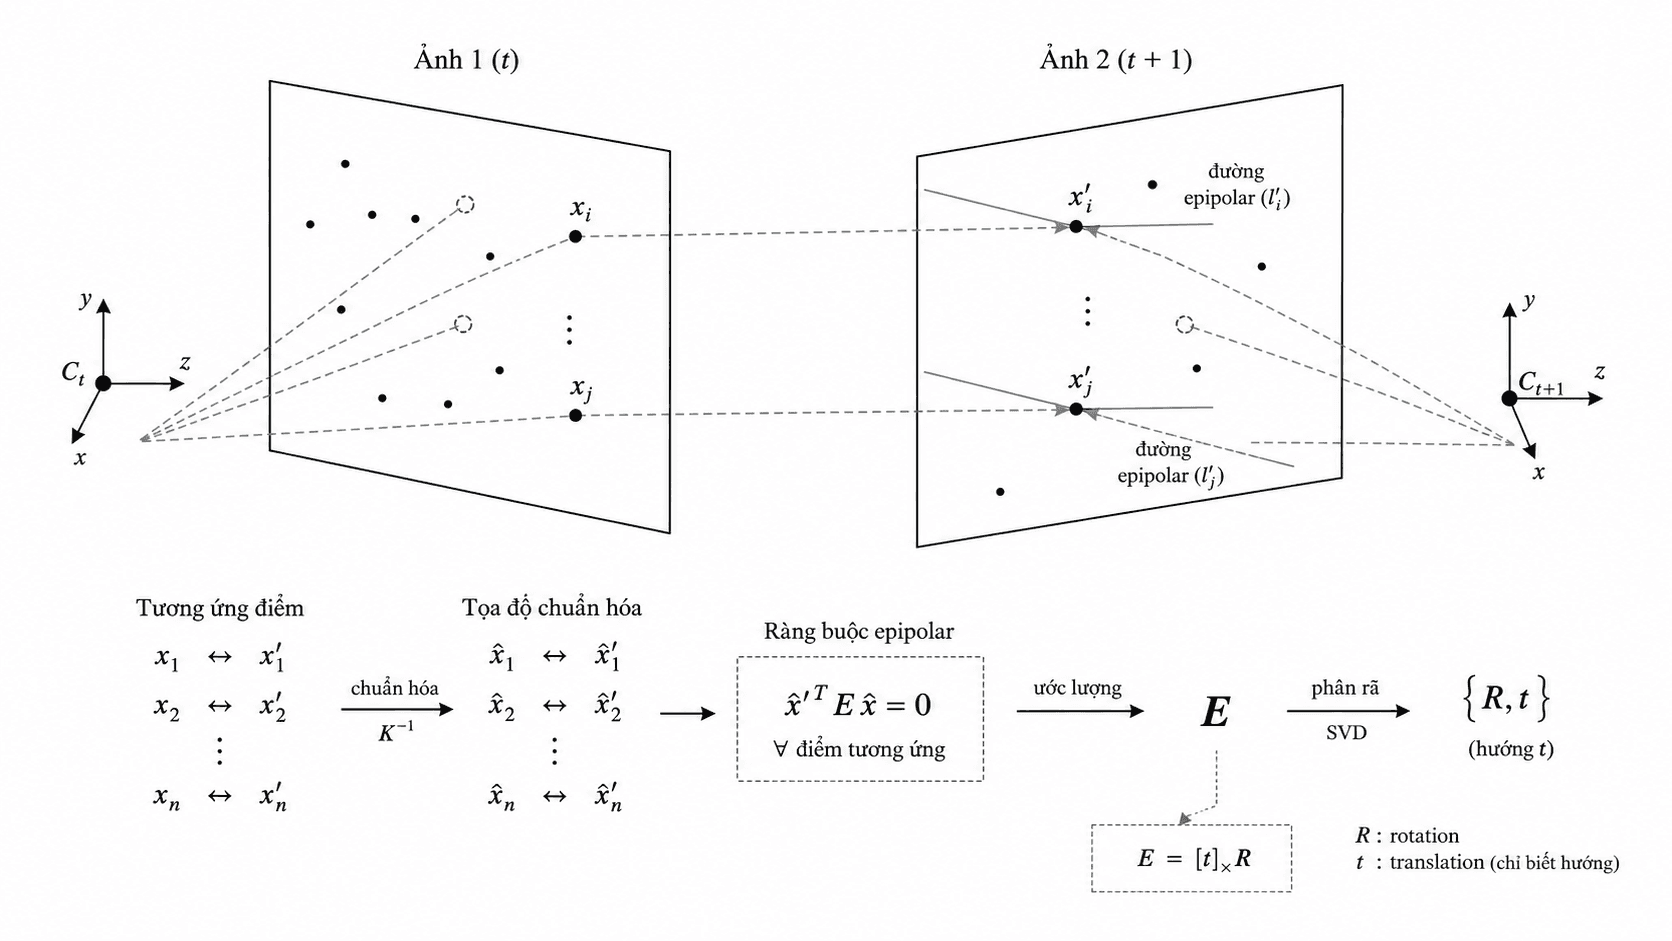
Trong thực tế, không phải match nào cũng đúng. Cảnh có nhiều cấu trúc lặp như kệ hàng, cửa, ô gạch hoặc vạch sàn rất dễ tạo match sai. Vì vậy bước ước lượng thường đi kèm RANSAC. Thay vì tin toàn bộ match, RANSAC thử nhiều tập con nhỏ, tìm mô hình hình học phù hợp với nhiều match nhất, rồi loại bớt outlier.
Vấn đề scale trong monocular visual odometry
Với một camera đơn, nếu ta phóng to toàn bộ cảnh lên gấp đôi và đồng thời phóng to translation lên gấp đôi, hình chiếu lên ảnh vẫn có thể giống nhau. Đây là lý do monocular visual odometry khó biết camera đã đi 10 cm hay 20 cm nếu chỉ nhìn hai ảnh.
Khi tách essential matrix, ta lấy được rotation và hướng translation:
Trong đó:
- là vector hướng tịnh tiến đã chuẩn hóa.
- là độ dài translation thật, tức scale.
Phần hướng của có thể ước lượng từ hình học ảnh, nhưng độ dài thật của thì không tự xuất hiện. Một hệ monocular VO cần scale từ nguồn khác: chiều cao camera so với mặt đất, stereo baseline, IMU, encoder, wheel odometry, object size biết trước, hoặc map.
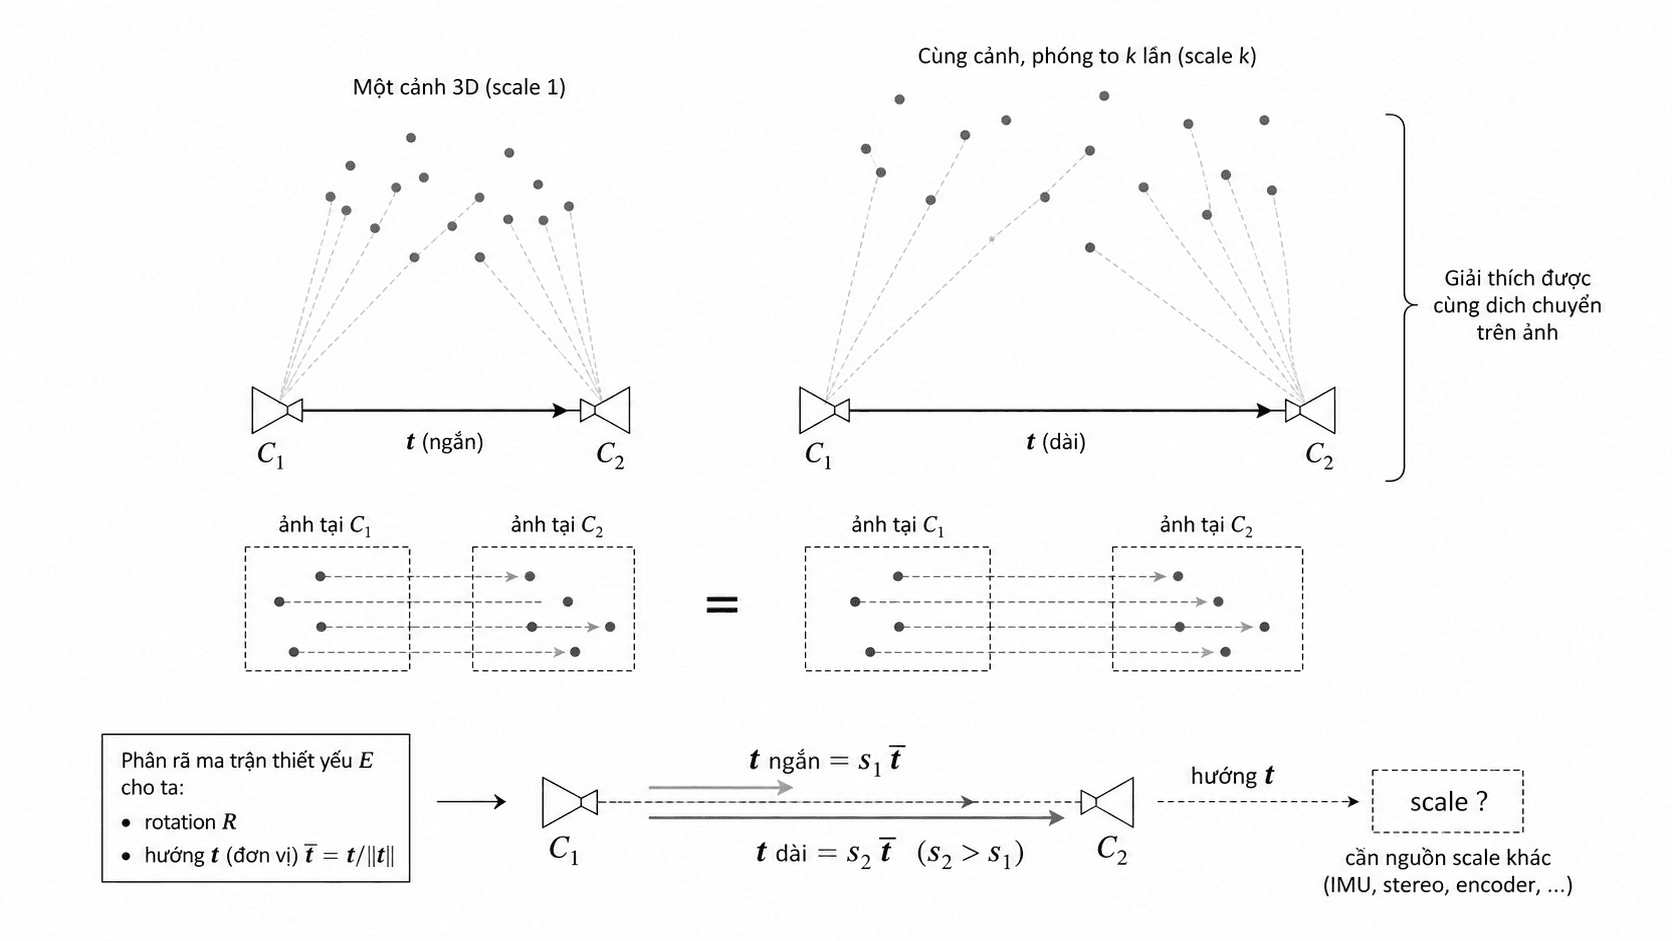
Stereo visual odometry xử lý scale dễ hơn. Hai camera có baseline cố định, nên hệ có thể suy ra độ sâu bằng disparity. RGB-D camera cũng tương tự: độ sâu được đo trực tiếp hoặc ước lượng bằng cảm biến depth. Vì vậy, khi đọc một hệ visual odometry, câu hỏi đầu tiên nên là: monocular, stereo, hay RGB-D?
Tích phân pose tương đối và sai số tích lũy quỹ đạo
Visual odometry thường trả về chuyển động tương đối giữa hai frame liên tiếp:
Trong đó:
- là rotation từ frame sang frame .
- là translation tương đối.
- là ma trận biến đổi rigid body dạng homogeneous.
Để có quỹ đạo toàn cục, ta nhân dồn các chuyển động tương đối:
Trong đó:
- là pose của camera tại thời điểm so với frame đầu.
- là chuyển động mới đo được.
- là pose cập nhật.
Đây cũng là nơi drift xuất hiện rất tự nhiên. Nếu mỗi bước chỉ sai một chút, phép nhân dồn sẽ tích lũy sai số. Đi thẳng 100 mét trong hành lang, chỉ cần góc yaw lệch rất nhỏ ở mỗi đoạn, cuối cùng quỹ đạo có thể cong rõ rệt.
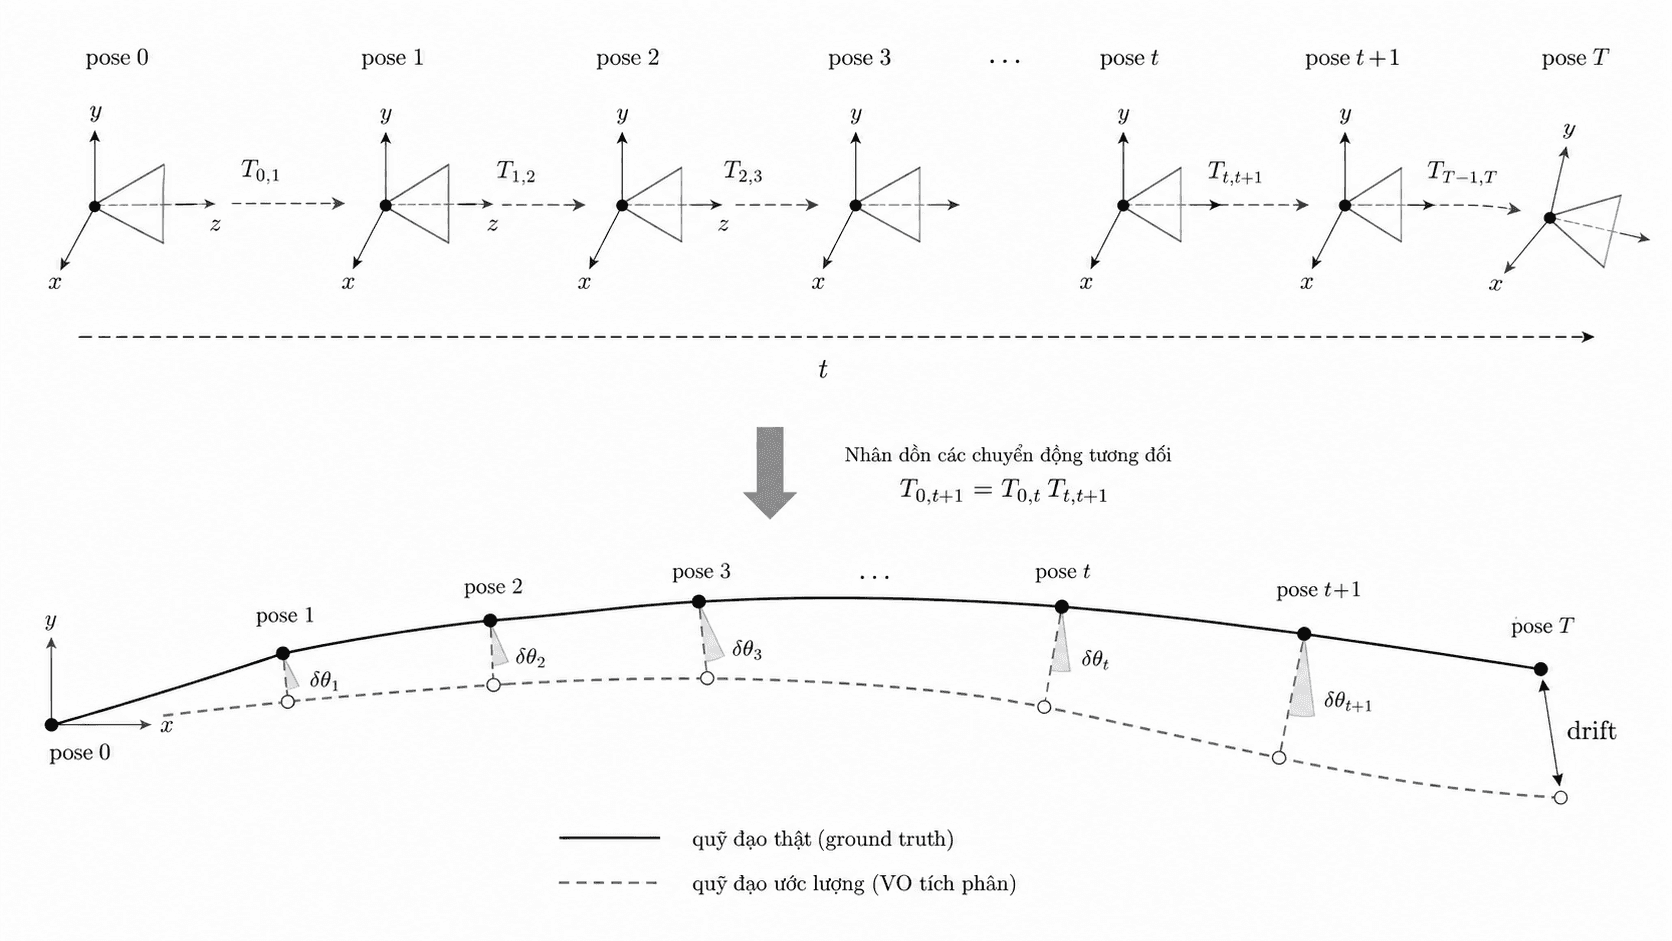
SLAM khác visual odometry ở chỗ nó cố sửa drift bằng map và loop closure. Nếu robot quay lại nơi cũ, hệ SLAM có thể nhận ra cảnh quen thuộc và kéo quỹ đạo về nhất quán hơn. Visual odometry thuần túy thường chỉ nhìn cục bộ giữa các frame gần nhau, nên drift là điều phải chấp nhận và kiểm soát.
Các điều kiện làm suy giảm độ ổn định của visual odometry
Visual odometry thích những cảnh có texture đủ tốt, ánh sáng tương đối ổn định, chuyển động giữa hai frame không quá lớn, và camera không bị blur. Nó bắt đầu khó chịu khi các điều kiện này bị phá vỡ.
Một vài tình huống rất thường gặp:
| Tình huống | Điều xảy ra |
|---|---|
| Tường trắng hoặc sàn trơn | Ít feature, match không đủ |
| Motion blur | Keypoint và optical flow kém ổn định |
| Vật thể chuyển động lớn | Match bám vào vật thể động thay vì nền tĩnh |
| Ánh sáng thay đổi mạnh | Descriptor hoặc photometric error bị lệch |
| Cảnh nhiều pattern lặp | Match sai nhưng nhìn vẫn có vẻ hợp lý |
| Camera quay quá nhanh | Overlap giữa hai frame giảm mạnh |
Một robot trong kho có thể gặp gần như tất cả tình huống này. Khi đi qua đoạn tường trắng, camera thiếu mốc. Khi cua nhanh, ảnh bị blur. Khi có người hoặc xe nâng đi ngang, feature trên vật thể động tạo chuyển động không thuộc về camera. Khi đi qua dãy kệ giống nhau, nhiều match sai vẫn trông rất thuyết phục.
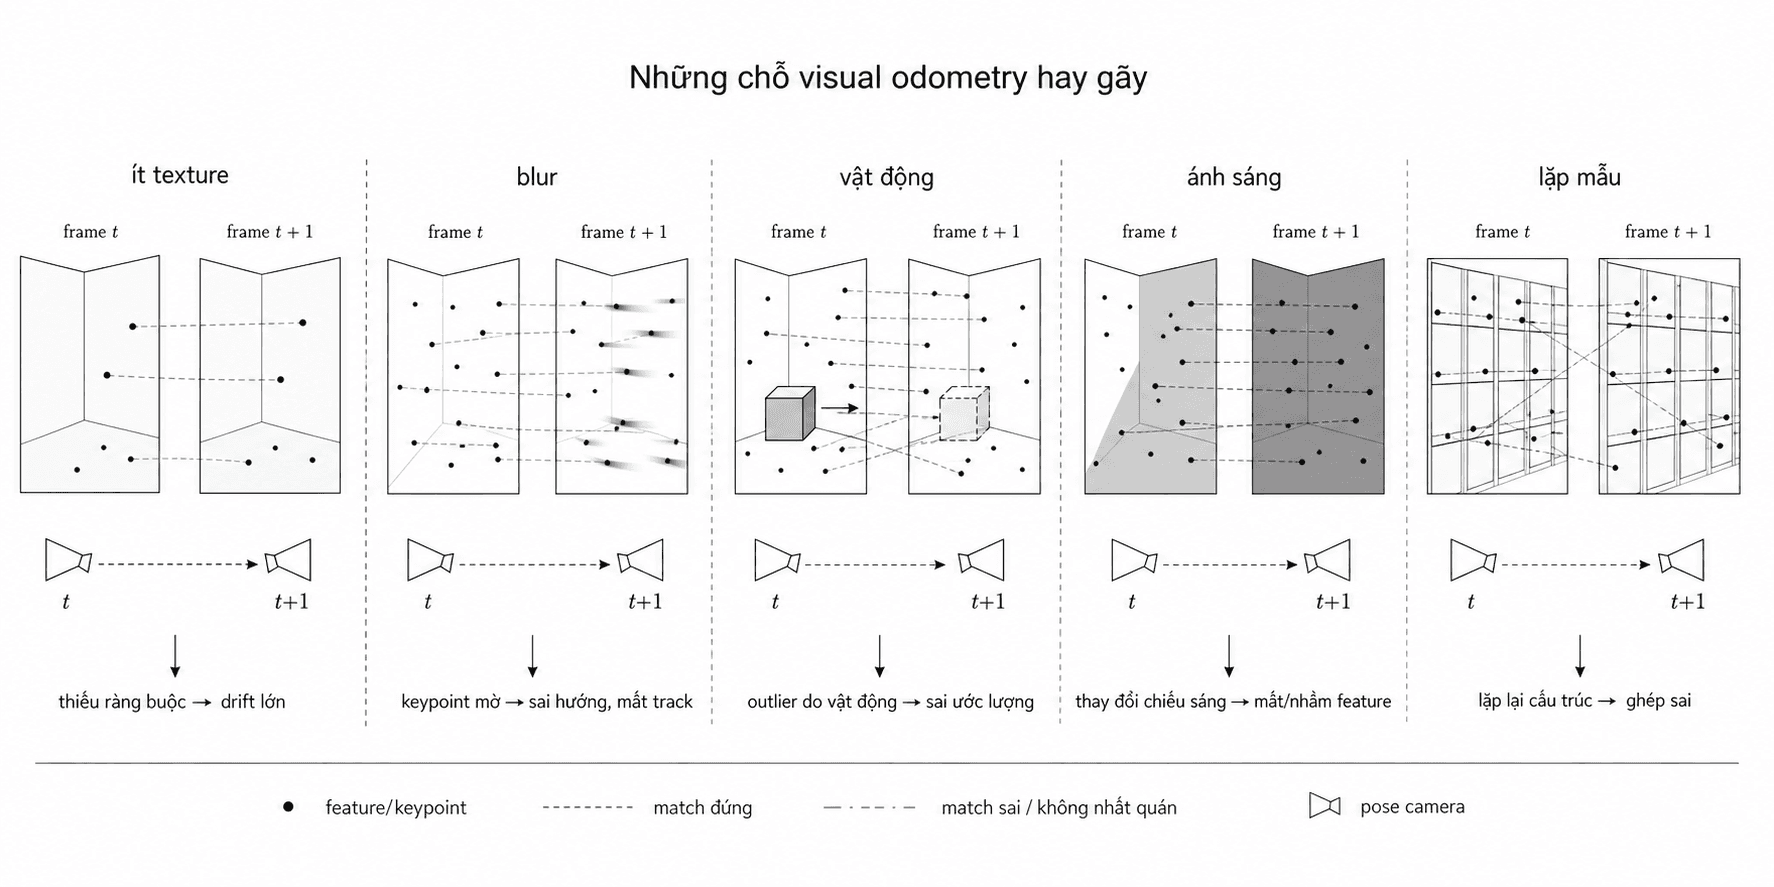
Vì vậy, debug visual odometry không nên bắt đầu bằng việc chỉnh thuật toán quá sâu. Trước hết hãy nhìn ảnh đầu vào, keypoint, match, inlier mask, tốc độ camera, exposure, rolling shutter và độ rung cơ khí. Nhiều lỗi hình học thật ra đến từ dữ liệu đầu vào xấu.
Minh họa hiện tượng drift trong tích phân chuyển động tương đối
Đoạn code dưới đây không phải visual odometry đầy đủ. Nó chỉ mô phỏng phần rất quan trọng: khi ta tích phân các chuyển động tương đối có noise, quỹ đạo sẽ trôi dần so với ground truth. Đây là điều xảy ra trong VO nếu mỗi frame ước lượng pose hơi sai.
import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(7)

steps = 120
gt = np.zeros((steps, 3))       # x, y, yaw
est = np.zeros((steps, 3))

for i in range(1, steps):
    # Robot đi gần thẳng, thỉnh thoảng cong nhẹ.
    v = 0.08
    yaw_rate = 0.008 * np.sin(i / 18)

    gt[i, 2] = gt[i - 1, 2] + yaw_rate
    gt[i, 0] = gt[i - 1, 0] + v * np.cos(gt[i, 2])
    gt[i, 1] = gt[i - 1, 1] + v * np.sin(gt[i, 2])

    # VO đo chuyển động tương đối có nhiễu nhỏ.
    noisy_v = v + rng.normal(0, 0.006)
    noisy_yaw = yaw_rate + rng.normal(0, 0.003)

    est[i, 2] = est[i - 1, 2] + noisy_yaw
    est[i, 0] = est[i - 1, 0] + noisy_v * np.cos(est[i, 2])
    est[i, 1] = est[i - 1, 1] + noisy_v * np.sin(est[i, 2])

plt.figure(figsize=(7, 4.5), dpi=180)
plt.plot(gt[:, 0], gt[:, 1], color="#111111", linewidth=2, label="ground truth")
plt.plot(est[:, 0], est[:, 1], color="#808080", linewidth=2, linestyle="--", label="VO tích phân")
plt.scatter(gt[0, 0], gt[0, 1], color="#111111", s=24)
plt.axis("equal")
plt.grid(True, color="#D9D9D9", linewidth=0.7)
plt.xlabel("x (m)")
plt.ylabel("y (m)")
plt.legend(frameon=False)
plt.tight_layout()
plt.savefig("vo_drift_demo.png")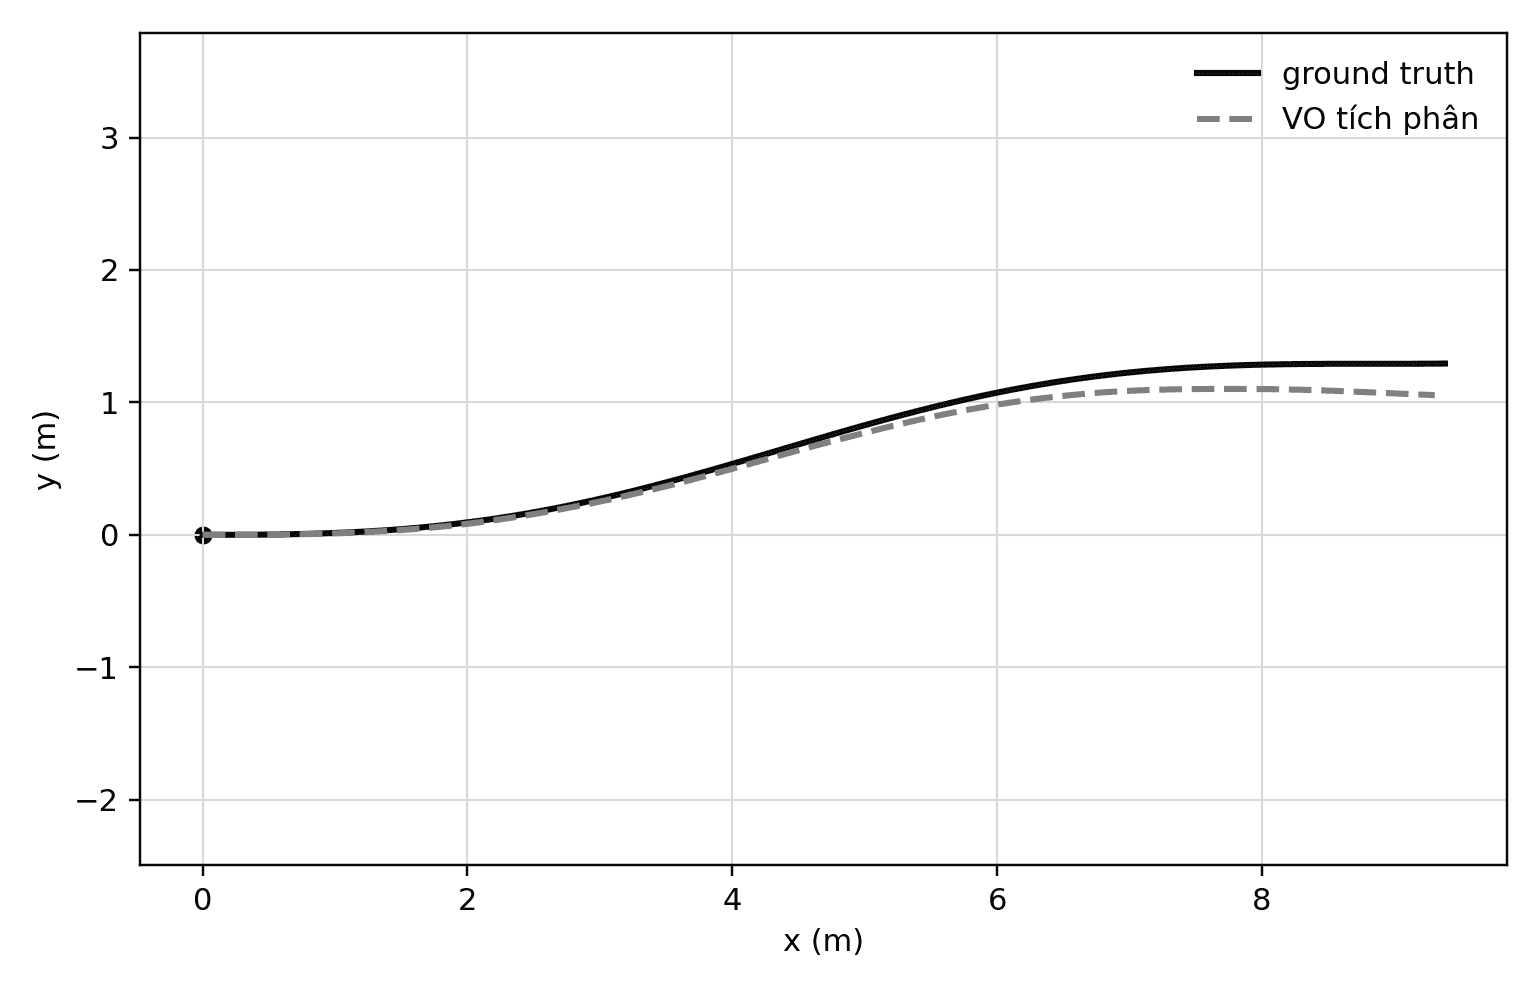
Điều đáng chú ý là noise trong ví dụ này rất nhỏ. Mỗi bước robot chỉ sai một chút về vận tốc và góc quay. Nhưng sau nhiều bước, đường ước lượng bắt đầu tách khỏi đường thật. Đây là lý do các hệ VO thực tế cần lọc outlier tốt, tối ưu nhiều frame, fuse thêm cảm biến, hoặc dùng loop closure nếu bài toán đã mở rộng thành SLAM.
Quy trình kiểm tra lỗi khi triển khai visual odometry
Nếu visual odometry chạy không ổn, hãy kiểm tra theo thứ tự gần với dữ liệu nhất.
Trước hết là ảnh: có đủ texture không, có blur không, exposure có thay đổi quá mạnh không, camera có rung không. Sau đó mới đến feature: keypoint có phủ đều ảnh không, match có tập trung vào một vùng nhỏ không, tỉ lệ inlier sau RANSAC có quá thấp không. Tiếp theo là hình học: camera intrinsic có đúng không, distortion đã được xử lý chưa, frame convention có bị đảo trục không.
Với monocular VO, đừng quên scale. Nếu quỹ đạo có hình dạng đúng nhưng độ dài sai, lỗi có thể nằm ở nguồn scale chứ không phải matching. Với stereo hoặc RGB-D, hãy kiểm tra baseline, depth range, đồng bộ thời gian và calibration giữa camera.
Visual odometry là một bài toán đẹp vì nó nằm giữa ảnh và hình học. Nó không chỉ là feature matching, cũng không chỉ là nhân ma trận pose. Nó là chuỗi các giả định nối nhau: cảnh đủ tĩnh, camera được calibration, match đủ đúng, mô hình hình học phù hợp, và sai số từng bước không vượt quá khả năng hấp thụ của hệ thống. Khi một giả định gãy, quỹ đạo sẽ nói cho ta biết, nhưng thường bằng một cách khá vòng vo.